



很多人第一次写模糊关联查询,都会直觉地把匹配条件塞进 JOIN ... ON:语法看起来顺手,结果却往往是查询卡死、超时,甚至把 LEFT JOIN 的语义都悄悄改掉。真正难的不是“能不能写出来”,而是判断哪些逻辑应该留在数据库里做预过滤,哪些该换成等值关联,哪些干脆交给应用层处理。
下面按几个最常见的场景拆开讲:先看为什么 ON 里的动态模糊匹配会让索引失效,再看模糊条件应该放到哪里,接着说明前缀匹配怎样才能真正命中索引,最后补上“最近时间匹配”这类常见需求的可执行改法。看完后,你可以更快判断一条 SQL 是只是“能跑”,还是能在生产环境里稳定跑下去。
为什么不要在 ON 里直接写 LIKE 或 REGEXP
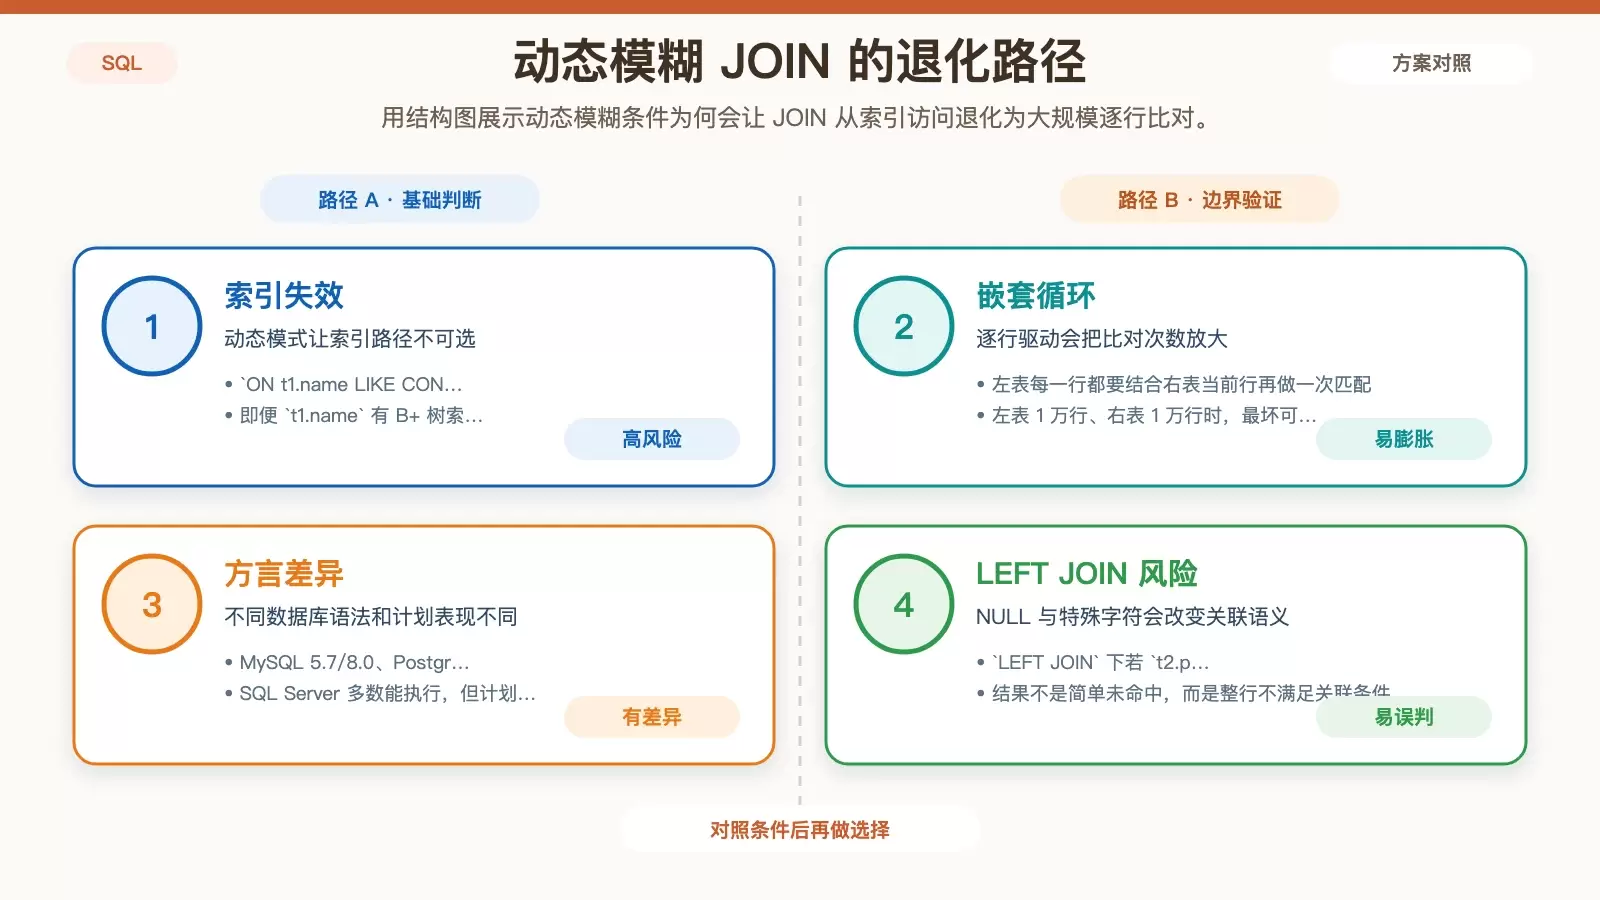
结论很直接:会崩,而且通常比预想更快。只要右表行数超过几百行,查询就可能明显变慢,甚至直接超时。
像下面这种写法最危险:
ON t1.name LIKE CONCAT('%', t2.pattern, '%')问题不在于语法本身,而在于执行方式。数据库优化器无法为这种“右表驱动的动态模式”选择稳定的索引路径,即便 t1.name 上已经有 B+ 树索引,也基本会失效。对于左表中的每一行,系统都要拿右表当前行的 pattern 去做一次匹配,最后很容易退化成嵌套循环加全表扫描。
如果左表 1 万行、右表 1 万行,最坏情况下就是 1 亿次比对。
不同数据库的表现差异
- MySQL 5.7/8.0、PostgreSQL 默认拒绝在
ON中使用列拼接的LIKE,常见报错是Unknown column;除非显式加表别名,并确认t2.pattern非NULL LEFT JOIN下更危险:如果t2.pattern为空,或包含%、_、未转义字符等异常内容,整个ON条件会求值为UNKNOWN,结果不是“没匹配上”,而是“不满足关联条件”- SQL Server 通常允许语法通过,但执行计划几乎一定会退化为嵌套循环 + 右表全扫
- Oracle 需要函数索引配合,而且只对常量模式更有机会起作用
模糊逻辑该放 WHERE、子查询,还是 JOIN 之前
如果必须做模糊匹配,优先思路不是在 JOIN 阶段硬拼,而是先把候选集缩小,再做等值关联。也就是说,模糊逻辑应尽量前置到子查询里,而不是等关联完成后再在 WHERE 里过滤。
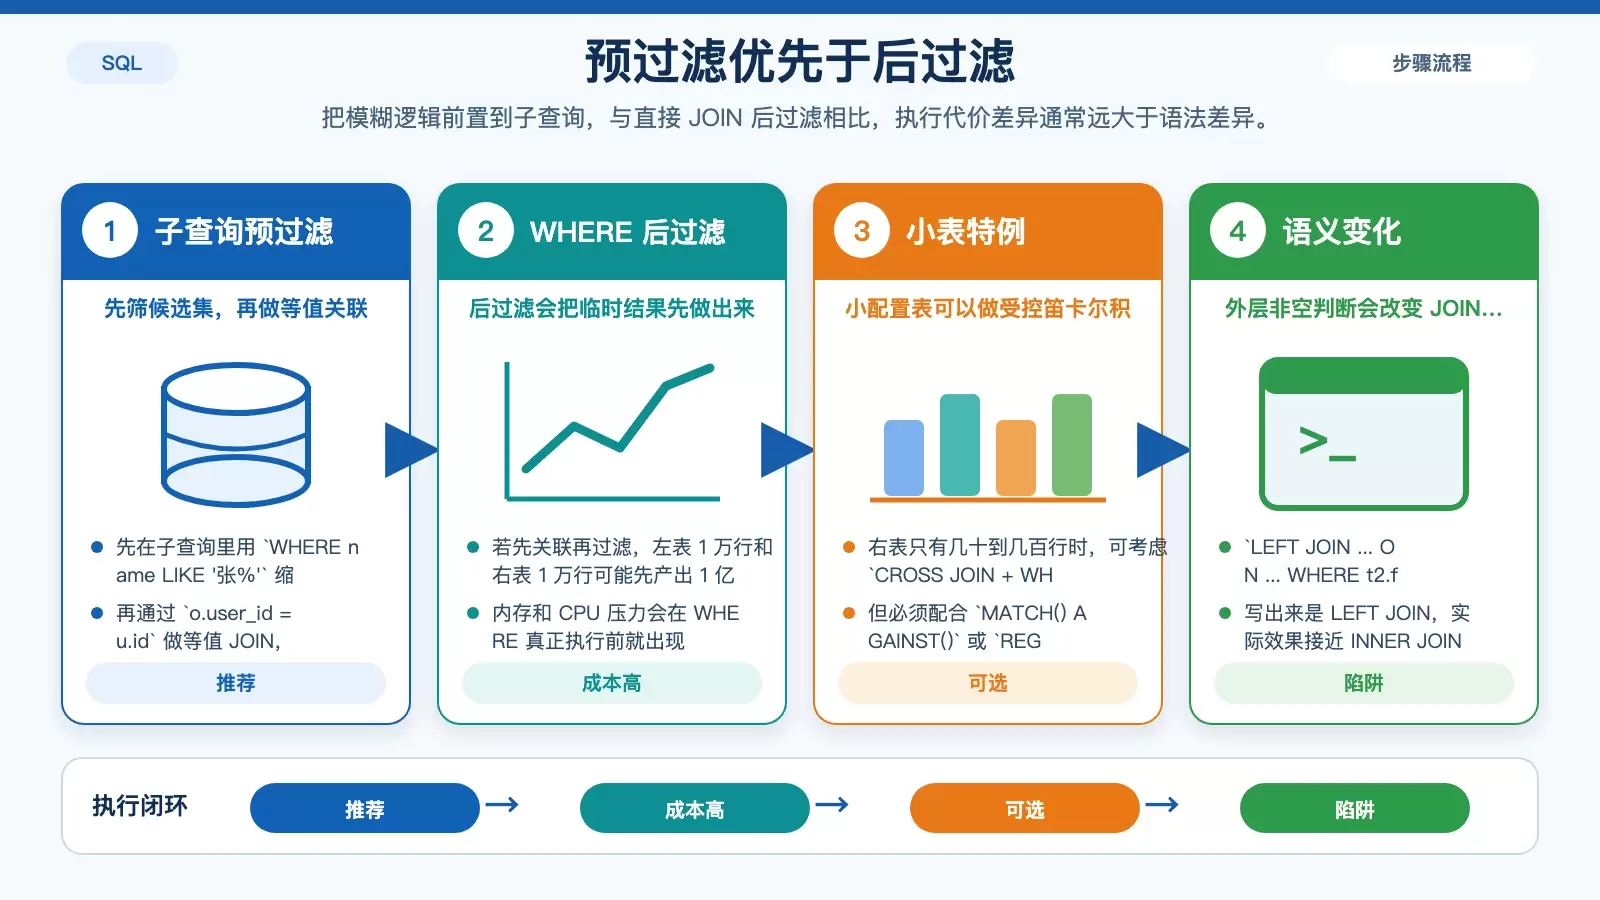
原因很简单:子查询可以提前缩小右表;而 WHERE 后过滤往往意味着先把大批中间结果做出来,再慢慢删掉。左表 1 万行、右表 1 万行时,先产出 1 亿行临时结果再筛,CPU 和内存都很难扛住。
更稳妥的改写方式
典型写法如下,先筛右表候选集,再按主键或外键做等值关联:
SELECT *
FROM orders o
JOIN (
  SELECT id, name
  FROM users
  WHERE name LIKE '张%'
) u ON o.user_id = u.id
这样做的关键收益在于:模糊过滤发生在单表阶段,等进入 JOIN 时,右表已经被压缩成一小批候选数据。
右表很小时可以怎么处理
如果右表只是一个小配置表,规模在几十到几百行,可以考虑 CROSS JOIN + WHERE 的方式做拼接筛选,但前提是必须有足够强的过滤条件。
例如要配合 MATCH() AGAINST() 或 REGEXP 的阈值过滤,像 > 0.1 这样的限制不能省。否则笛卡尔积会直接膨胀,查询结果还没进入后续过滤就已经把资源吃满。
一个常见陷阱:LEFT JOIN 被写成了 INNER JOIN
下面这种写法很常见,但语义上有坑:
LEFT JOIN ... ON ...
WHERE t2.field IS NOT NULL
一旦在外层 WHERE 里要求 t2.field IS NOT NULL,那些原本应该被 LEFT JOIN 保留下来的“左表无匹配记录”就会被过滤掉,最终效果等同于事实上的 INNER JOIN。
前缀匹配怎样才能真正用上索引
很多人知道 LIKE 'abc%' 可能走索引,但真正决定能否命中的,不只是写法,还包括索引是否存在,以及这个前缀对优化器来说是不是“固定的”。
在普通 B-Tree 索引下,通常只有 LIKE '固定前缀%' 才能利用索引;'%abc' 和 '%abc%' 基本不行。
普通索引的基本用法
先为字段建立索引:
CREATE INDEX idx_users_name ON users(name)查询时要使用明确的字面量前缀,例如:
WHERE name LIKE '王%'
-- 或
WHERE name REGEXP '^王'
而下面这种形式通常不能达到同样效果:
WHERE name LIKE CONCAT(@prefix, '%')原因在于用户变量在预编译阶段不可知,优化器无法像面对固定前缀那样提前选择索引路径。
MySQL 8.0+ 与 PostgreSQL 的可选方案
MySQL 8.0+ 支持函数索引,例如:
CREATE INDEX idx_name_lower ON users((LOWER(name)))对应查询可以写成:
WHERE LOWER(name) LIKE 'zhang%'但要注意,函数索引同样无法加速 LIKE '%zhang%'。
PostgreSQL 则可以借助 pg_trgm + GIN 索引来加速:
ILIKE '%abc%'不过这个能力主要适用于单表扫描,不适合把右侧字段直接塞进 ON 条件里做动态模糊关联。
时间戳最近匹配,为什么不能在 ON 里直接算差值
“找时间最接近的一条记录”是另一类高频需求,但很多人会直接在 ON 里写:
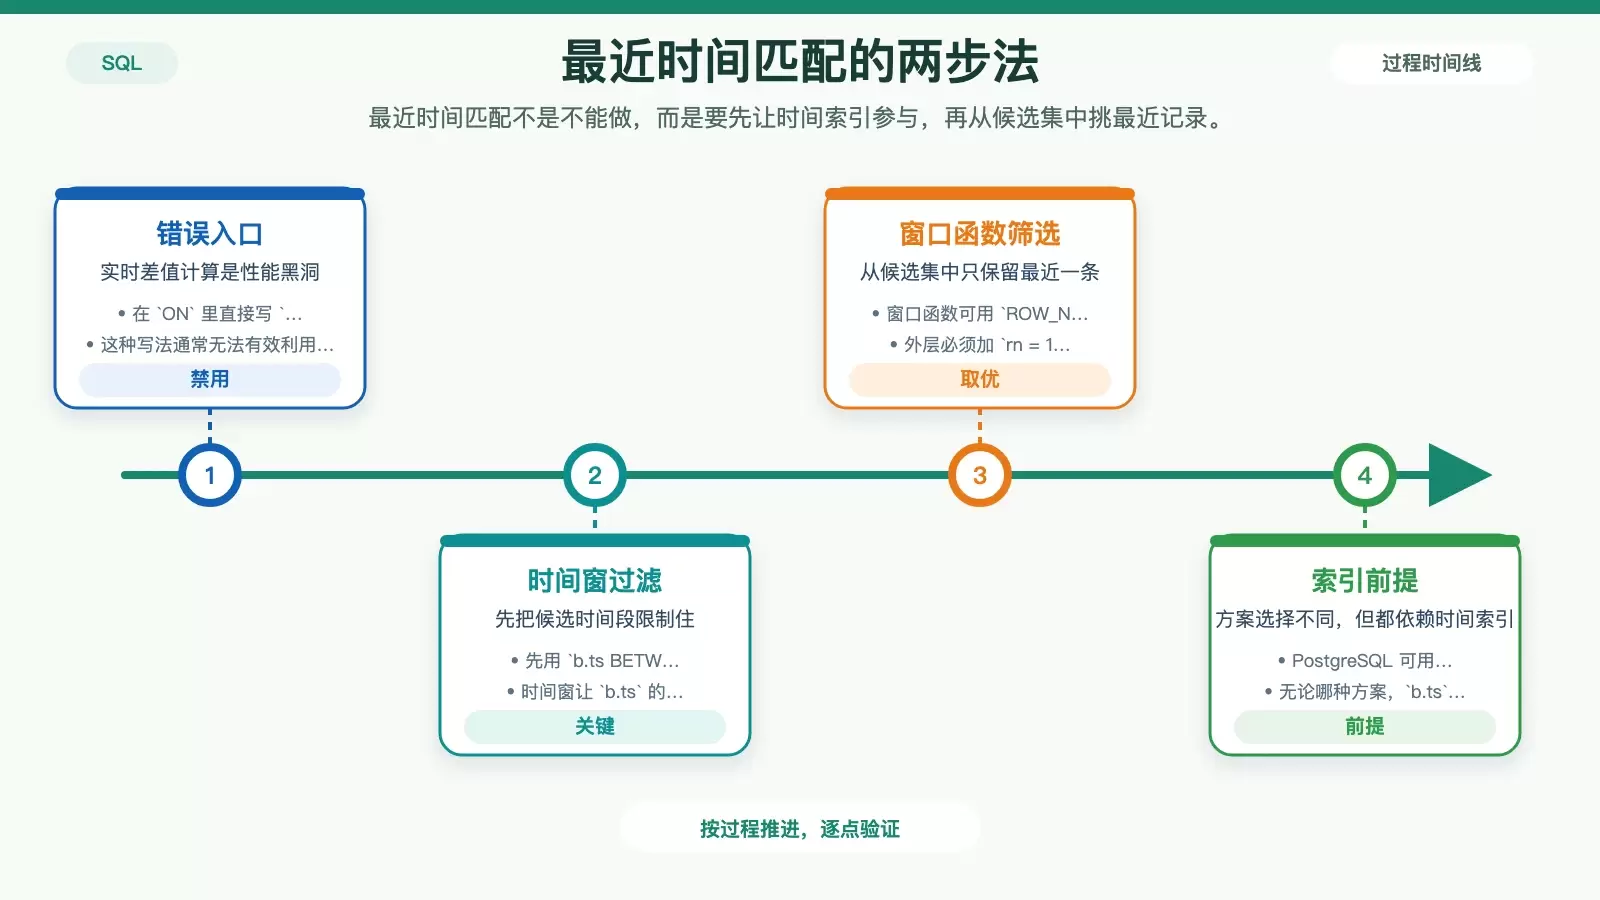
ABS(TIMESTAMPDIFF(...))这基本就是性能黑洞。因为数据库必须为每一对候选组合实时计算差值,ts 字段上的索引也很难真正派上用场。
第一步先做时间窗预过滤
更合理的方式,是先用时间范围把候选行限制住:
ON b.ts BETWEEN DATE_SUB(a.ts, INTERVAL 10 MINUTE)
            AND DATE_ADD(a.ts, INTERVAL 10 MINUTE)
这样至少能让 b.ts 上的索引有机会命中,把全表扫描收缩成较小范围扫描。
第二步再从候选集中取最近一条
时间窗过滤之后,再用窗口函数计算“谁最近”:
ROW_NUMBER() OVER (
  PARTITION BY a.id
  ORDER BY ABS(TIMESTAMPDIFF(SECOND, a.ts, b.ts))
)
最后在外层加上 rn = 1,只保留每组最接近的一条记录。
如果是 PostgreSQL,也可以直接使用:
LATERAL + ORDER BY b.ts <-> a.ts LIMIT 1这种方式通常比窗口函数更省内存,也更容易让索引下推生效。
前提条件只有一个:ts 必须有索引
不管是时间窗预过滤、窗口函数,还是 PostgreSQL 的 LATERAL 方案,都依赖 b.ts 上存在 B-tree 索引。没有索引的话,所谓“先缩小范围”只会停留在写法层面,执行层面仍然可能很慢。
什么时候应该把模糊匹配交给应用层
实际项目里,最难的往往不是 SQL 语法,而是边界判断:这部分逻辑到底适不适合继续留在数据库里。
比如面对 10 万行用户表和 50 行品牌词表,与其在 SQL 中强行用 JOIN 做模糊关联,不如先把品牌词提取到 Python,再用 str.contains() 批量筛选。数据规模合适时,这种做法反而更快、更稳,也更容易调试。
可以把判断思路总结为三条:
- 能先缩小候选集,就不要在
JOIN ... ON里直接做动态模糊匹配 - 能用等值关联收尾,就不要让模糊逻辑贯穿整个关联阶段
- 如果右表是小词表、规则表,而左表数据量又很大,可以认真评估是否改为应用层批处理















