



很多 JOIN 慢查询并不是“数据库太忙”,而是执行计划里早就写明了问题出在哪一层,只是没有按优先级去看。判断 JOIN 是否值得立刻优化,最实用的方法不是逐项通读整份 EXPLAIN,而是先抓住 type、key、rows 和 Extra 这几组核心信号,再结合数据库类型判断是补索引、修条件,还是更新统计信息。
先看 type:有没有扫全表
执行计划里,type 往往是判断 JOIN 是否健康的第一眼指标。只要看到 ALL 或 index,就应该先停下来确认是不是没有真正用上索引。
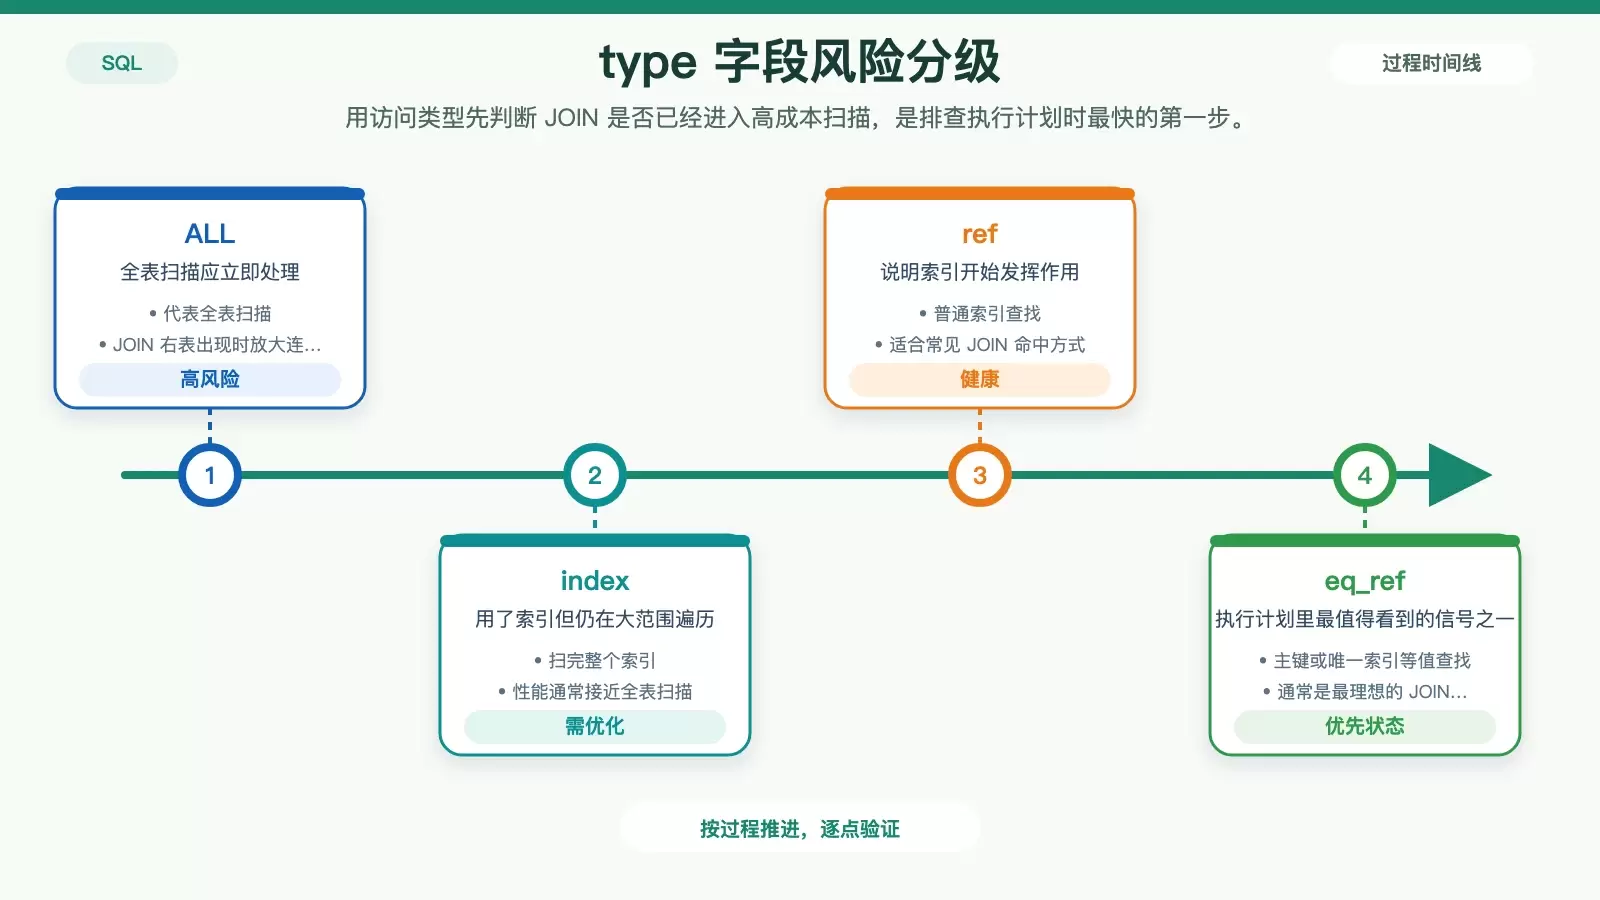
ALL 代表全表扫描,index 代表扫完整个索引。后者虽然“用了索引”,但本质上仍然是在大范围遍历,性能通常和全表扫描接近。尤其当 JOIN 右表出现 ALL 时,基本意味着左表每匹配一次,右表都要重新遍历,数据量一旦超过十万,卡顿就会很明显。
哪些 type 才算相对健康
JOIN 场景里,更值得看到的是下面几种类型:
eq_ref:主键或唯一索引的等值查找ref:普通索引查找range:范围扫描
如果左表是 ref,右表却是 ALL,那基本可以直接怀疑右表 JOIN 字段没有合适索引。
不同数据库里怎么理解这个信号
- MySQL 中右表出现
type=ALL:优先考虑在右表 JOIN 字段上补CREATE INDEX - PostgreSQL / SQL Server 中看到
Seq Scan:这不是“可能慢”,而是已经进入必须干预的状态 - 出现
type=index:说明优化器虽然走了索引结构,但仍在扫完整个索引,也需要继续优化
再看 key 和 possible_keys:索引为什么没选上
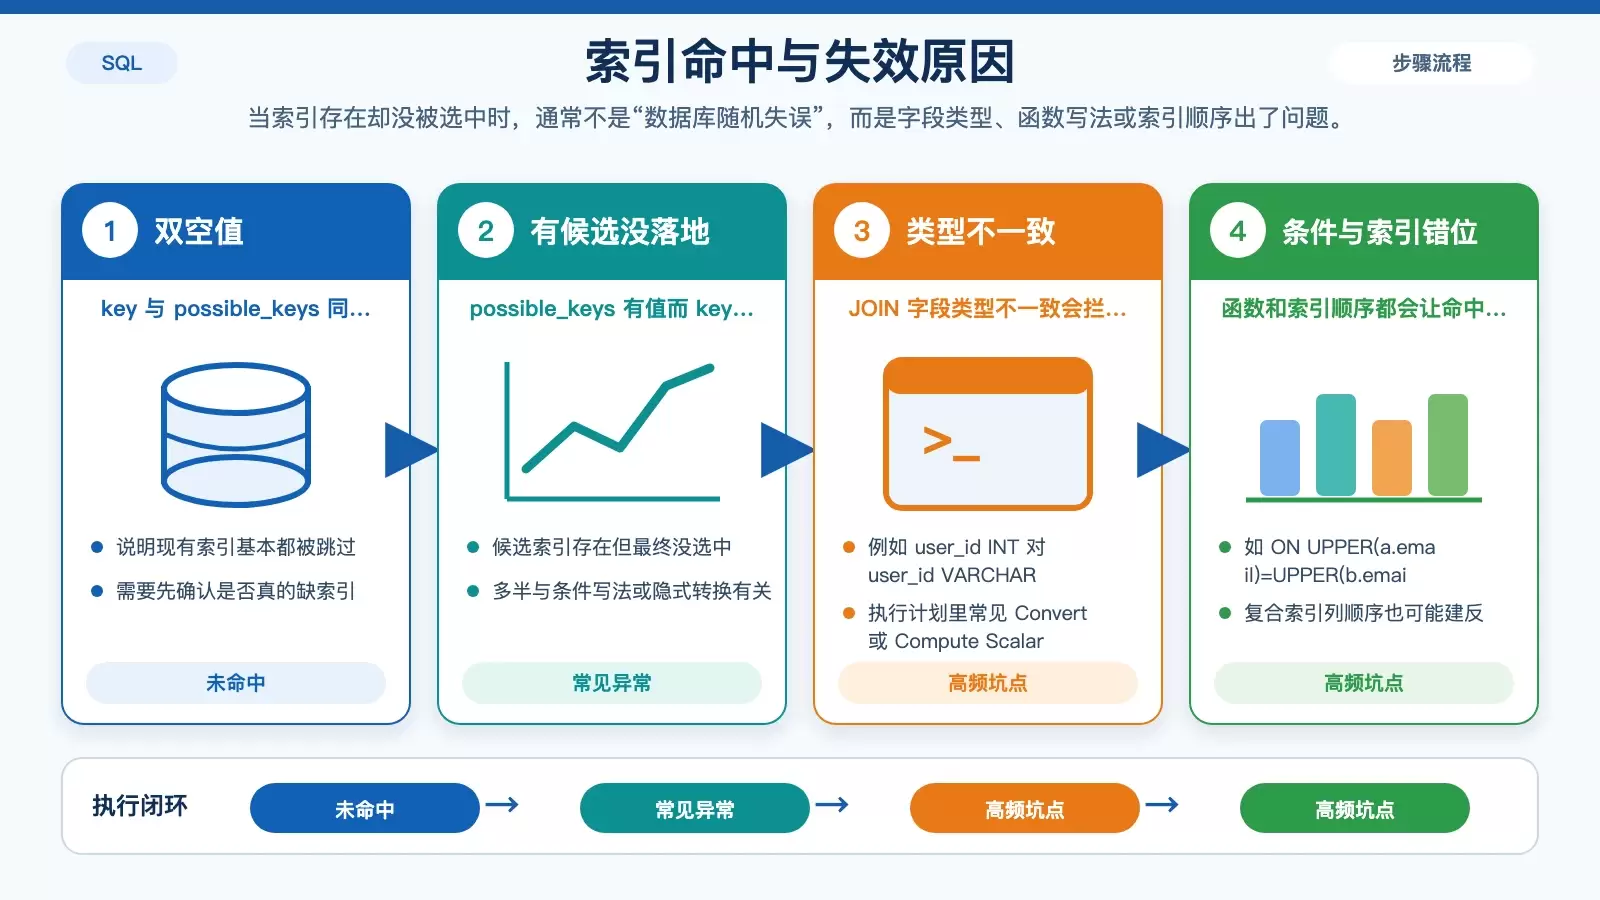
possible_keys 表示优化器认为“理论上可用”的索引,key 表示最终真正选中的索引。两者一起看,才能判断问题是“没索引”还是“有索引但没用上”。
几种常见组合的含义
key和possible_keys都是NULL:说明现有索引基本都被跳过了possible_keys有值,但key为空:通常是条件写法、类型不一致或隐式转换让索引失效key有值但possible_keys为空:可能是统计信息过期,或者执行计划显示方式受隐式转换影响,需要继续核查
最容易踩坑的三类情况
- JOIN 字段类型不一致:例如左表
user_id INT,右表user_id VARCHAR(32),执行计划里常会出现Convert或Compute Scalar节点 - 在
ON条件里包函数:例如ON UPPER(a.email) = UPPER(b.email),索引通常会直接失效 - 复合索引顺序错位:例如
ON t1.a = t2.x WHERE t2.status = 'done',却建成了(status, x),而不是更匹配连接条件的(x, status)
rows 和 filtered:判断扫描量是不是失控
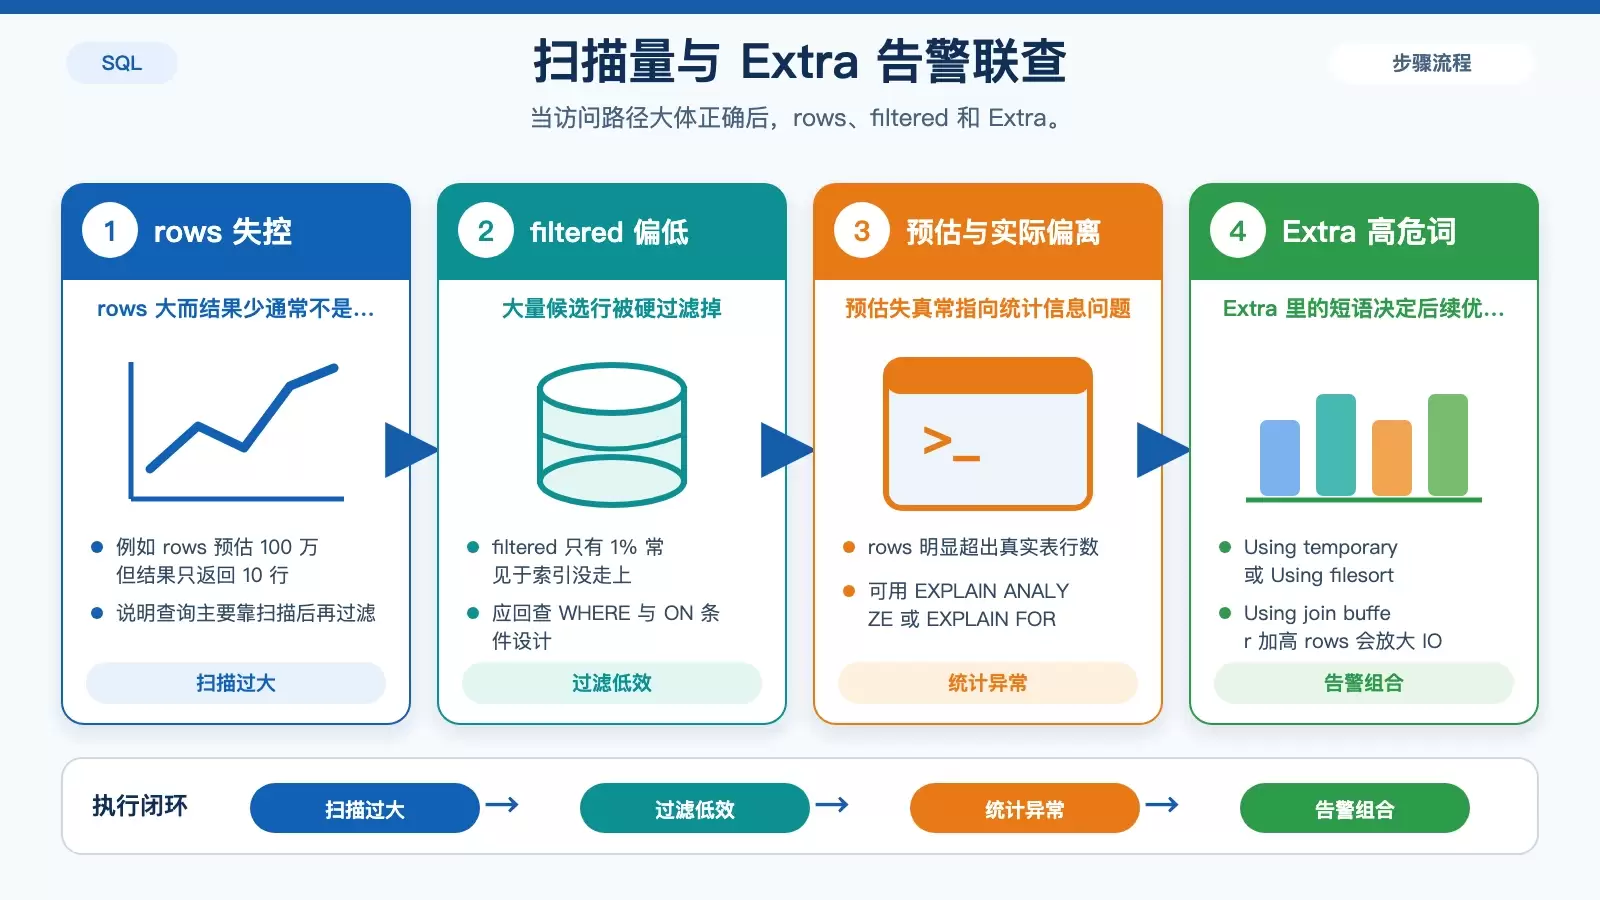
rows 表示优化器预估要检查多少行,filtered 表示这些行里预计有多少比例能通过过滤条件。它们不是最终结果数,而是优化器对执行成本的判断依据。
如果 rows 是 100 万,但最终只返回 10 行,同时 filtered 只有 1%,通常说明查询主要靠“先扫出来,再硬过滤”,而不是通过索引把候选范围提前缩小。遇到这种情况,重点要回头检查 WHERE、ON 以及复合索引设计。
什么时候要怀疑统计信息不准
更危险的一类情况,是 rows 明显高于表的实际行数,或者与真实数据分布严重不符。这通常意味着两件事之一:
- 统计信息已经过期
- 优化器错误判断了连接顺序或过滤选择性
这时只看普通 EXPLAIN 往往不够,需要看更接近真实执行的数据:
- PostgreSQL:用
EXPLAIN ANALYZE - MySQL 8.0+:用
EXPLAIN FORMAT=JSON
这类命令会给出更接近真实扫描过程的反馈,比单纯预估值更适合定位 JOIN 的成本异常。
不同数据库更新统计信息的方法
- MySQL:使用
ANALYZE TABLE,不要完全依赖自动更新 - PostgreSQL:使用
VACUUM ANALYZE,尤其在大批量写入后 - SQL Server:查看
DBCC SHOW_STATISTICS,确认Rows Sampled不是 0
最后看 Extra:定位排序、回表和连接退化
Extra 往往藏着最具体的性能线索。它不像 type 那样直接定义访问方式,但很适合判断查询是不是在排序、临时表或连接阶段发生了退化。
几个最值得警惕的提示
Using join buffer:说明执行阶段无法高效使用索引连接,可能退化为 BNL(Block Nested Loop,块嵌套循环),IO 压力会明显上升Using temporary:说明中间结果需要落到临时结构,常见于GROUP BY或复杂聚合Using filesort:说明排序无法直接利用索引顺序Using where; Using index:这是更理想的状态,表示主要在索引层完成读取和过滤,通常无需回表
两个高危组合要优先处理
Using temporary; Using filesort+ 大表 JOIN:很可能是SELECT *、排序字段未建索引,或覆盖索引不完整Using join buffer+ 高rows:说明连接阶段已经出现高成本退化,内存和 IO 压力都会迅速放大
排查顺序别反:先让 type 正常,再压 rows,最后清理 Extra
看 JOIN 执行计划时,最常见的误区是先盯着某个细节优化,比如排序、回表或字段裁剪,却忽略了前面访问路径本身就不对。更实用的顺序应该是:
- 先确认
type是否正常,避免ALL、index或Seq Scan - 再检查
key和possible_keys,确认索引是否真正命中 - 然后看
rows、filtered,判断扫描量和过滤效率是否失控 - 最后根据
Extra处理临时表、排序、连接退化等附加问题
也就是说,Extra 里的告警词不是调优的起点,真正的起点仍然是访问路径和索引选择。前一层没修正,后一层通常只能做表面优化。















