



很多人第一次在子查询里写 ORDER BY,都是从一条报错开始的:明明只是想“先排个序再往外查”,数据库却不认。问题的关键在于,子查询返回的是供上层继续处理的中间结果集,标准 SQL 并不把它当作天然有序的数据流。
这篇文章不只解释“为什么不能写”,还会把几个最容易踩坑的场景拆开说清:什么时候内层 ORDER BY 会报错,什么时候它只是为 LIMIT、TOP、FETCH 服务,以及聚合查询、窗口函数里该把排序放在哪一层,才能既合法又符合执行语义。
为什么子查询里的 ORDER BY 会报错
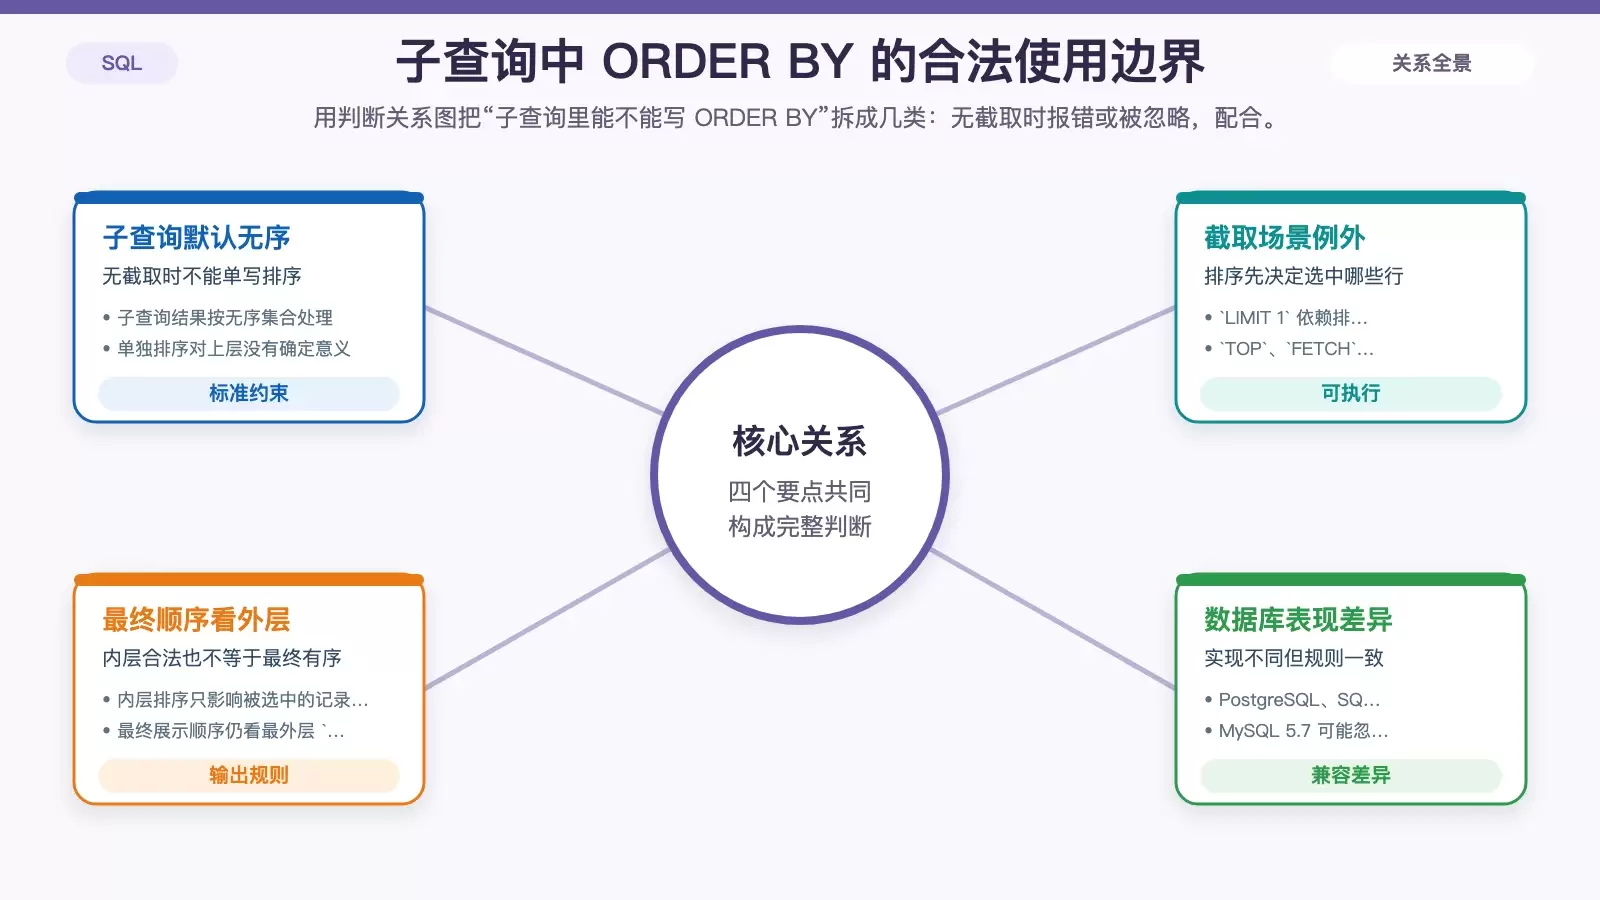
SQL 标准规定,子查询通常不能单独包含 ORDER BY。原因并不是数据库“挑剔”,而是标准把表和子查询结果都视为无序集合,子查询只负责提供中间数据,排序如果不会影响取值范围,对上层就没有确定意义。
也正因如此,优化器通常会直接丢弃这种无意义的排序,或者在语法阶段就拒绝执行。不同数据库表现略有区别,但本质遵循的是同一条规则:
- PostgreSQL 会报错:
ERROR: ORDER BY in subquery is not allowed unless it is accompanied by LIMIT or OFFSET - SQL Server 会报错:
The ORDER BY clause is invalid in views, inline functions, derived tables, subqueries - MySQL 5.7 可能静默忽略,MySQL 8.0+ 默认也会报错
因此,看到这类错误时,不要先怀疑数据库实现有问题,更准确的判断是:这条 ORDER BY 没有承担“决定取哪些行”的职责,所以不该出现在子查询这一层。
哪些场景允许内层 ORDER BY
子查询并非永远不能出现 ORDER BY。只要它和 LIMIT、TOP、FETCH 这类“截取结果”的语义绑定在一起,排序就是合法且必要的,因为它决定了最终被选中的行。
内层排序的作用是决定“选中谁”
这时的 ORDER BY 不是为了让结果集最终按某种顺序展示,而是为了确定要截取哪几行。例如:
SELECT * FROM (SELECT id FROM t ORDER BY created_at DESC LIMIT 1) s这里的 ORDER BY created_at DESC 用来决定哪一条记录是“最新”的,然后 LIMIT 1 再把它取出来。
其他常见写法也一样:
SELECT TOP 5 * FROM (SELECT * FROM logs ORDER BY time DESC) t:在 SQL Server 语义里,排序决定TOP 5取哪 5 条SELECT * FROM t ORDER BY id OFFSET 0 ROWS FETCH FIRST 10 ROWS ONLY:FETCH依赖前置排序来确定前 10 行是谁
真正控制最终输出顺序的仍然是外层 ORDER BY
即便内层排序合法,它影响的也只是截取范围,不等于整个查询结果就按这个顺序输出。只要该派生表继续参与 JOIN、被外层再次筛选,或者作为 IN 子查询使用,最终展示顺序仍由最外层的 ORDER BY 决定。
换句话说,可以把判断标准记成一句话:内层 ORDER BY 用来决定“取哪几行”,外层 ORDER BY 才用来决定“最后怎么排”。
按聚合结果排序,应该怎么拆分查询
实际开发里,另一个高频错误是把聚合和排序都塞进子查询,尤其是带 GROUP BY 的场景。看起来像是“先统计、再排一下”,但如果排序本身不用于截取,就会触发和前面一样的问题。
典型错误写法如下:
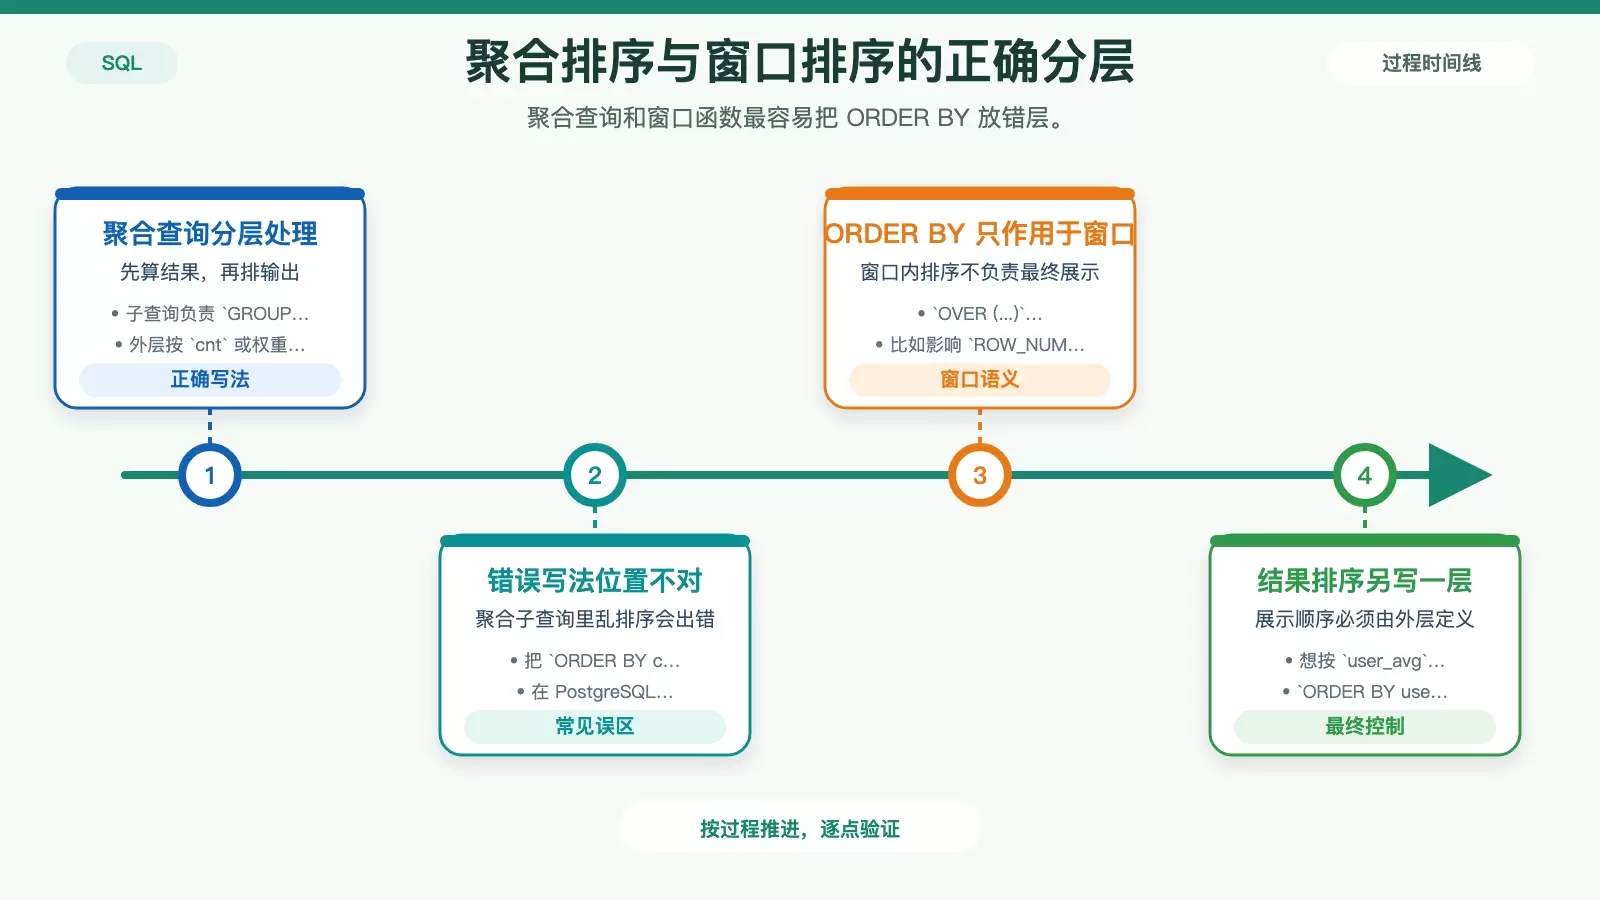
SELECT * FROM (SELECT user_id, COUNT(*) c FROM orders GROUP BY user_id ORDER BY c DESC) t这在 PostgreSQL 和 MySQL 8.0+ 中通常会直接报语法错误。
正确写法:子查询只算值,外层负责排序
更稳妥的方式是把职责拆开:
- 子查询只做聚合计算
- 外层基于聚合结果排序
例如:
SELECT user_id, COUNT(*) AS cnt FROM orders GROUP BY user_id然后在外层排序:
SELECT * FROM (...) t ORDER BY t.cnt DESC如果排序条件更复杂,比如动态权重由“订单数 × 0.4 + 平均金额 × 0.5”组成,也建议放在外层 ORDER BY 中组合。这样做有两个直接好处:
- 避免在子查询中加入无效排序,减少语法兼容问题
- 避免在
ORDER BY中重复写COUNT(*)、AVG(price)之类聚合表达式,降低重复计算和兼容性风险
因此,遇到“先聚合再排序”的需求时,优先按“计算层”和“展示层”拆分查询,通常最清晰也最稳定。
窗口函数里的 ORDER BY 为什么最容易误判
窗口函数会让很多人对 ORDER BY 的作用位置产生混淆,因为它既可以出现在查询最外层,也可以写在 OVER 子句内部,但这两处排序并不是一回事。
例如下面的写法:
ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY updated_at DESC)这里的 ORDER BY updated_at DESC 只影响窗口函数内部的计算顺序,也就是决定每个 user_id 分区里谁的行号更靠前。它不会自动让最终返回结果按 updated_at DESC 输出。
窗口内排序负责计算,结果排序仍看外层
如果你的目标是“先算出每个用户的统计值,再让整张结果表按这个统计值降序展示”,正确思路仍然是分层处理:
- 先用窗口函数产出用于排序的列,例如:
AVG(amount) OVER (PARTITION BY user_id) AS user_avg - 再在外层写:
ORDER BY user_avg DESC
这类问题最容易误导人的地方在于:你看到了窗口函数里的 ORDER BY,就下意识认为结果已经排好序了。实际上,它只服务于窗口计算逻辑,不负责最终结果集的显示顺序。
实战里可以直接套用的判断规则
如果你不想每次都从语法细节重新推理,可以直接用下面这套判断方法:
- 子查询里的
ORDER BY如果不配合LIMIT、TOP、FETCH,通常就不该写 - 需要控制“取哪几行”时,排序可以放在内层
- 需要控制“最终输出顺序”时,排序必须放在最外层
- 带
GROUP BY的统计查询,先在子查询里算结果,再在外层排序 - 窗口函数
OVER (... ORDER BY ...)只影响窗口计算,不等于最终结果有序
把这几条分清之后,子查询、聚合和窗口函数中的 ORDER BY 基本就不会再混用了。















