



很多人排查“小数插入数据库后丢精度”时,第一反应是怀疑数据写坏了,但大多数情况下,问题出在类型映射、驱动处理或隐式转换上:某一层把原本应按定点小数处理的值,当成了整数或浮点数。判断这类问题,关键不是只看表字段,而是把“字段定义、SQL 写法、驱动绑定、应用层类型”连起来看。
下面按最常见的四类场景展开:SQL Server 的 money 与 JDBC、MySQL 存储过程中的 DECIMAL 推导、MyBatis 批量插入的统一 scale 截断,以及 PostgreSQL / Oracle 中误用浮点类型。每一节都给出可直接检查和修正的做法,便于你快速定位到底是哪一层在悄悄丢小数位。
为什么会出现小数精度丢失
这类问题的根本原因通常是精度丢失,而不是数据本身被“破坏”。常见触发点有三个:
- 数据库字段类型和业务值不匹配,例如把金额放进浮点或特殊类型中;
- JDBC 或 ORM 没有把
scale正确传给数据库; - SQL 中使用裸数字,触发了隐式类型推导,导致中间结果按整数或浮点处理。
因此,遇到 35.35 变成 35、99.99 变成 99、或者 0.1 + 0.2 变成 0.30000000000000004 时,优先排查“谁在处理中改了类型”,而不是先怀疑存储层损坏。
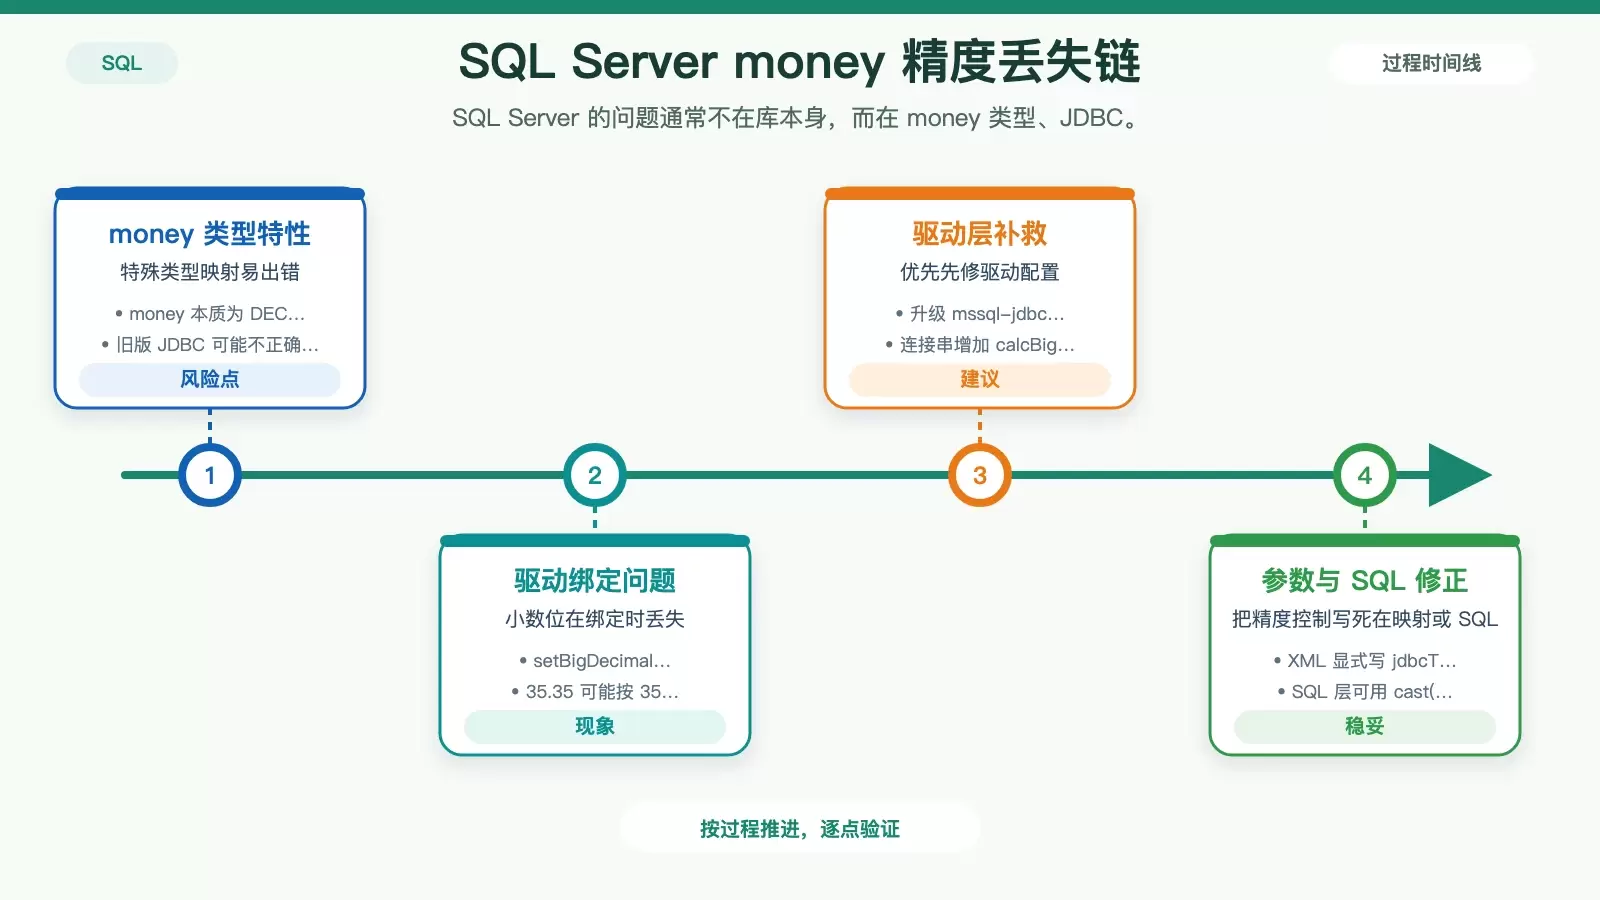
SQL Server 中 money 字段为什么会丢小数位
SQL Server 的 money 类型比较特殊,它本质上是固定的 DECIMAL(19,4)。问题在于,JDBC 驱动,尤其是旧版本驱动,并不总能正确处理这个类型。当应用层使用 setBigDecimal 传值时,驱动可能直接忽略 scale,于是 BigDecimal(35.35, scale=2) 最终按 35 入库。
问题是怎么发生的
如果你表面上看到字段能存小数,但应用插入后总少掉小数位,原因往往不在 SQL Server 本身,而在 Java 应用到数据库之间这一段绑定过程。也就是说,数据库能存,驱动却没按应有的精度送进去。
可用修正方式
- 临时解法:改用标准
DECIMAL(p,s)字段,比如DECIMAL(18,2); - 驱动层补救:升级
mssql-jdbc到9.4+,并在连接串中加入calcBigDecimalPrecision=true; - MyBatis 显式声明:在 XML 中给参数加
jdbcType=DECIMAL和numericScale=2,例如#{item.amount, jdbcType=DECIMAL, numericScale=2}; - 绕过驱动:在 SQL 层强制转换,例如
cast(#{item.amount} as decimal(18,2)),这一招在批量插入时通常最稳。
如果你一时无法改字段结构,优先考虑升级驱动并在 SQL 层加 cast。这通常是影响面最小、见效最快的处理方式。
MySQL 存储过程和函数里,为什么算着算着就失准
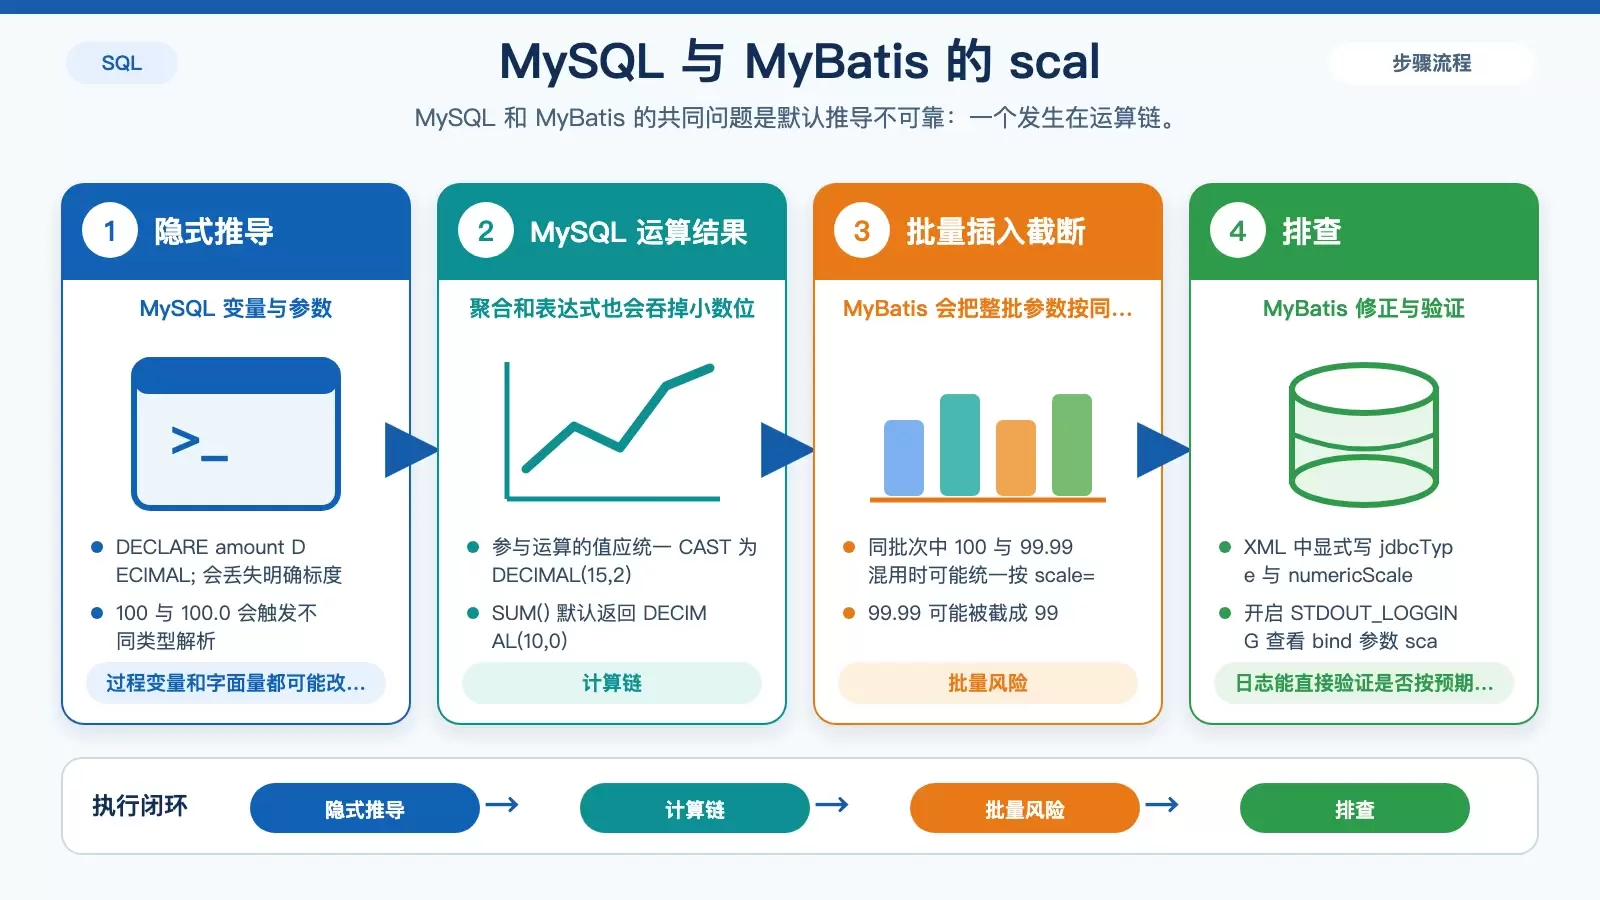
MySQL 里即使表字段已经定义成 DECIMAL(15,2),也不代表整个计算链路都会按定点小数走。只要你在过程或函数里写了 DECLARE total DECIMAL;,或者调用时传入 100 而不是 100.0,MySQL 就可能按 DOUBLE 推导类型,中间计算随之发生漂移。
最容易忽略的两个坑
- 变量只写
DECIMAL,没有写精度和标度; - 调用参数使用整数样式字面量,触发了非预期的自动推导。
这两个问题都很隐蔽,因为 SQL 能正常执行,也未必会报错,但结果会在运算过程中逐步偏掉。
处理方法
- 变量声明必须带精度:写成
DECLARE amount DECIMAL(15,2);,不能省略(M,D); - 调用时字面量加
.0:用CALL calc(100.0, 0.08);替代CALL calc(100, 0.08);; - 运算链全程保留 DECIMAL:所有参与计算的值都显式写成
CAST(... AS DECIMAL(15,2)),不要依赖自动推导; - 注意
SUM()默认返回DECIMAL(10,0):要保留精度,应写成SUM(CAST(amount AS DECIMAL(15,2)))。
这类问题的修复重点不只是“字段改对”,而是保证变量、参数、表达式和聚合结果都沿用同一套精度规则。
MyBatis 批量插入时,为什么整批数据一起被截断
MyBatis 在批量插入场景下,常见问题不是单条值错误,而是一整批参数被统一按较小的 scale 处理。比如同一个列表中,一个值是 amount=100(scale=0),另一个值是 amount=99.99(scale=2),驱动可能把整批都按 scale=0 绑定,结果后者写入后变成 99。
批量场景为什么更容易中招
因为这类问题并非来自单个字段定义错误,而是来自同一批参数在绑定时被“统一口径”处理。只要列表里混入整数风格和小数风格值,就可能触发统一截断。
更稳妥的修正方案
- 在 XML 中为每个数值参数显式加上
jdbcType和numericScale,不要依赖默认映射; - 更彻底的方式是在 SQL 层直接
cast,例如cast(#{item.gljyje} as decimal(22,6)),把精度控制收回到 SQL; - 避免混用整数和小数:列表中的数值统一转换成带固定小数位的
BigDecimal后再传; - 开启 MyBatis
STDOUT_LOGGING,检查日志中 bind 参数是否带有正确的 scale 信息。
如果你只能先做一项修复,优先选 SQL 层 cast,因为它对批量绑定策略的依赖最小,也更容易复现和验证。
PostgreSQL 和 Oracle 中,浮点类型为什么天然不适合金额
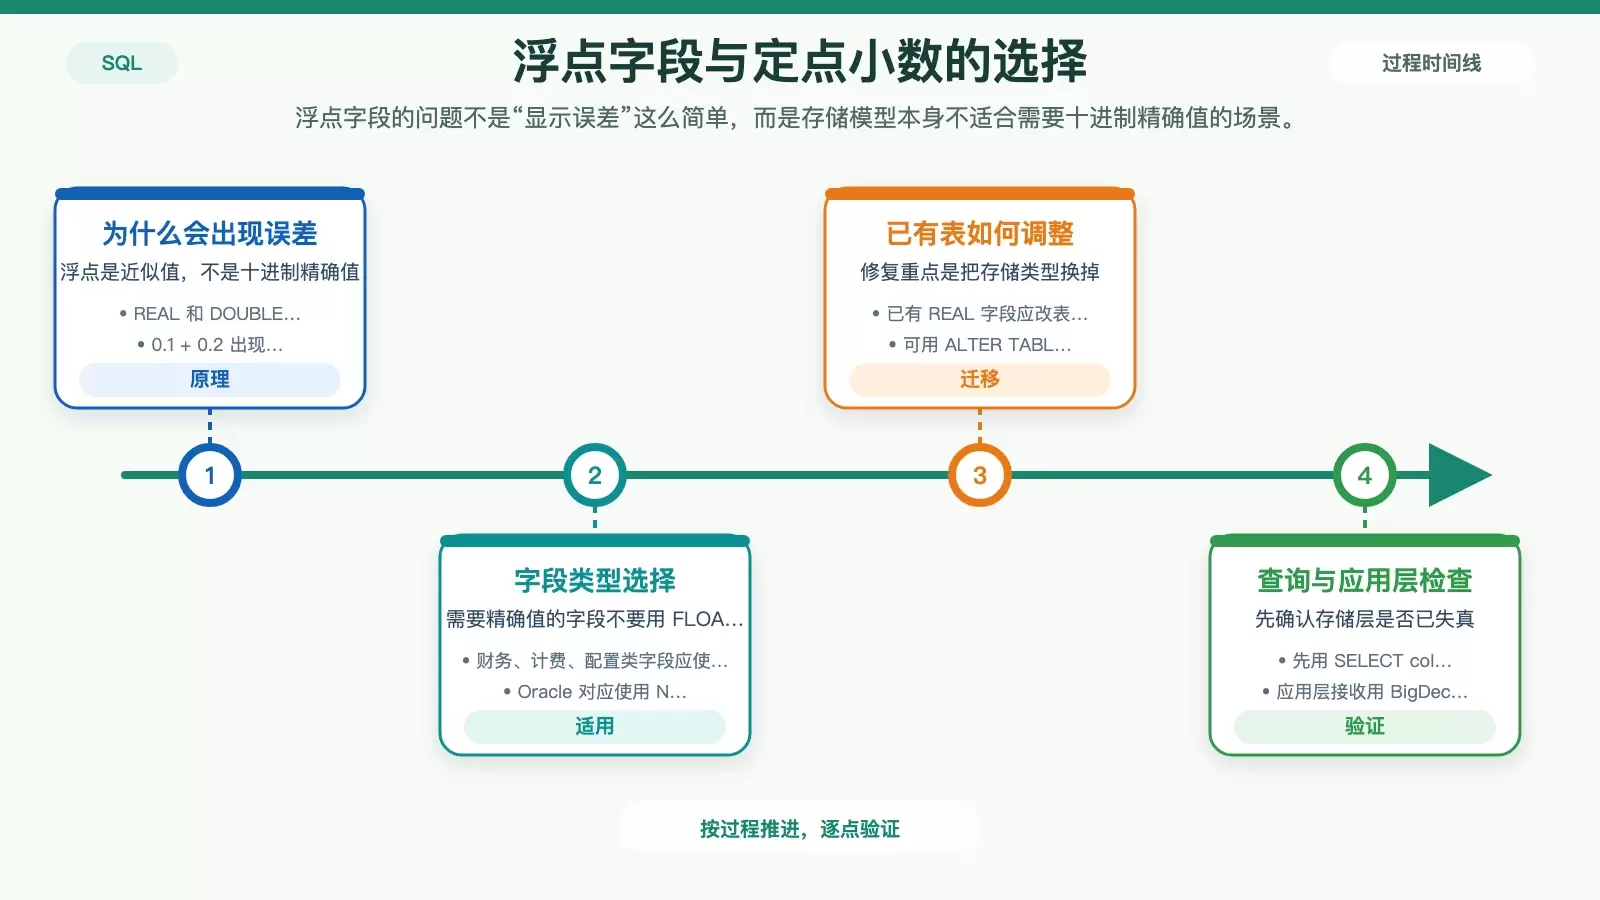
REAL、DOUBLE PRECISION 这类类型本来就是 IEEE 754 浮点表示,它们的设计目标不是“精确保存十进制小数”,而是“近似表示”。所以 0.1 + 0.2 存成 0.30000000000000004 不是 bug,而是类型本身的结果。
哪些字段不该用 FLOAT 系列
财务、计费、配置类字段,都应使用 NUMERIC(p,s) 或 NUMBER(p,s)。只要业务需要“十进制精确值”,就不该把它放进 REAL、FLOAT 或 DOUBLE PRECISION。
已经用了浮点字段怎么办
- 不要指望简单“修数据”,更根本的做法是改表结构;
- 例如 PostgreSQL 可执行:
ALTER TABLE t ALTER COLUMN col TYPE NUMERIC(12,4) USING col::NUMERIC(12,4); - 如果 BI 工具里数据看起来对不上,先直接查数据库原值:
SELECT col::TEXT FROM t; - 若文本结果已经显示
19.999999,说明存储层本身已经失真。
同时,应用层也要配合:Java 使用 BigDecimal,Python 使用 decimal.Decimal,避免再用 float 接收和处理这类值。
排查时优先看这几个点
小数精度问题之所以麻烦,在于它多数情况下不会报错,只会悄悄把结果改掉。排查时建议按下面顺序检查:
- 字段是否使用了正确的定点小数类型,如
DECIMAL、NUMERIC、NUMBER; - 驱动和 ORM 是否显式传递了
scale,尤其是 JDBC、MyBatis 批量场景; - SQL 中是否使用了裸数字、未声明精度的变量或会触发隐式转换的表达式;
- 应用层是否仍在用
float、double处理本应精确的金额或比例。
真正容易漏掉的,往往就是那个没加 .0 的除数、那个没写标度的 DECIMAL 变量,以及 MyBatis 中省略掉的 numericScale。它们不会中断程序,只会默默把 35.35 变成 35。















