



很多人开始使用 WITH,是为了把长 SQL 写得没那么挤;但在团队协作里,它真正的价值不是“换行”,而是把复杂查询拆成一组可命名、可复用、可检查的中间结果。判断一个 WITH 写得好不好,核心不在语法能不能跑通,而在于别人接手时能否快速看清每一步在做什么、哪里可能出错。
下面从 CTE 的职责划分、定义顺序、列名约束,到 WITH RECURSIVE 的适用边界,梳理一套更适合日常开发和多人维护的写法。你可以据此判断:当前这段 SQL 是真的被拆清楚了,还是只是把一个难读的子查询搬进了 WITH。
每个 CTE 只做一件事,命名直接表达业务含义
WITH 更像变量声明,而不是单纯的格式化工具。每个 CTE 最好只承担一个明确职责,避免在同一层里同时做过滤、聚合、关联等多种动作。
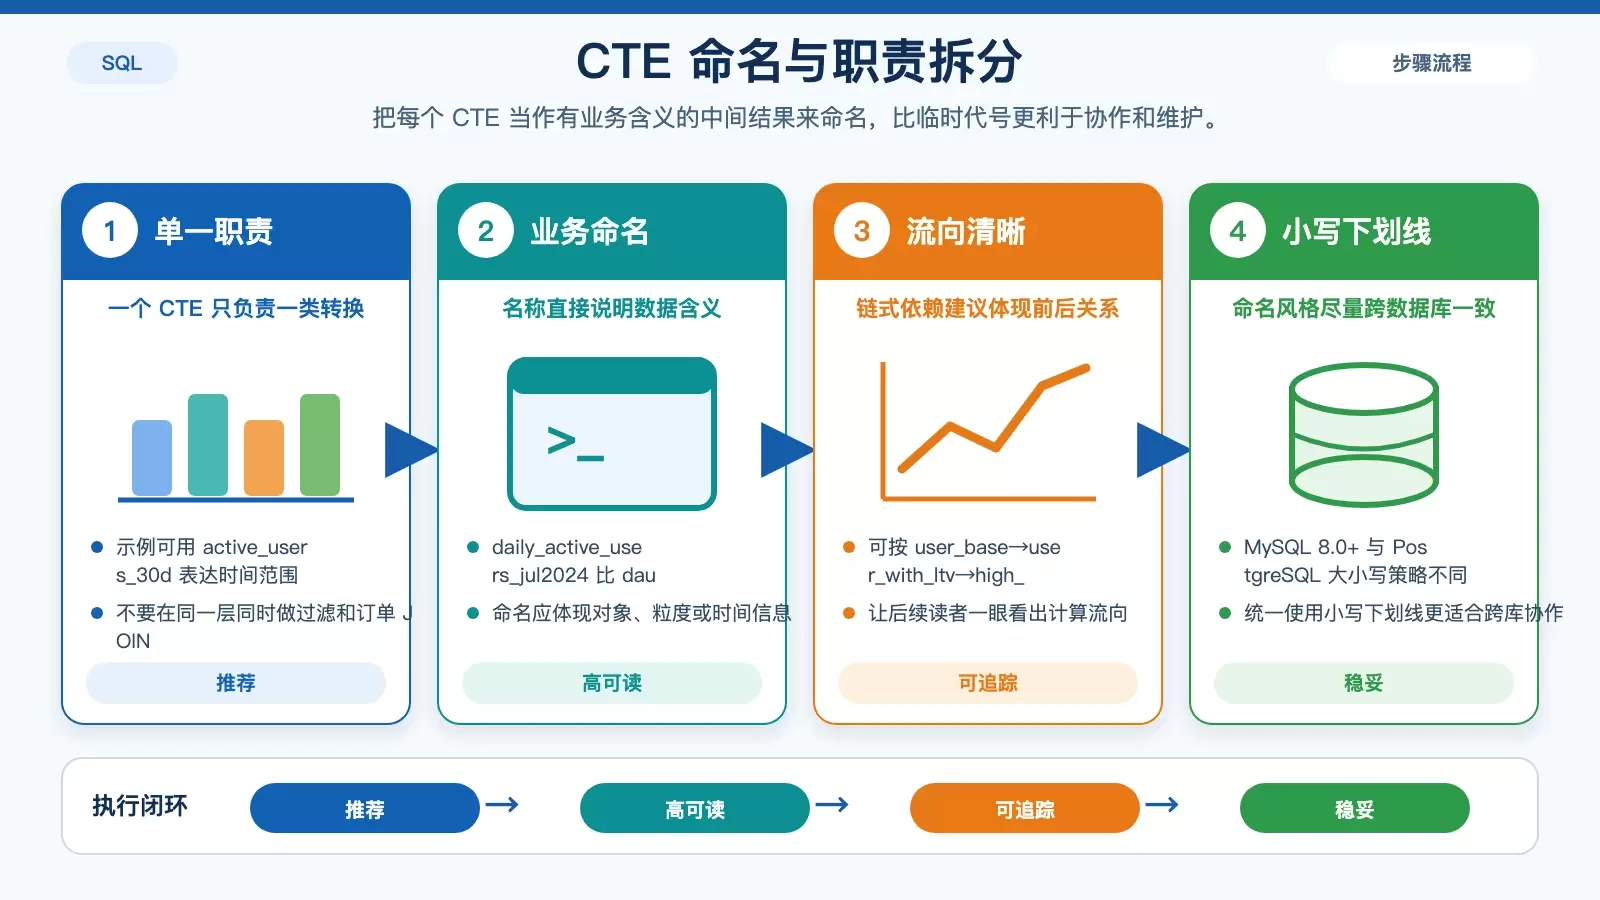
例如,active_users_30d 只负责按用户状态和时间范围过滤数据,不顺手再去关联订单;shipped_orders 只获取 status = 'shipped' 的订单,不额外查询用户字段。这样拆开以后,后续主查询和下游 CTE 的含义会清楚很多。
命名也不要写成 tmp1、subq_a 这类占位符。相比之下,daily_active_users_jul2024 比 daus 更适合多人协作和后期维护,因为它把数据对象、粒度和时间范围都写清楚了。
- 链式依赖可以用有层次的命名表达计算流向,例如
user_base→user_with_ltv→high_value_cohort - 尽量避免缩写歧义,
rev可能是 revenue、review 或 reversal,而revenue_q2_2024不会让人猜 - 考虑到 MySQL 8.0+ 和 PostgreSQL 对大小写敏感策略不同,统一使用小写下划线命名更稳妥
多个 CTE 的分隔、引用顺序和依赖关系要写清楚
写多个 CTE 时,AS 后面必须紧跟括号,不同 CTE 之间使用英文逗号分隔。这个细节看起来简单,但漏掉逗号时,MySQL 8.0+ 会直接报 ERROR 1064 (42000)。
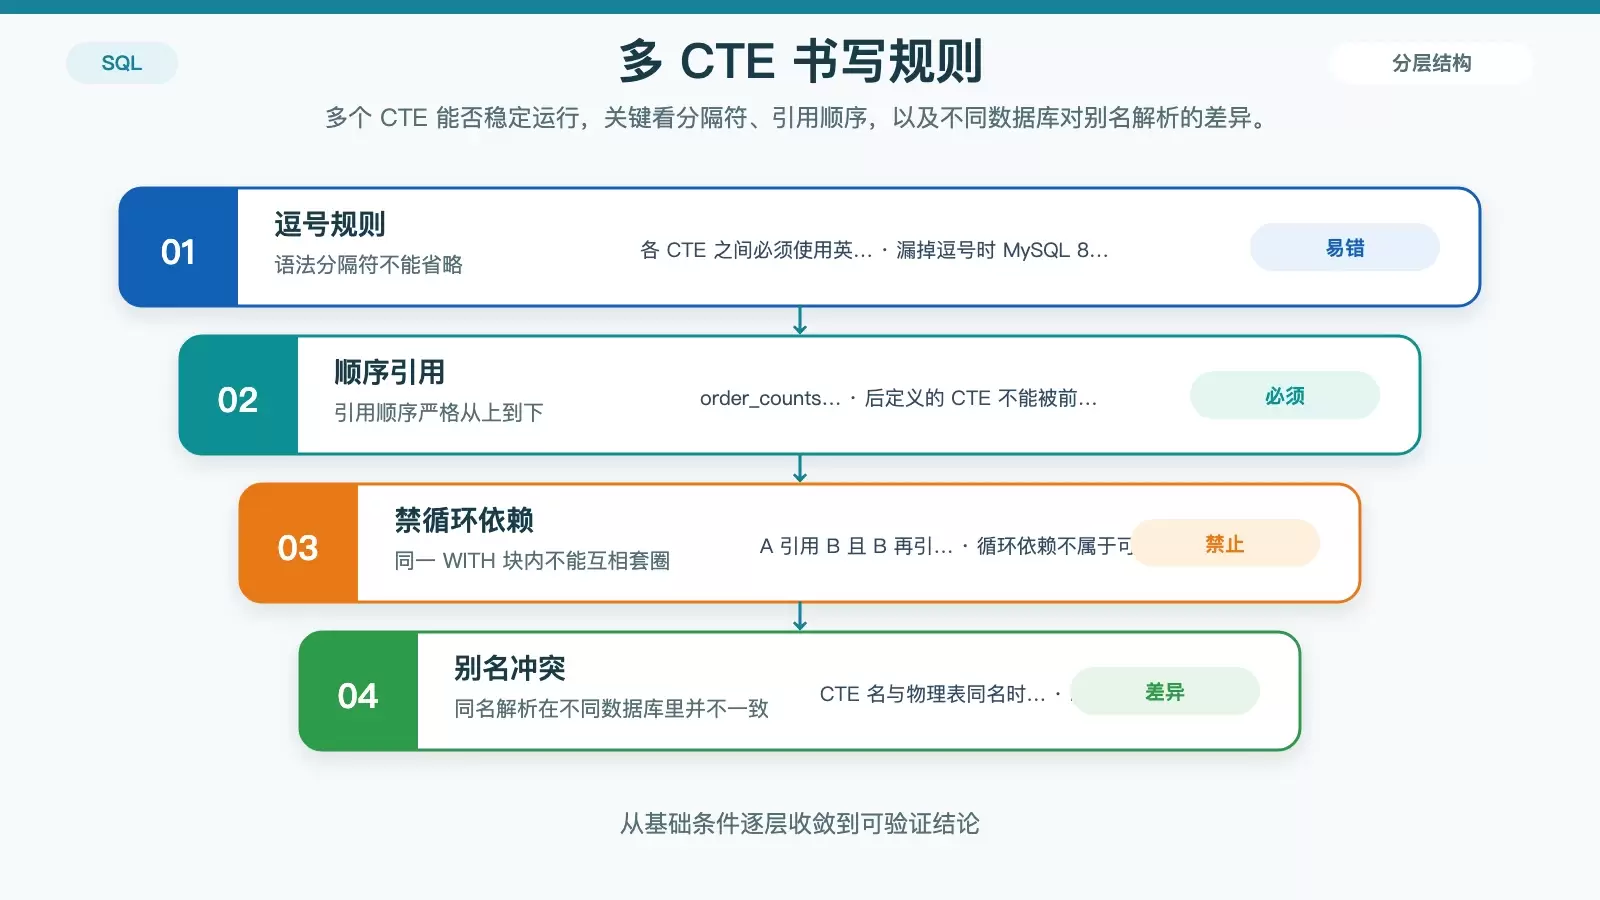
另一个更容易忽略的问题是定义顺序。CTE 的可引用范围是从上到下展开的,后面定义的 CTE 不能被前面的 CTE 提前引用。
正确的顺序示例
WITH
order_counts AS (SELECT user_id, COUNT(*) AS cnt FROM orders GROUP BY user_id),
high_freq_users AS (SELECT user_id FROM order_counts WHERE cnt > 5)-- ✅ 正确:order_counts 已定义
SELECT * FROM high_freq_users;
错误的顺序示例
WITH
high_freq_users AS (SELECT user_id FROM order_counts WHERE cnt > 5),-- ❌ 报错:order_counts 尚未定义
order_counts AS (SELECT user_id, COUNT(*) AS cnt FROM orders GROUP BY user_id)
SELECT * FROM high_freq_users;
- 不能出现循环依赖,例如 A 引用 B、B 又引用 A,数据库会直接拒绝解析
- PostgreSQL 允许在同一个
WITH块里跨 CTE 引用,只要定义顺序正确;MySQL 8.0+ 也支持,但 SQLite 旧版本不支持多 CTE - 如果 CTE 名和物理表同名,例如都叫
users,MySQL 默认优先选物理表,PostgreSQL 则优先选 CTE,这一点在跨库迁移时尤其要注意
主查询和 CTE 内部都应显式列名,不要使用 SELECT *
SELECT * 在 CTE 场景里是典型的可维护性陷阱。CTE 内部如果包含 GROUP BY,或者数据库在优化阶段重排字段顺序,跨数据库迁移时就可能出现字段错位。再加上多表 JOIN 时未加前缀,很容易触发 Column 'id' is ambiguous 这类错误。
更稳妥的写法是:每个 CTE 在 AS 后单独起行写 SELECT,把要输出的字段逐个列明,并在主查询中继续显式引用。
WITH
shipped_orders AS (
SELECT
order_id,
user_id,
amount,
created_at
FROM orders
WHERE status = 'shipped'
)
SELECT
u.name,
so.amount,
so.created_at
FROM users u
JOIN shipped_orders so ON u.id = so.user_id;
- 如果 CTE 中包含
GROUP BY,所有非聚合字段都必须出现在GROUP BY列表里,否则 MySQL 8.0+ 严格模式下会报ERROR 1055 (42000) - 字段别名应在 CTE 内部一次定义好,主查询直接使用,避免在主查询里再次
AS重命名 - 如果定义 CTE 时不声明列名,例如
WITH x AS (SELECT a+b),后续字段名可能变成expr_1之类的系统生成名,调试成本很高
`WITH RECURSIVE` 只在层级深度不可预知时使用
很多人一看到上下级结构,就习惯性加上 RECURSIVE。但递归 CTE 不是“更高级的 SQL 写法”,它只适合解决确实需要逐层展开的树形或自关联问题。滥用的结果往往不是更优雅,而是无限循环、栈溢出,或者得到一堆并不符合预期的中间结果。
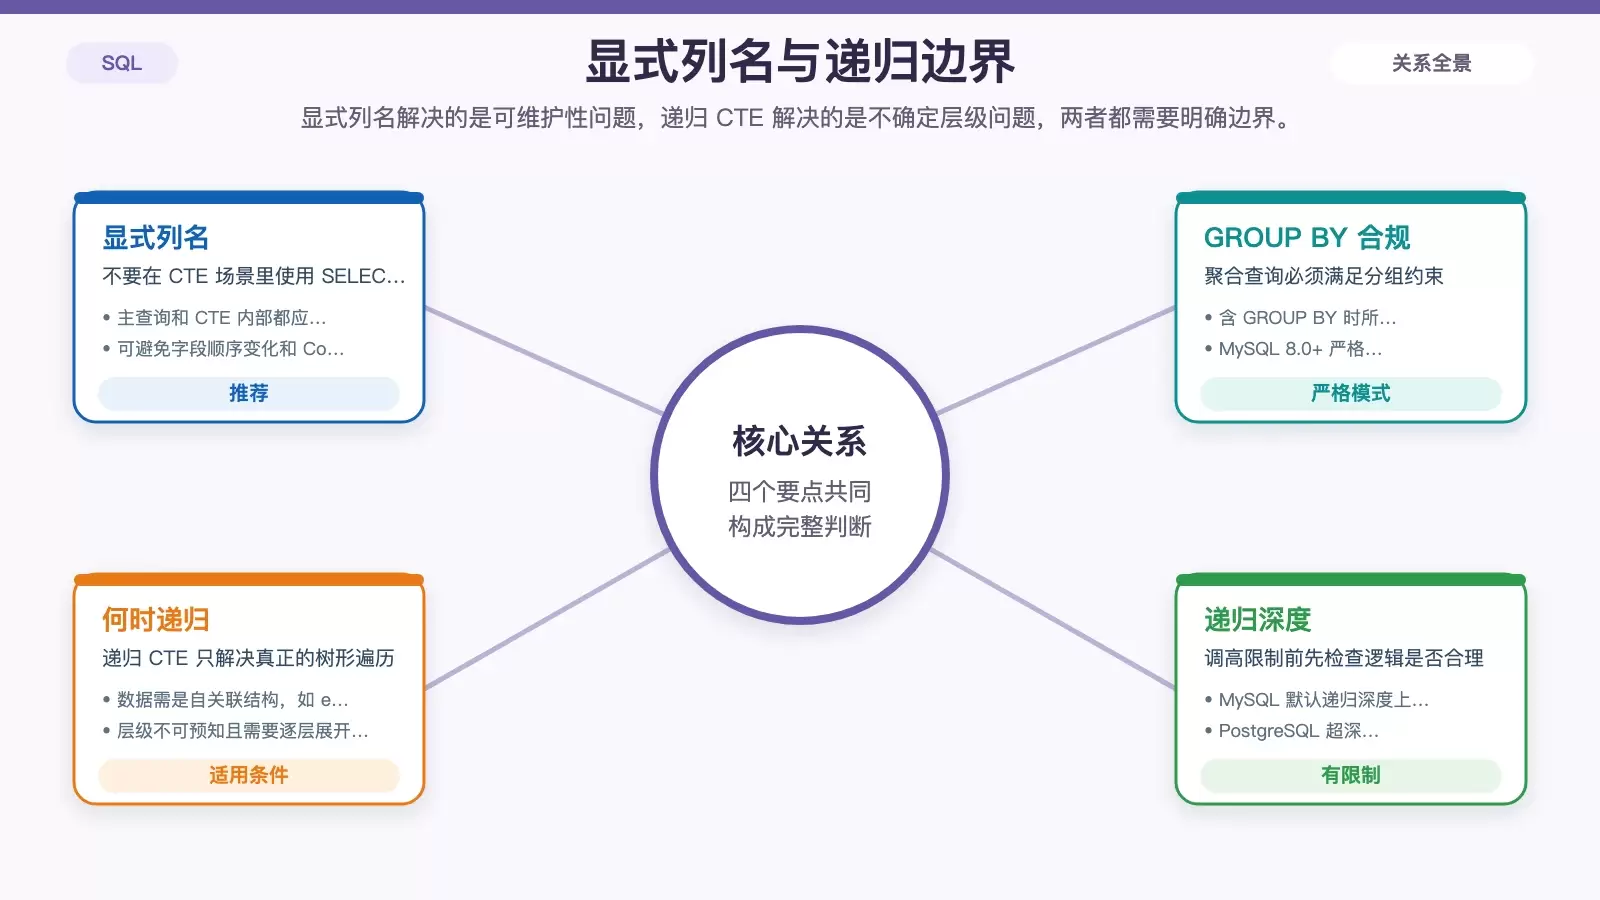
通常只有同时满足下面三项,才值得考虑递归 CTE:
- 数据本身是自关联结构,例如
employees.manager_id → employees.id - 层级深度不可预知,不能靠写死 3 层
JOIN解决 - 确实需要逐层展开路径,例如查询某员工的所有下属,包含间接下属
写法上,锚点(anchor)和递归部分必须用 UNION ALL 连接,且递归引用只能出现在 FROM 子句中,别名也必须与 CTE 名保持一致:
WITH RECURSIVE org_tree AS (
SELECT id, name, manager_id, 1 AS level
FROM employees
WHERE manager_id IS NULL-- 锚点:顶层
UNION ALL
SELECT e.id, e.name, e.manager_id, ot.level + 1
FROM employees e
INNER JOIN org_tree ot ON e.manager_id = ot.id-- ✅ 正确:引用自身别名
)
SELECT * FROM org_tree;
还要注意数据库的递归限制。MySQL 默认递归深度限制为 100,超限会报 ERROR 3636 (HY000);PostgreSQL 常见报错则是 stack depth limit exceeded。在提高限制之前,应该先确认 SQL 逻辑是否真的需要这么深的层级。
`WITH` 的核心收益是可读性,不一定是性能
最后一个容易被误解的点是:CTE 本身并不等于性能优化。多数数据库引擎会把它当作语法重写处理,而不是自动物化的中间表,所以使用 WITH 并不意味着查询一定更快。
它的真正价值通常体现在协作效率上:把查询拆成职责单一、命名清晰、字段明确的几步后,别人可以在几秒内看懂意图,并更快定位问题、修改逻辑。对日常开发来说,这比“看起来高级”的写法更重要。















