



很多人一看到 GROUP BY 变慢,第一反应是“数据量太大”,但实际更常见的问题是执行路径跑偏:该走索引的地方没走,最后落到 Using temporary 或 Using filesort。这篇文章就按排查顺序来拆解,先教你怎么从 EXPLAIN 一眼判断病根,再看“明明建了索引却还是慢”的典型失效场景,最后给出 DISTINCT 替代和联合索引排序的判断方法。
先看 EXPLAIN:GROUP BY 是否已经触发临时表或排序
排查 GROUP BY 性能,第一步不是急着改 SQL,而是先看执行计划。直接运行:
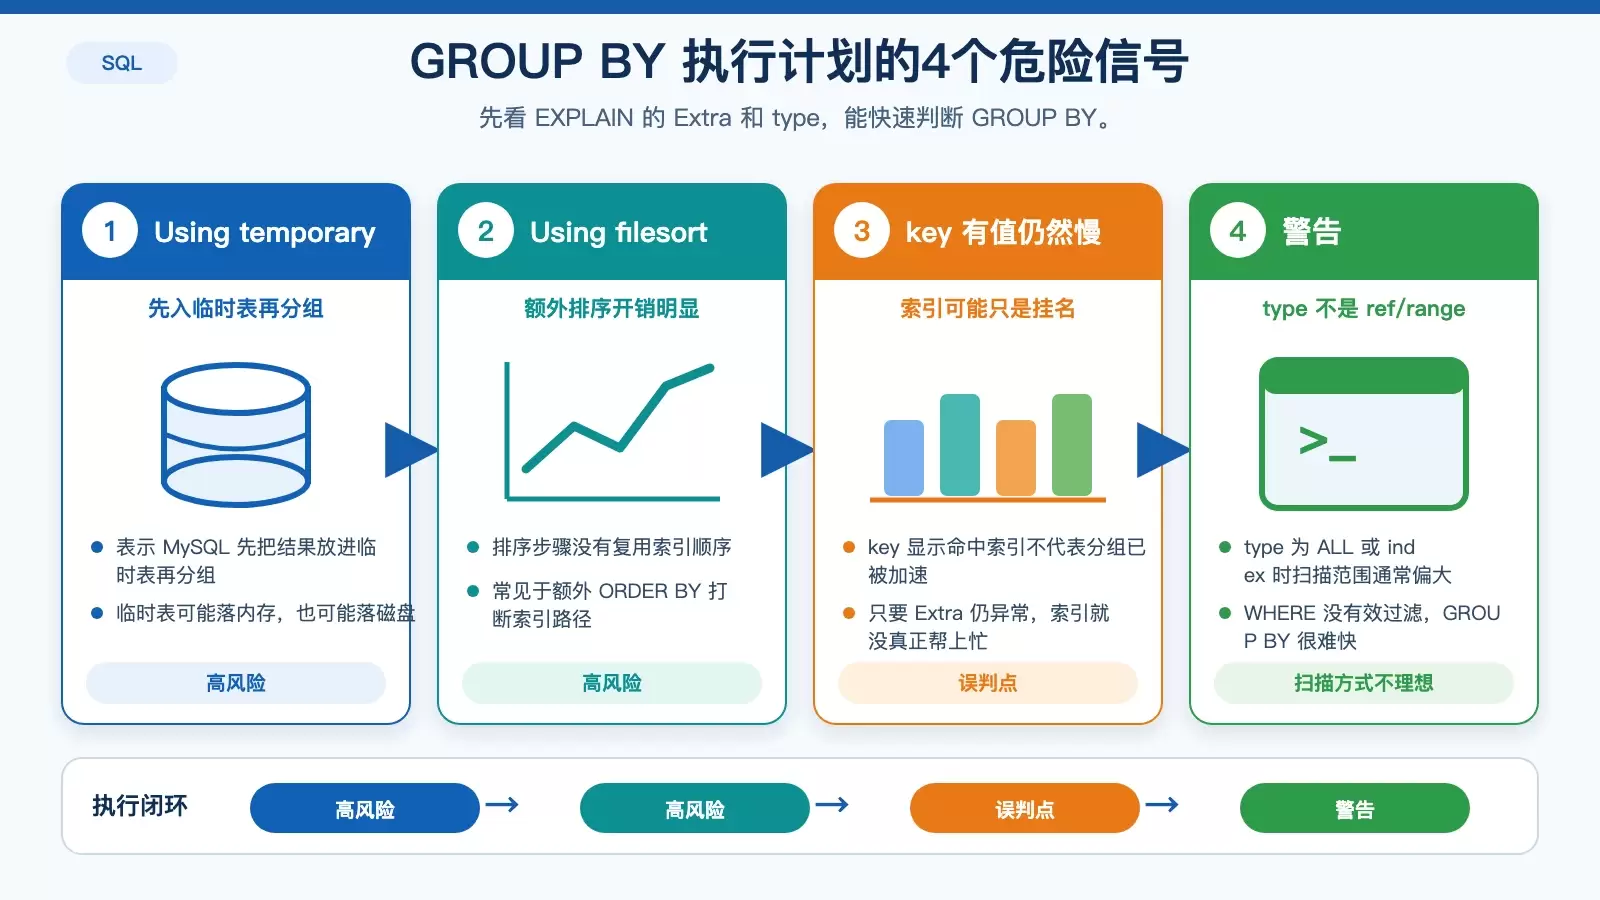
EXPLAIN FORMAT=TRADITIONAL重点盯住 Extra 列,它通常比“有没有命中索引”更能说明问题。
出现 Using temporary,通常就是性能断崖
Using temporary:说明 MySQL 先把匹配行拉进内存或磁盘临时表,再做分组,这是最典型的慢查询信号。- 这类执行路径意味着分组过程没有直接复用索引顺序,而是额外做了一次中间结果整理。
出现 Using filesort,说明排序逻辑没复用索引
Using filesort:即便GROUP BY字段本身建了索引,只要排序步骤不能复用索引顺序,MySQL 仍然会强制排序。- 典型情况就是后面又跟了
ORDER BY COUNT(*) DESC,这类排序无法直接沿着普通索引顺序完成。
别只看 key,还要结合 type 和 Extra 一起判断
key显示用了索引,但Extra里仍有Using temporary或Using filesort,基本等于索引“挂上了,但没真正帮到分组”。type如果是ALL或index,而不是ref/range,通常说明WHERE条件本身就没有效利用索引,后面的GROUP BY更难快起来。
为什么建了索引,GROUP BY 还是慢
最常见的误区,是给 GROUP BY 字段单独建一个索引,就以为问题解决了。实际执行时,索引是否有效取决于顺序、覆盖性以及 WHERE 条件是否匹配。
索引顺序不对,单列索引和错序索引都可能失效
- 如果 SQL 是
GROUP BY a, b,但索引建成(b, a)或只建了(a),就无法按预期支持分组。 - B+ 树索引不能跳过前缀,直接按后缀字段完成分组,这也是“有索引却没提速”的高频原因。
SELECT 没覆盖,回表会把 IO 成本拉高
例如:
SELECT a, b, SUM(c) FROM t GROUP BY a, b如果索引只有 (a, b),那么 c 仍然需要回表读取。数据量一大,随机 IO 成本会明显上升,分组本身再快也会被拖慢。
WHERE 条件破坏最左前缀,前面的索引设计等于白做
例如:
WHERE status = 1 AND created_at > '2024-01-01'如果索引是:
(user_id, status, created_at)而 user_id 没出现在 WHERE 中,那么最左前缀就断了,后面的 status、created_at 也很难按预期发挥作用。
隐式类型转换,也会让索引直接失效
例如:
WHERE user_id = '123'如果字段类型其实是 BIGINT,就可能触发隐式类型转换,导致索引失效,覆盖索引也随之失去意义。这类问题在排查时很容易被忽略,但在实际线上环境并不少见。
什么时候 DISTINCT 可能比 GROUP BY 更快
如果你的目标只是“列出所有满足条件的组合”,并不需要聚合结果,例如没有 COUNT(*)、SUM() 之类的计算,那么可以认真比较一下 DISTINCT。
常见对比写法如下:
SELECT DISTINCT customer_id, city FROM orders WHERE ...SELECT customer_id, city FROM orders WHERE ... GROUP BY customer_id, city- 在 MySQL 和 SQL Server 中,
DISTINCT往往更倾向走Sort + Unique。 - 而
GROUP BY可能触发哈希聚合或临时表,执行代价不一定更低。
但 DISTINCT 不能无脑替换 GROUP BY
- 如果后续还要加
HAVING或聚合函数,就不能简单替换成DISTINCT。 - 两者在语法层面可能看起来“等价”,但执行引擎底层路径往往完全不同,是否更快必须结合执行计划判断。
联合索引怎么排,才更适合 GROUP BY
联合索引不是把字段简单堆进去就行,顺序决定了它能不能真正减少扫描、排序和回表。
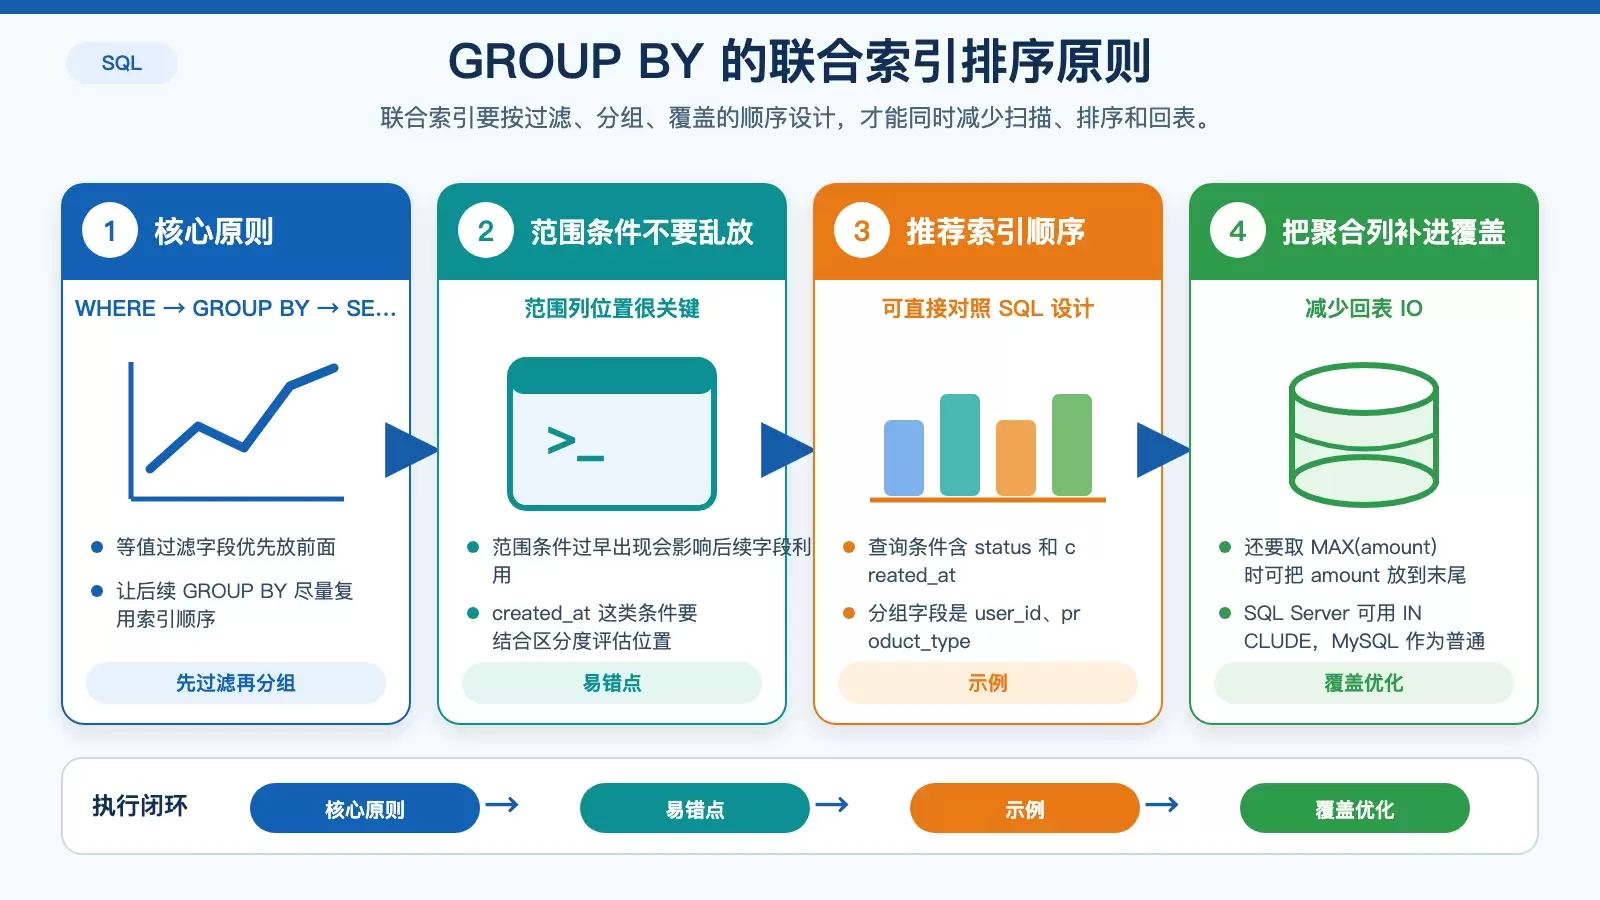
一个实用顺序:WHERE → GROUP BY → SELECT
- 通常可按
WHERE → GROUP BY → SELECT的顺序来组织联合索引。 WHERE中的等值过滤字段优先放前面,先缩小扫描范围,再让GROUP BY复用后续索引顺序。- 如果查询里还有非聚合查询列,需要尽量纳入索引,减少回表。
范围条件的位置,要结合后续分组字段一起看
- 像
created_at > '2024-01-01'这样的范围条件,通常要放在WHERE中高区分度字段之后。 - 一旦范围扫描过早截断索引顺序,后续字段能否继续用于分组和覆盖,就要非常谨慎地评估。
一个直接可用的索引设计示例
例如查询条件是:
WHERE status IN ('A','B') AND created_at > '2024-01-01' GROUP BY user_id, product_type那么更合适的索引可以是:
(status, created_at, user_id, product_type)如果还要查询:
SELECT MAX(amount)那么可以继续把 amount 放到索引末尾,SQL Server 可使用 INCLUDE,MySQL 则作为普通索引列加入,以尽量形成覆盖。
最后判断标准:Extra 才是最可信的线索
真正拖慢 GROUP BY 的,很多时候不是数据量本身,而是索引没有对上执行路径。排查时不要只看“有没有建索引”,而要回到 EXPLAIN 的 Extra、type、key 这些核心字段上:只要 Using temporary、Using filesort 还在,优化通常就还没做到位。















