



很多人写条件统计时,会先用 COUNT(CASE WHEN ...) 算出满足条件的数量,再用 COUNT(*) 做减法推导“不满足”的数量。这个写法在字段可能出现 NULL、还要继续做分组比例或跨数据库复用时,往往会把“明确不满足”和“未知值”混在一起。下面就按实际查询场景拆开说明:什么写法更稳,为什么 NULL 必须单独考虑,以及不同数据库里哪些细节最容易出错。
直接用两个 SUM(CASE WHEN) 统计两组数量
如果目标是同时拿到“满足条件”和“不满足条件”的行数,最稳妥的方式就是分别写两个 SUM(CASE WHEN ... THEN 1 ELSE 0 END)。这样每一行都会被明确归类,不会因为聚合函数对 NULL 的处理方式而产生歧义。
典型写法如下:
SELECT
  SUM(CASE WHEN status = 'paid' THEN 1 ELSE 0 END) AS paid_count,
  SUM(CASE WHEN status != 'paid' OR status IS NULL THEN 1 ELSE 0 END) AS unpaid_or_unknown_count
FROM orders;
这里的关键点有几个:
SUM(CASE WHEN status = 'paid' THEN 1 ELSE 0 END)统计的是明确满足条件的行数。SUM(CASE WHEN status != 'paid' OR status IS NULL THEN 1 ELSE 0 END)统计的是其余所有行,重点在于把NULL显式纳入。- 如果字段本身定义了
NOT NULL,第二段可以简化为SUM(CASE WHEN status != 'paid' THEN 1 ELSE 0 END)。
这类写法的优势不只是结果正确,还在于语义清楚。你在 SQL 里已经把每一类记录的归属写明,后续别人接手查询时,也能直接看懂统计口径。
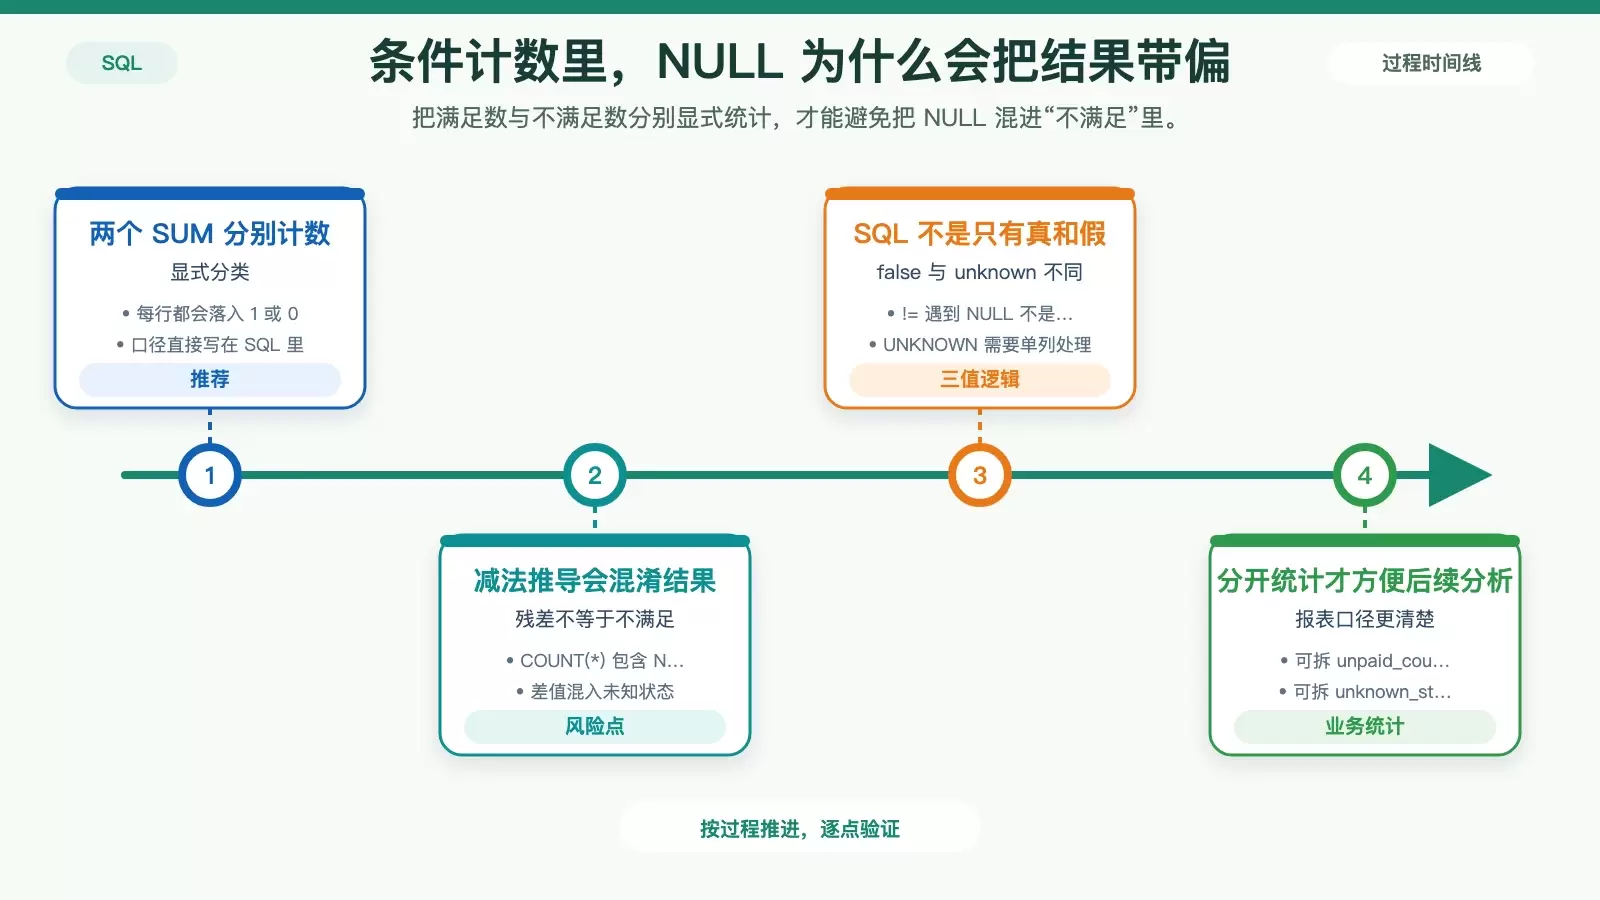
为什么 COUNT(CASE WHEN) 加减法不可靠
很多人会写成下面这样:
SELECT
  COUNT(CASE WHEN status = 'paid' THEN 1 END) AS paid_count,
  COUNT(*) - COUNT(CASE WHEN status = 'paid' THEN 1 END) AS unpaid_count
FROM orders;
表面上这像是在统计“总数减满足数”,但它其实只是在做剩余值推导,并不等于真正的“不满足条件”。问题主要出在 NULL 和三值逻辑上。
NULL 会被混进差值里
假设 status 列中同时存在 'paid'、'pending' 和 NULL:
COUNT(CASE WHEN status = 'paid' THEN 1 END)只统计 paid 行。COUNT(*)会把全部行都算进去,包括NULL。- 两者相减得到的是“非 paid 的剩余行数”,其中既有明确不满足的记录,也有状态未知的记录。
也就是说,这个差值并不能准确代表业务意义上的“不满足条件”。它只是一个残差集合。
无法区分 false 和 unknown
SQL 不是简单的二值逻辑,而是包含 TRUE、FALSE、UNKNOWN 三种结果。像 status != 'paid' 在遇到 NULL 时,并不会返回 TRUE,而是返回未知。
如果业务要求更细,比如分开统计:
SELECT
  SUM(CASE WHEN status = 'paid' THEN 1 ELSE 0 END) AS paid_count,
  SUM(CASE WHEN status != 'paid' THEN 1 ELSE 0 END) AS unpaid_count,
  SUM(CASE WHEN status IS NULL THEN 1 ELSE 0 END) AS unknown_status_count
FROM orders;
那么显式分支就不是“可选优化”,而是保证口径准确的必要条件。尤其在报表、对账、审核场景中,把未知值误算成不满足,后面做比例、转化率或状态分布时都会出现偏差。
分组统计时,数量和比例该怎么写
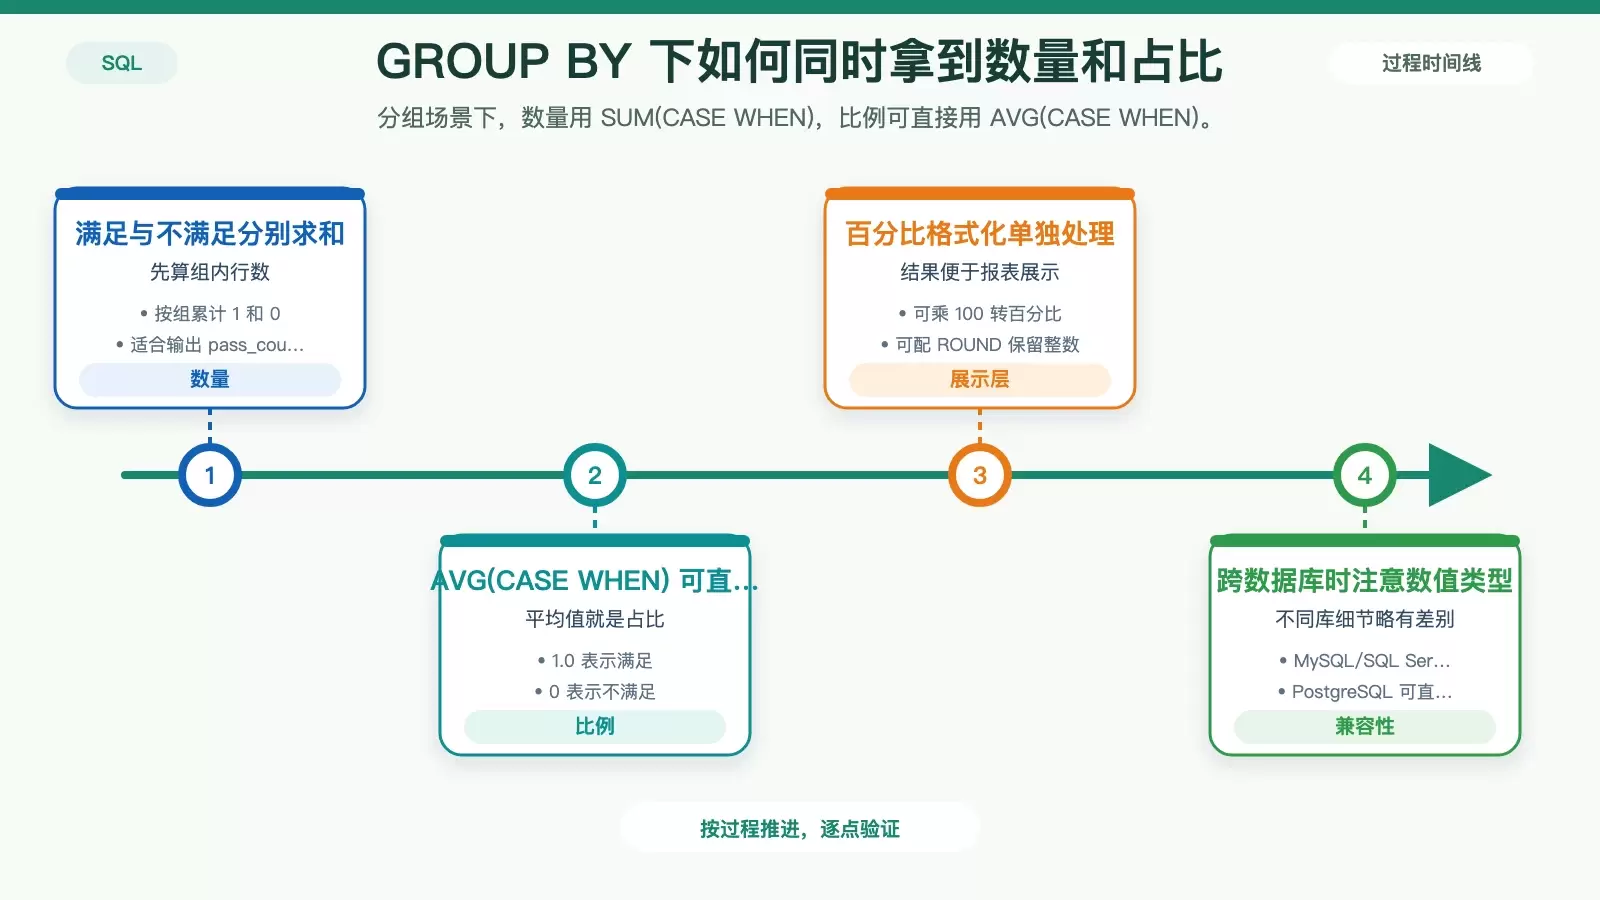
进入 GROUP BY 场景后,通常不只要每组的满足数和不满足数,还会进一步算占比。这里建议把“数量统计”和“比例统计”分开理解。
每组数量的稳定写法
SELECT
  category,
  SUM(CASE WHEN score >= 60 THEN 1 ELSE 0 END) AS pass_count,
  SUM(CASE WHEN score < 60 OR score IS NULL THEN 1 ELSE 0 END) AS not_pass_count
FROM exams
GROUP BY category;
这种写法的好处是,每个分组里每一行都被明确归类。即便后面要继续联表、嵌套或者做窗口统计,这个基础口径也是稳定的。
每组比例可直接用 AVG(CASE WHEN)
如果还要统计每组及格率,直接写 AVG(CASE WHEN ... THEN 1.0 ELSE 0 END) 会更省事:
SELECT
  category,
  AVG(CASE WHEN score >= 60 THEN 1.0 ELSE 0 END) AS pass_rate
FROM exams
GROUP BY category;
AVG(CASE WHEN score >= 60 THEN 1.0 ELSE 0 END)返回的是小数形式的比例。- 它在语义上等价于
SUM(CASE WHEN score >= 60 THEN 1 ELSE 0 END) * 1.0 / COUNT(*)。 - 如果要显示百分比,可以再套一层
ROUND(... * 100, 0)。
在工程实践里,这样写通常比手动相除更直接,因为你不用重复展开分子和分母,也更容易看出统计意图。
跨数据库写法的几个关键细节
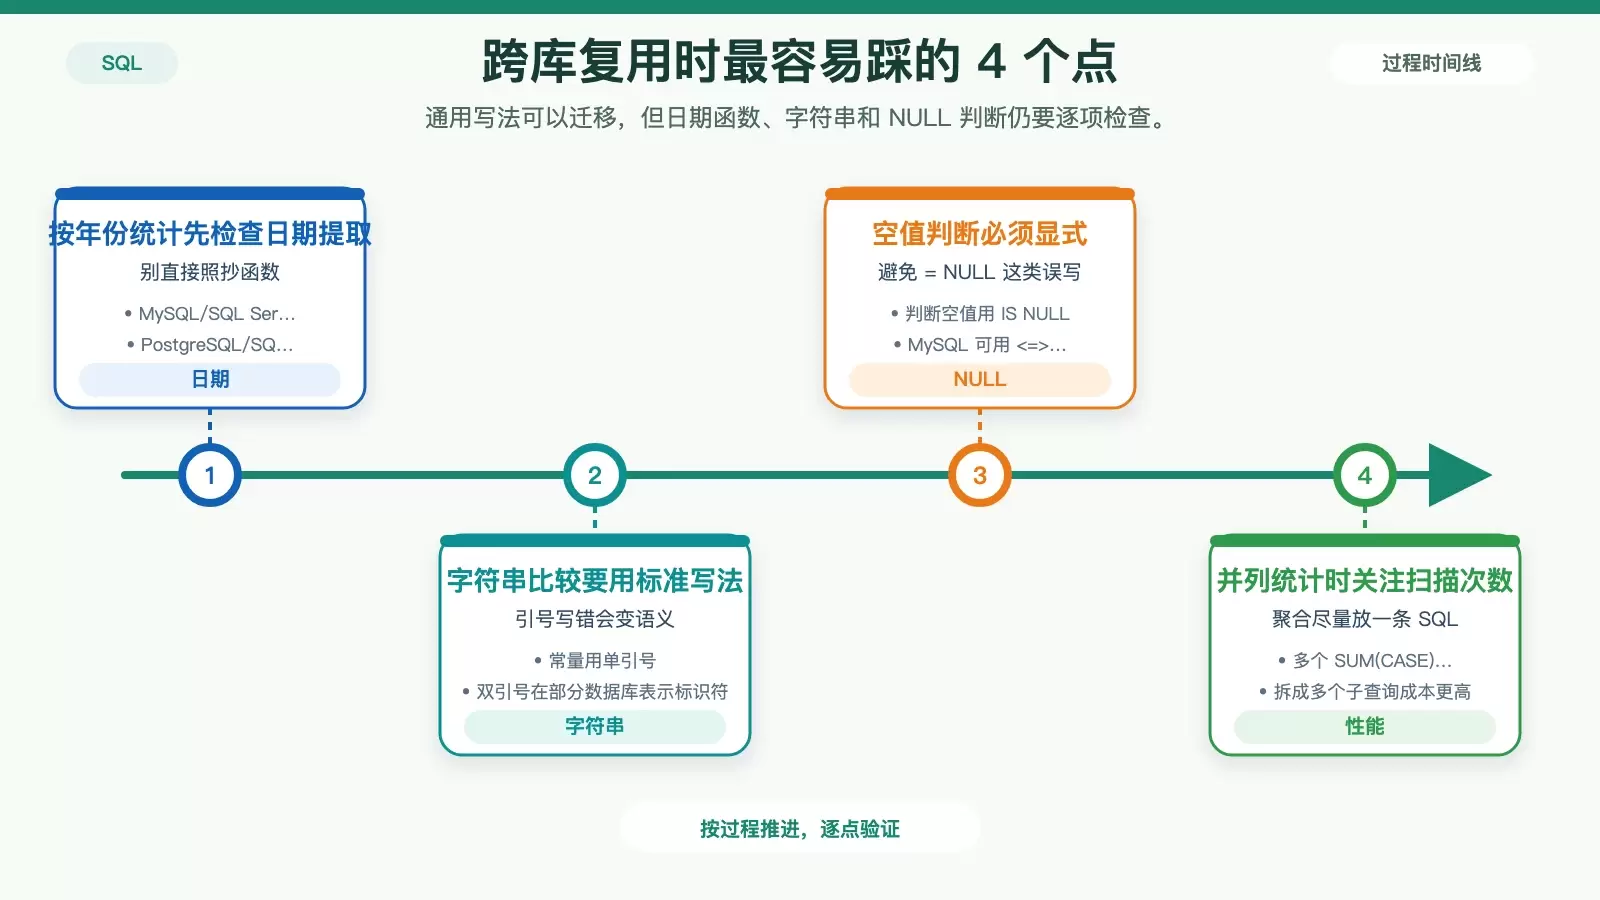
SUM(CASE WHEN ... THEN 1 ELSE 0 END) 基本属于各主流数据库都支持的通用写法,但迁移时还是有几类细节需要单独检查。
日期函数写法不同
- MySQL / SQL Server:
YEAR(order_date) - PostgreSQL:
EXTRACT(YEAR FROM order_date) - SQLite:
strftime('%Y', order_date)
如果你的条件统计里包含按年份筛选、分组或比较,这部分不能直接照抄。
字符串和 NULL 判断要写标准形式
- 字符串常量要用单引号,比如
'active',不要误写成双引号。 - 判断空值时要写
status IS NULL,不要依赖= NULL或!= NULL。 - MySQL 如果确实需要做空值安全比较,可以使用
status <=> 'paid'。
这些细节看起来小,但往往就是条件统计结果不对的根源。
多条件并列统计时,一次扫描更划算
如果你要在同一条查询里统计多个条件,例如已支付、待支付、已取消、空状态等,使用多个 SUM(CASE ...) 往往只需要扫描一遍表。相比之下,把每个状态拆成独立子查询或多条 WHERE 聚合,再拼接结果,通常会带来更多扫描成本。
在数据量较大时,这种差异会直接反映在执行时间上。因此,条件分组统计优先集中在一条聚合 SQL 中完成,通常更符合性能和可维护性的平衡。
正式落库前,先检查 NULL 占比
实际项目里最容易被忽略的一步,不是 SQL 能不能跑通,而是你是否确认过数据中到底有没有 NULL。很多统计逻辑在测试库里看起来没问题,只是因为样本数据刚好比较干净。
在正式确定统计口径前,可以先单独查一下空值比例。例如在 PostgreSQL 中:
SELECT COUNT(*) FILTER (WHERE col IS NULL)
FROM your_table;
如果希望直接看比例,也可以用这种通用思路:
SELECT AVG(CASE WHEN col IS NULL THEN 1.0 ELSE 0 END)
FROM your_table;
先看清数据分布,再决定是否把 NULL 纳入“不满足”、单独拆出“未知”,或者在业务层先做清洗,这样后面的统计结果才有解释力。
归根到底,条件统计不是单纯把数字算出来,而是先定义好每一类数据应该落到哪里。只要涉及 NULL、分组比例或跨库迁移,优先使用显式的 SUM(CASE WHEN ... THEN 1 ELSE 0 END),再按需要拆出 IS NULL 分支,通常就是最稳的一种写法。















