



很多人把“视图查询慢”归因于视图本身,但真正拖慢查询的,通常是视图展开后的底层 SQL 没有用好索引,或者执行计划已经偏离了预期。要把问题查清楚,关键不是纠结视图这个壳,而是顺着 WHERE、JOIN、ORDER BY 和返回列一路往下看:索引建在哪、顺序是否合理、执行计划是否出现回表和排序、复杂逻辑是否已经超出普通视图适用范围。
视图查询慢,先看展开后的 SQL 有没有走对索引
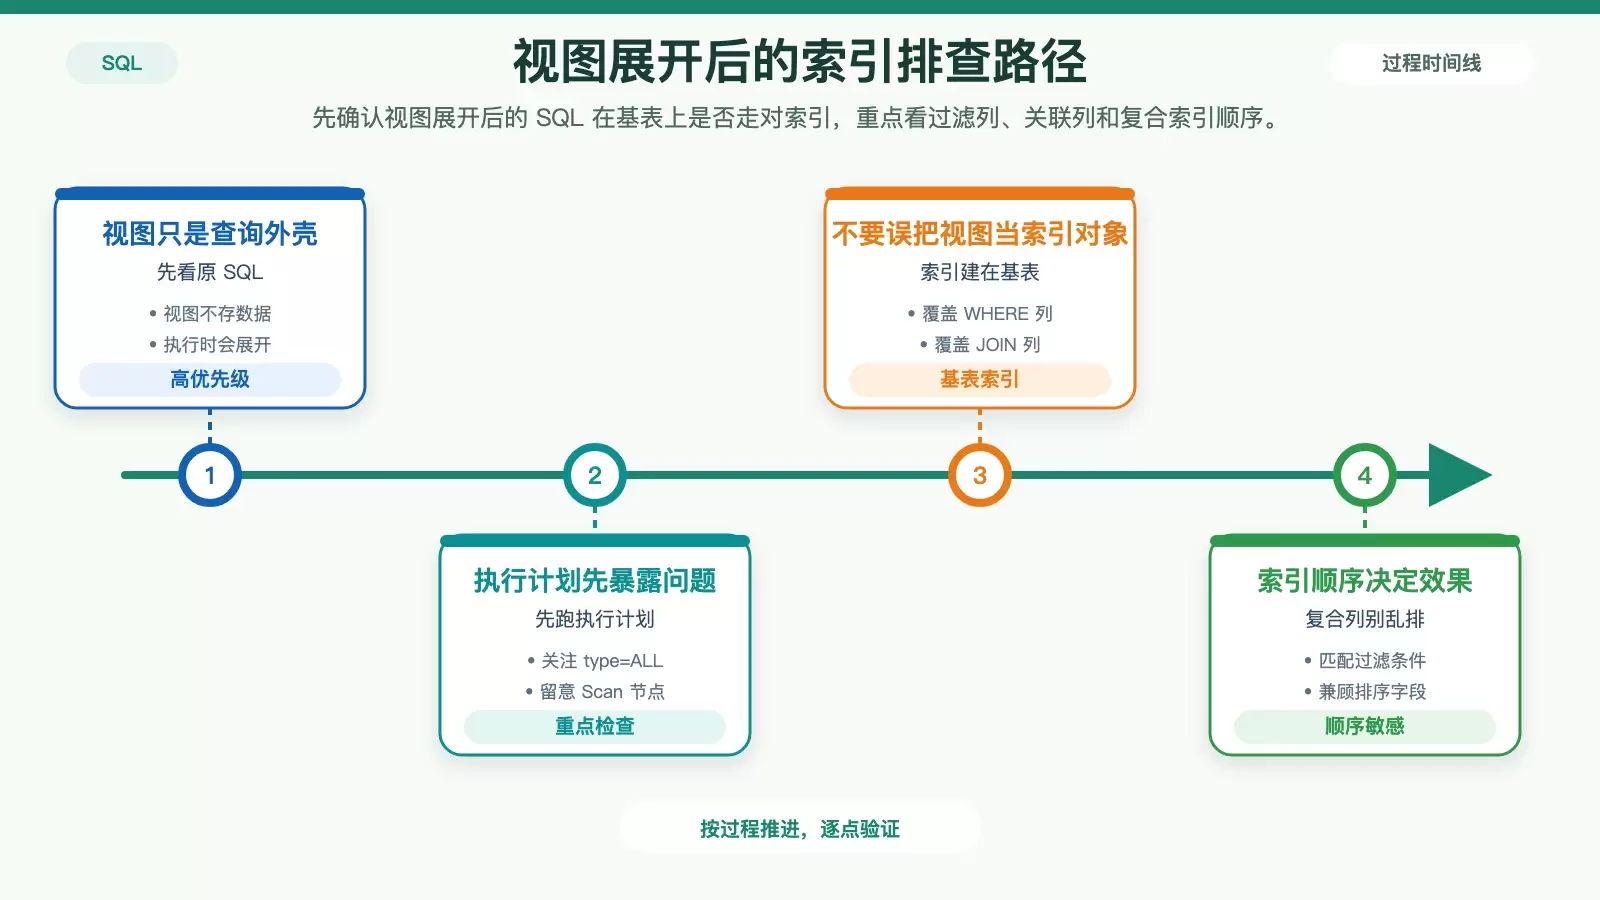
视图本身不存数据,也不自带索引,它只是一个封装好的 SELECT 语句。查询视图时,数据库通常会把视图定义内联展开,再执行完整查询。因此,视图慢的根因大多不在“视图对象”本身,而在展开后的访问路径上。
例如下面这个视图定义:
CREATE VIEW v_user_orders AS
SELECT u.name, o.amount
FROM users u
JOIN orders o ON u.id = o.user_id
WHERE u.status = 'active'
如果再执行:
SELECT * FROM v_user_orders WHERE o.amount > 100数据库实际做的,是在展开后的原始查询上继续附加过滤条件。这时如果 orders.amount 没有索引,就很容易出现全表扫描,视图自然也就慢了。
排查时建议先看执行计划。MySQL 可以用 EXPLAIN,SQL Server 可以直接看图形化执行计划,重点关注是否出现 type=ALL、Scan 一类信号。这类结果通常说明优化器没有找到足够有效的索引访问路径。
索引也不要建在“视图”这个概念上,而是建在视图依赖的基表上。常见需要重点覆盖的列包括:
WHERE过滤列JOIN ON关联列ORDER BY排序列GROUP BY分组列
其中最容易出错的是复合索引顺序。假设高频查询模式是:
WHERE user_id = ? AND status = 'active' ORDER BY create_time DESC那么索引就应围绕这个访问方式来设计,例如 idx_user_status_time。字段顺序如果随意颠倒,过滤和排序的收益都会打折,甚至让优化器放弃使用该索引。
避免 SELECT * 和函数操作把索引优势抹掉
视图里写 SELECT *,看起来省事,实际常常会拖累性能。原因很直接:返回列一多,覆盖索引更难成立,优化器即使能利用过滤索引,也可能因为要取额外字段而回表。
更稳妥的做法,是在视图定义中显式列出真正需要的字段。很多时候,哪怕只少取一列,也可能让原本需要回表的查询,变成可直接命中的覆盖索引查询。
另一个高频问题,是在索引列上直接套函数。例如:
WHERE YEAR(create_time) = 2024
WHERE UPPER(email) = 'A@B.COM'
这类写法会让优化器很难直接使用原字段上的普通索引。即使 create_time 或 email 已经建了索引,也可能失效,最终退化为全表扫描或低效扫描。
更好的改写方式,是把函数逻辑挪开,让条件重新落在原始列上。例如:
create_time >= '2024-01-01' AND create_time < '2025-01-01'这通常比 YEAR(create_time) = 2024 更容易命中索引,也更符合范围查询的优化路径。
如果业务上确实必须基于函数结果匹配,再考虑数据库是否支持函数索引。例如 PostgreSQL 可以为 LOWER(email) 建索引,MySQL 8.0+ 也支持函数索引。但这属于有条件使用的优化手段,前提仍然是先确认查询模式稳定、收益足够明确。
执行计划出现 Key Lookup、Sort 或 filesort 时要立即复核
有些视图查询看起来“已经走索引”,但性能依旧不理想,这时就不能只看有没有索引命中,还要看命中之后发生了什么。
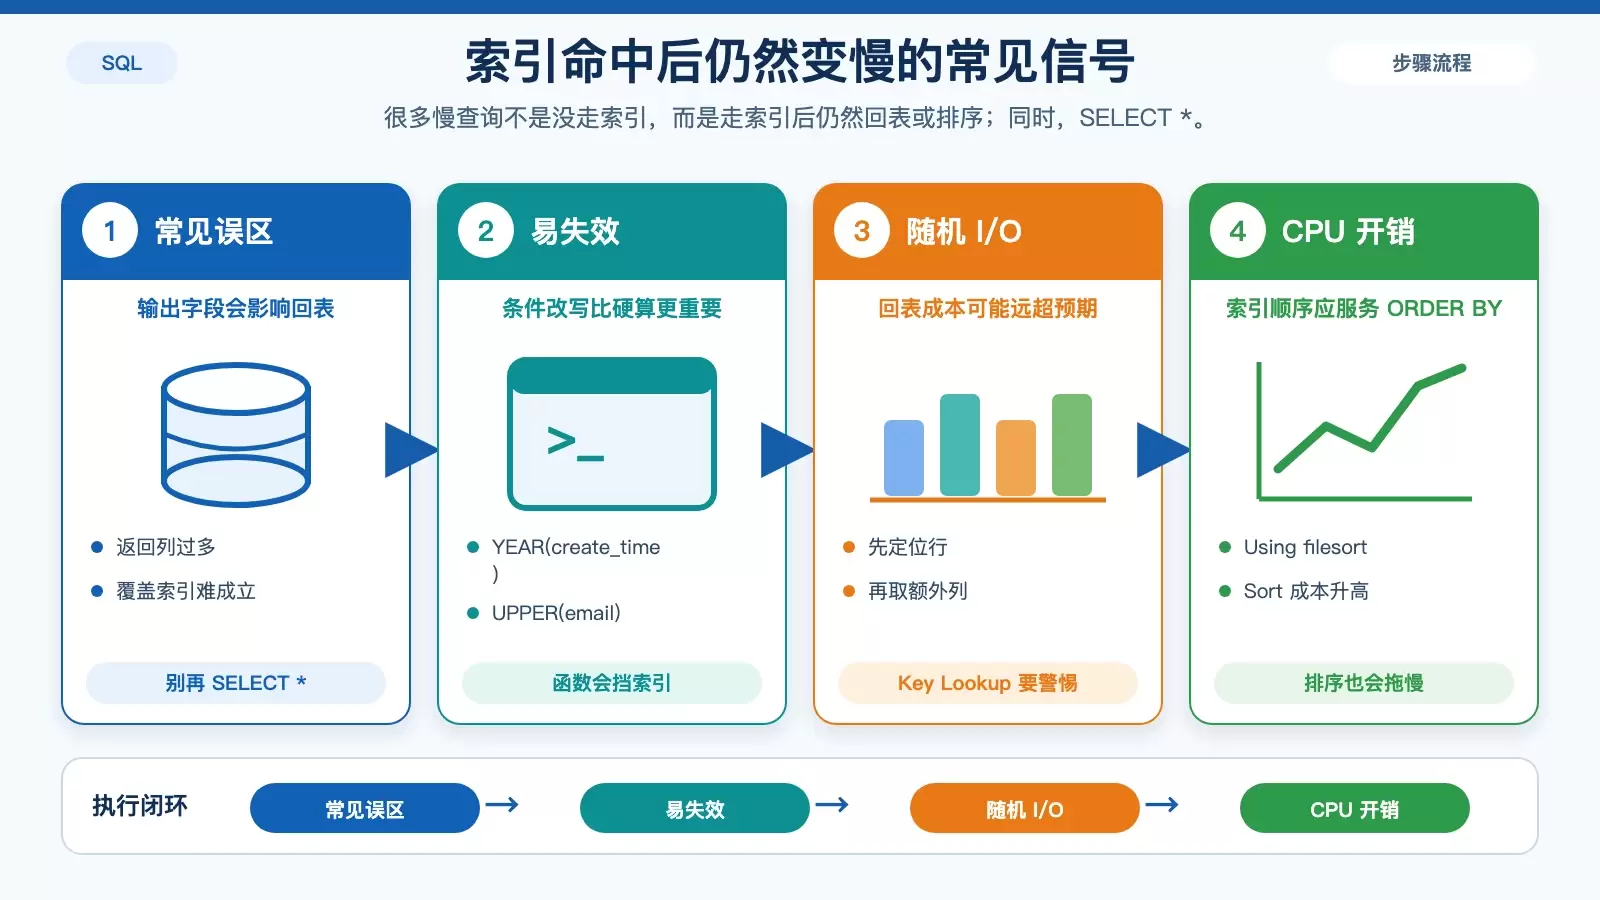
在 SQL Server 中,如果执行计划出现 Key Lookup,通常表示先用索引找到了记录位置,但还需要回表取其他列;在 MySQL 或 PostgreSQL 中,如果看到 Using filesort 或明显的 Sort 节点,也要提高警惕,因为额外排序会显著增加 CPU 和 I/O 成本。
例如,视图返回的是 name, email, phone, status,但现有索引只有 (status)。这时执行:
WHERE status = 'pending'数据库会先通过 status 索引定位目标行,再逐条回表取 name、email、phone。如果结果集达到百万级,就意味着可能发生百万次随机 I/O,代价会非常高。
解决思路通常有三类。
优先考虑覆盖索引
把查询真正要用到的列,一并纳入索引设计中。SQL Server 可以利用 INCLUDE,MySQL 则更常见通过联合索引把过滤列和输出列一起纳入考虑。这样做的目标,是让查询尽量在索引层完成,减少回表。
确认外部条件能否下推到视图内部
有些数据库可以把视图外层的 WHERE 条件继续下推到内部执行,从而更早过滤数据。但前提是视图定义本身没有阻断优化,例如包含 DISTINCT、UNION,或者聚合逻辑与分组方式使优化器难以安全下推条件。
尽量让索引顺序服务于 ORDER BY
如果执行计划里 Sort 成本很高,就需要检查排序是否能由索引顺序直接满足。只要过滤条件与排序条件设计得当,数据库就可能省掉额外排序步骤,尤其在分页和大结果集场景下收益明显。
视图过于复杂时,拆成 CTE 或物化方案通常更有效
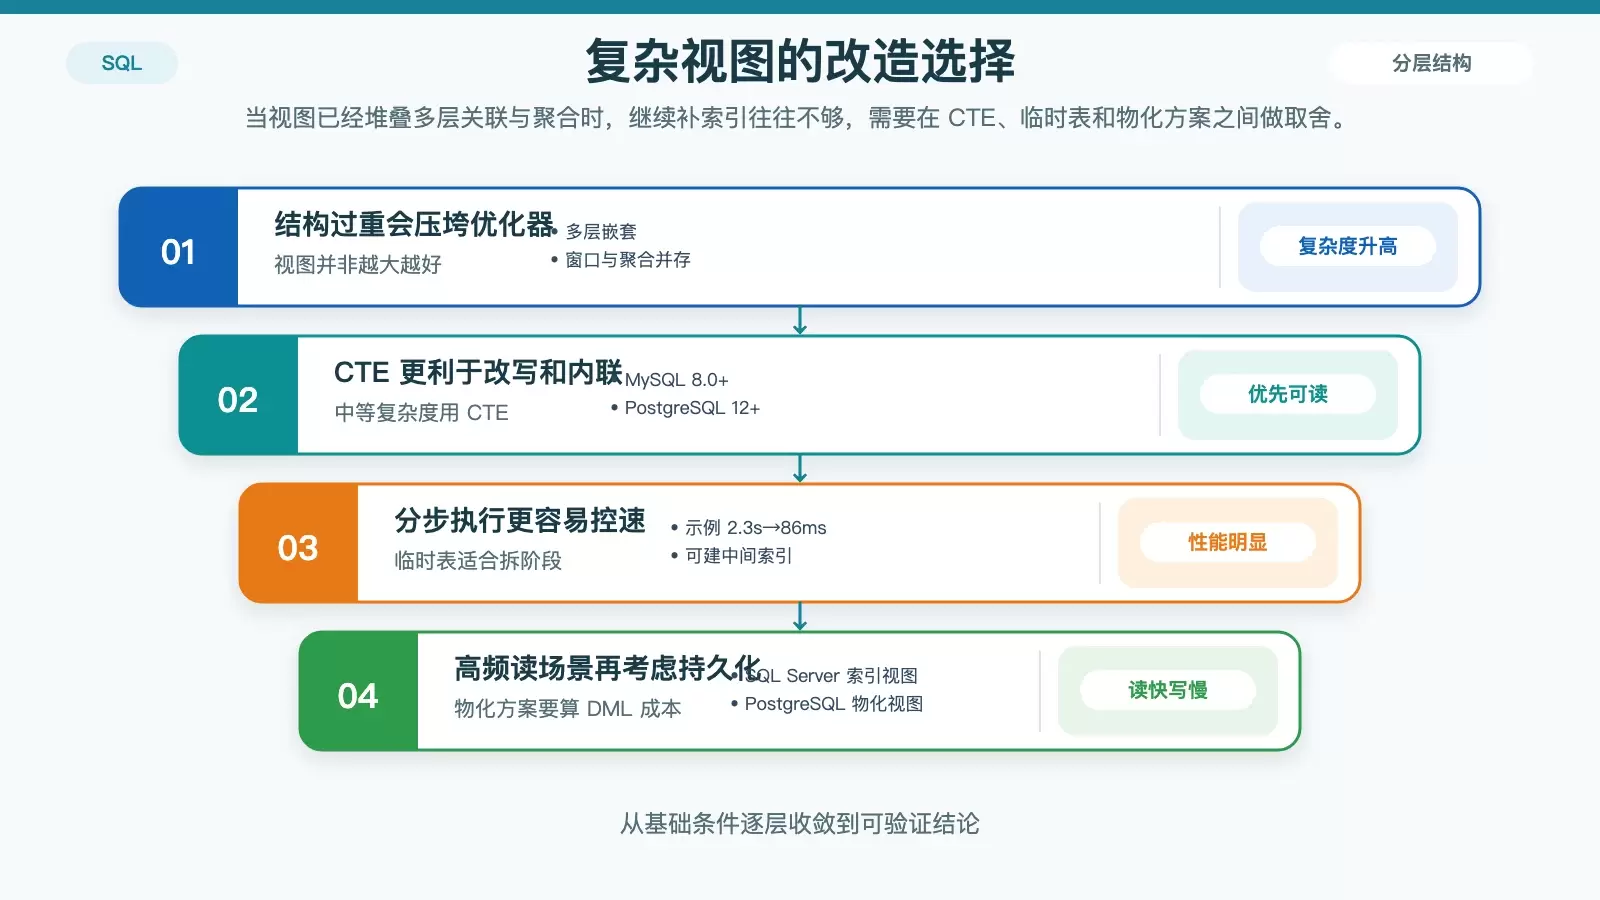
并不是所有查询都适合继续堆在一个视图里。当视图出现多层嵌套、多个 JOIN、UNION ALL、窗口函数或复杂聚合时,优化器生成高效执行计划的难度会明显上升,统计信息也更容易失真,最终导致索引利用率下降。
这类问题在报表、对账、金融分析类系统里尤其常见。一个包含 7 表关联和 3 层子查询的视图,查询耗时可能高达 2.3s;如果拆成带索引的中间临时表,可能降到 86ms;进一步改用 SQL Server 的索引视图或物化方案,甚至能稳定在 12ms,但同时也会带来写入延迟增加的问题。
因此,复杂视图的优化不只是“继续补索引”,还要判断这个结构本身是否已经不适合实时展开。
高频读、低频写:评估索引视图或物化视图
如果查询频繁、写入相对少,可以考虑 SQL Server 的索引视图,或 PostgreSQL 的物化视图。这类方案会真实存储结果,读取性能通常更稳定,但代价是插入、更新、删除时需要维护额外结构,DML 成本会上升。
中等复杂度:优先改写为 CTE
对于还没复杂到必须物化的查询,CTE 往往是更平衡的选项。它在可读性上通常优于深层嵌套视图,而在 MySQL 8.0+、PostgreSQL 12+ 这类现代优化器环境中,也经常能够被内联展开并继续利用索引。
真正复杂的报表逻辑:交给分步计算和缓存
如果一条视图里已经塞满多阶段计算、聚合和口径转换,继续把它留在数据库视图层往往只会让排障更困难。此时把逻辑拆到应用层分步执行,再配合缓存或中间结果表,通常更容易控制性能和稳定性。
索引不是一次性工作,最终要靠执行计划持续验证
视图优化最危险的误区,不是完全没建索引,而是“以为已经建了索引,所以一定快”。实际上,数据量变化、统计信息过期、参数分布偏移,都可能让昨天还能接受的执行计划在今天突然变慢。
因此,视图相关优化至少要形成一个基本闭环:
- 先看展开后的实际 SQL 访问路径
- 再检查索引是否覆盖了过滤、关联、排序和返回列
- 随后复核是否有函数、
SELECT *、回表、额外排序等隐性成本 - 最后判断是否需要把复杂视图改写为 CTE、临时表或物化方案
归根到底,视图只是查询的包装层。真正决定性能的,始终是基表索引设计、执行计划质量,以及这些优化是否经得起持续验证。















