



触发器递归调用的问题,难点从来不只是“会不会报错”,而是不同数据库的处理方式根本不一样:有的在语法阶段就拦住,有的会继续执行到更深层才出问题。本文把 MySQL、SQL Server、PostgreSQL 和 SQLite 的真实行为拆开说明,并给出对应的规避思路,方便你判断该用触发器内拦截、实例级开关,还是直接把后续写操作挪到队列或应用层。
不同数据库对触发器递归的处理差异
各数据库对“触发器直接修改自身监听表”的限制并不统一,这也是很多线上问题难以复现的根源。
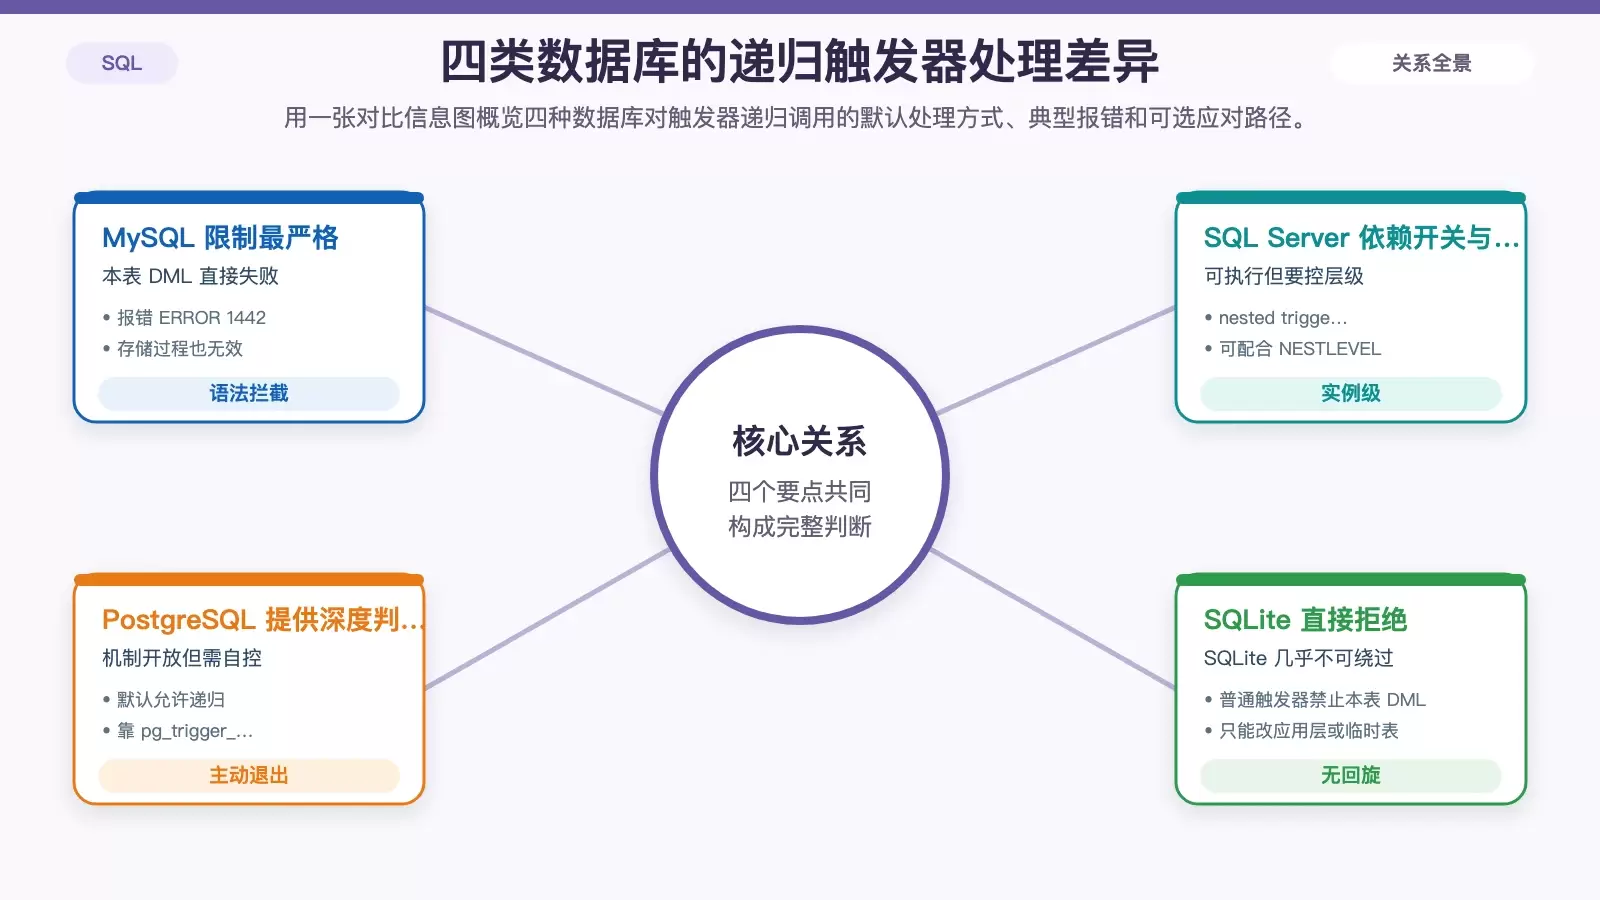
如果在触发器里直接对当前监听表执行 UPDATE、INSERT 或 DELETE:
- MySQL 会直接报
ERROR 1442 - SQL Server 可能继续进入嵌套触发流程,直到命中递归控制或出现更深层问题
- PostgreSQL 默认允许执行,但需要你自己用深度判断退出
- SQLite 会拒绝并报
cannot modify <table_name> because it is being used by trigger
这类现象通常不是权限、语法细节或某个配置忘了开关,而是数据库在执行上下文层面做出的硬性限制。要解决问题,先要确认你面对的是“禁止执行”“允许但需自控”,还是“完全不能绕过”。
MySQL:语法层直接拦截本表修改
MySQL 对这个问题的态度最直接:只要触发器体里出现对当前表的 DML,解析阶段就会拦截。哪怕只是更新当前行,也一样会失败。
例如下面这种思路,在 MySQL 里不会因为条件判断而放行:
UPDATE t SET x = 1 WHERE id = NEW.id触发器中只要包含这类写法,就会抛出 ERROR 1442。它不会去判断你是不是只更新一行,也不会因为加了 IF 条件就改变结果。
几个常见误区
RECURSIVE_TRIGGERS这个选项在 MySQL 中并不存在- 把
UPDATE封装到存储过程再从触发器里调用,仍然会报错 - 试图通过临时表、视图、子查询等方式间接写回本表,也会被拦住
MySQL 可行的处理方式
在 MySQL 下,真正可落地的思路不是“在触发器里继续改本表”,而是把后续动作拆出去。文中给出的唯一绕过路径是:
INSERT INTO event_queue也就是让触发器只负责写入事件队列,由外部消费者异步或串行处理后续业务逻辑。这样既绕开了语法层限制,也更容易审计后续操作链路。
SQL Server:靠实例开关和嵌套层级控制
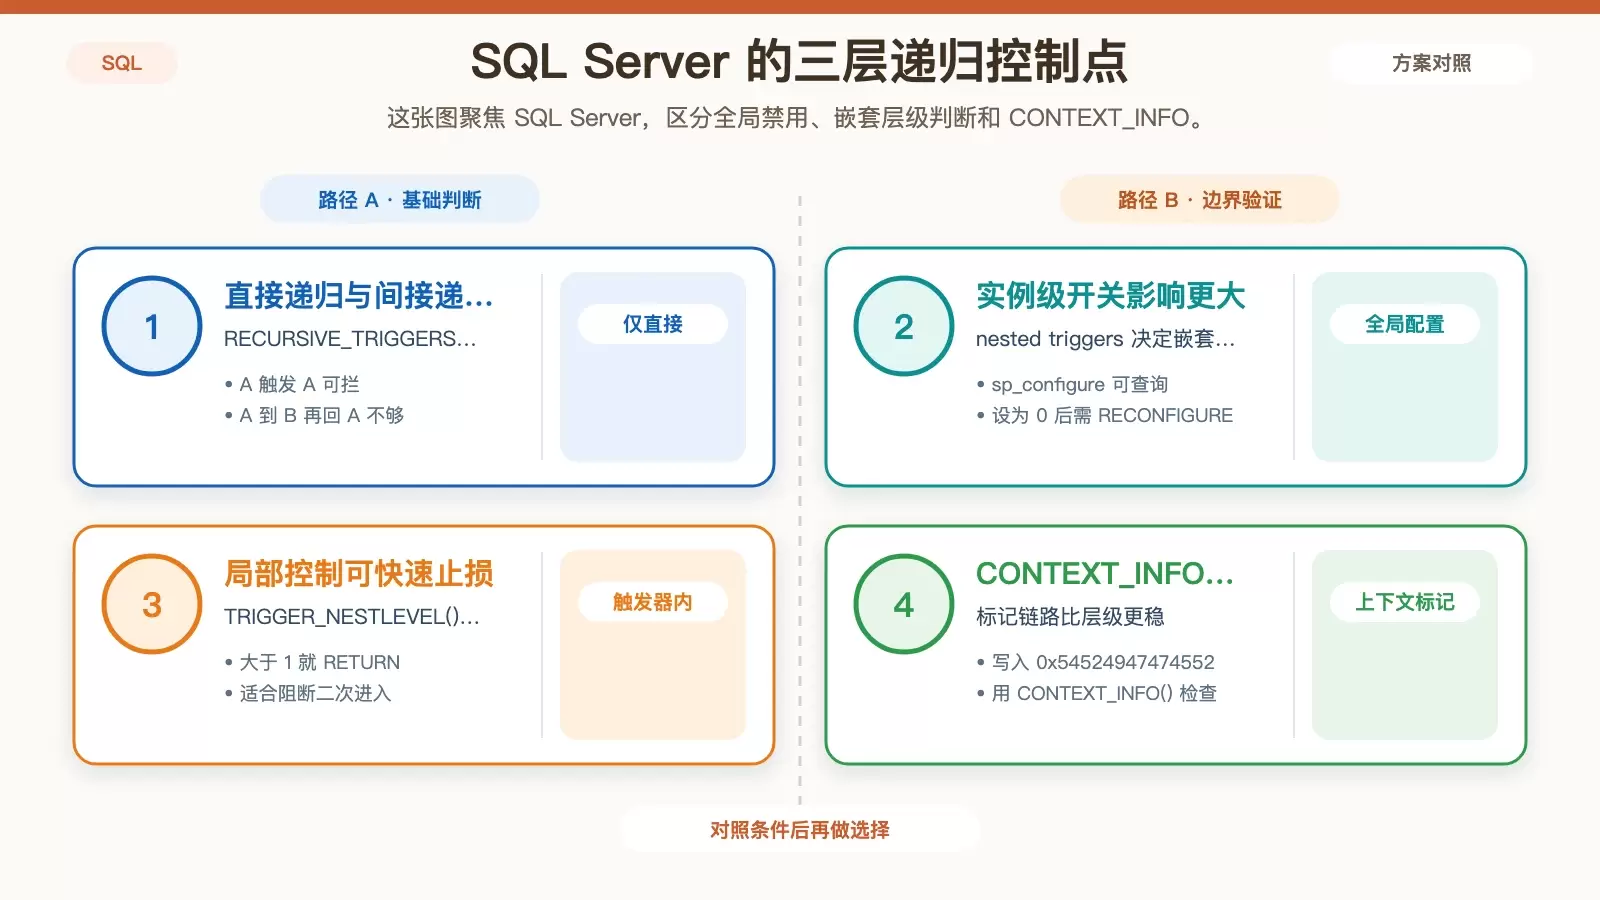
SQL Server 的情况比 MySQL 复杂,因为它不是一刀切禁止,而是允许一定程度的嵌套触发。问题在于,很多人只记得 RECURSIVE_TRIGGERS OFF,却忽略了它只能限制直接递归。
例如:
- A 表
INSERT触发 A 表的AFTER INSERT - 该触发器再次对 A 表执行
INSERT
这种直接递归,RECURSIVE_TRIGGERS OFF 能发挥作用。
但如果链路变成:
- A 表
INSERT - 触发器更新 B 表
- B 表的
AFTER UPDATE触发器再去更新 A 表
这就是间接递归,单靠 RECURSIVE_TRIGGERS OFF 并不够。真正影响更大的是实例级的 nested triggers 开关。
排查和控制命令
- 查看当前配置:
EXEC sp_configure 'nested triggers' - 返回
1表示启用 - 彻底禁用:
EXEC sp_configure 'nested triggers', 0; RECONFIGURE
触发器内的细粒度防护
如果不希望直接依赖全局配置,可以在触发器开头加上层级判断:
IF TRIGGER_NESTLEVEL() > 1 RETURN这种方式适合快速阻断二次进入,但它解决的是“当前已经嵌套到第几层”,并不直接表达业务上下文。
更稳妥的做法是给当前执行链路打标记。文中给出的方案是:
SET CONTEXT_INFO 0x54524947474552这里的十六进制值对应字符串 "TRIGGER"。在触发器里再通过 CONTEXT_INFO() 检查,可以避免字符串转换截断问题。对于跨表联动较多、触发链条更长的场景,这种方式通常比只看嵌套层数更可靠。
PostgreSQL 与 SQLite:一个可控,一个几乎没有回旋空间
PostgreSQL 和 SQLite 在这个问题上的差异也很大。PostgreSQL 默认不禁止递归,SQLite 则基本是硬性拒绝。
PostgreSQL:允许递归,但要主动退出
PostgreSQL 提供了 pg_trigger_depth(),可以在触发器内部判断当前递归深度。常见写法是:
IF pg_trigger_depth() > 1 THEN RETURN NEW; END IF;这类判断通常还要配合 TG_OP 做事件类型过滤,这样才能避免不同操作类型共用同一触发器时出现误拦截。
换句话说,PostgreSQL 不是帮你彻底禁掉风险,而是给了你一个明确的刹车点。能不能控制住,取决于触发器条件设计是否足够清晰。
SQLite:普通触发器里不能改本表
SQLite 的限制最硬。对于普通 AFTER 触发器,只要尝试对本表做 DML,就会被直接拒绝。
这里有一个常见误解需要排除:PRAGMA recursive_triggers = ON 并不能让普通触发器获得递归修改本表的能力,它只影响 INSTEAD OF 触发器,对这里讨论的场景无效。
因此,SQLite 的可行方案基本只剩两类:
- 把逻辑提升到应用层事务中统一执行
- 先写入临时表,例如
INSERT INTO temp.pending_updates,再由外部批量处理
如果你的业务必须依赖复杂的表内自更新链路,SQLite 通常不是适合承载这段逻辑的位置。
真正要防的不是开关,而是隐性递归链路
无论用的是 CONTEXT_INFO、session 变量还是临时表,所有运行时标记方案都依赖上下文保持一致。一旦连接池复用、事务异常中断未清理,或者存储过程发生嵌套调用,原本用来防重入的标记就可能失效。
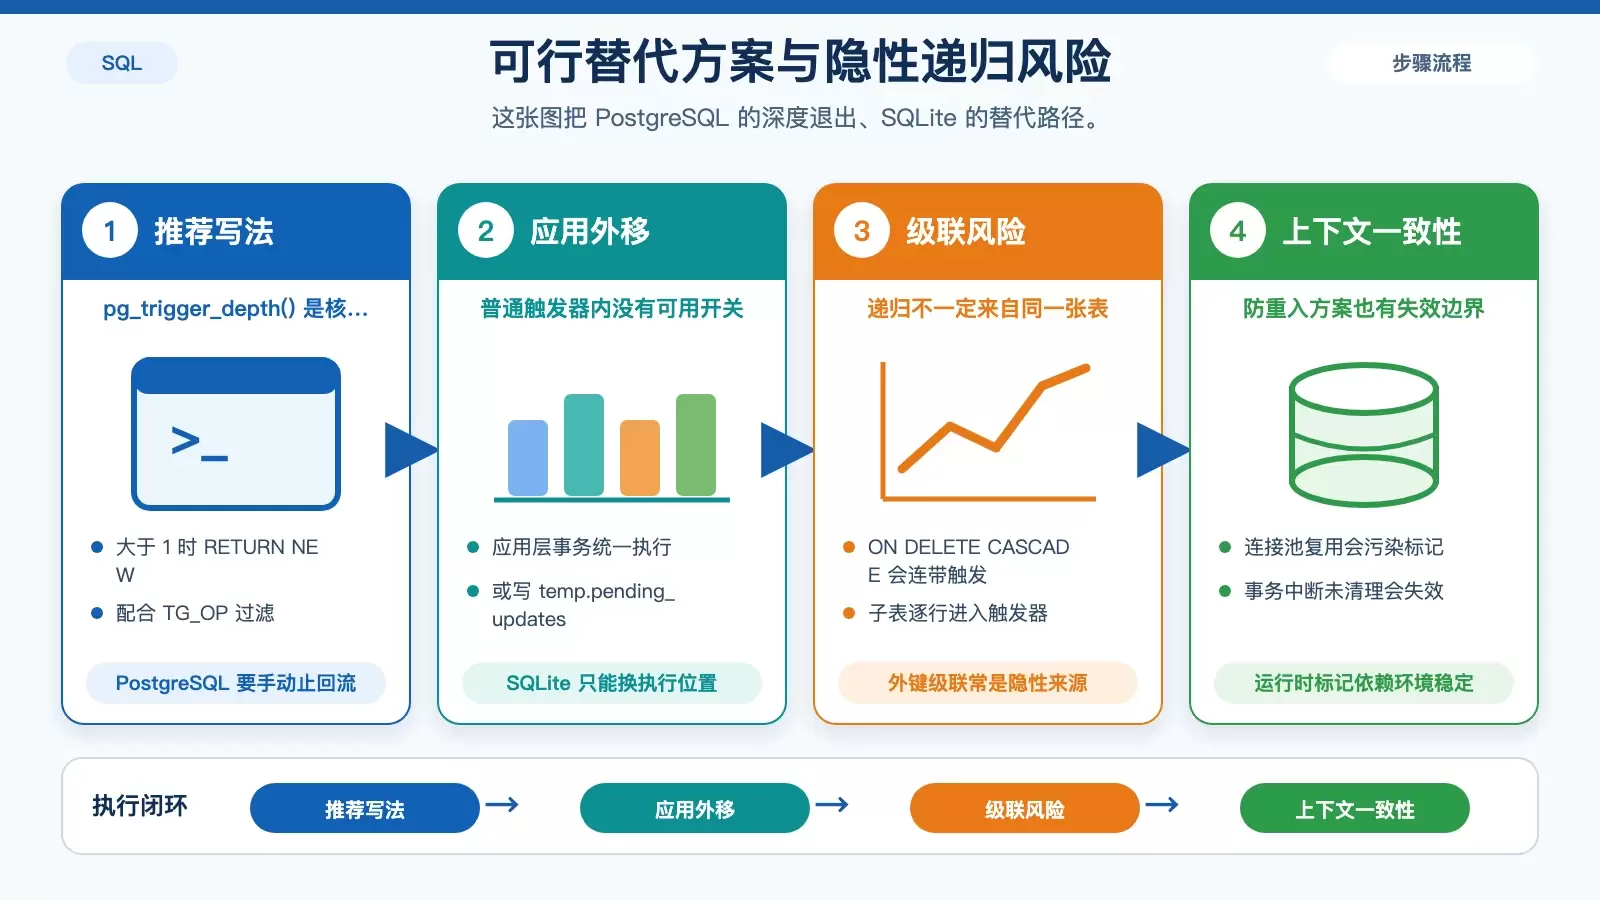
这也是为什么触发器递归问题很少是“把某个参数改一下”就能彻底解决。真正需要确认的是:谁会在什么条件下再次激活同一个触发器。
- 业务逻辑调整后,新的写入路径可能绕过原有判断
- DBA 手工补数据时,可能触发平时不会走到的链路
- 迁移脚本、批量修复脚本也可能把递归条件重新点燃
- 外键级联如
ON DELETE CASCADE与触发器共存时,子表每删一行都可能触发一次逻辑,这是常被忽略的隐性递归源
如果一个系统里已经存在跨表更新、级联删除和多层触发器,最稳妥的判断标准通常不是“数据库支不支持递归”,而是“这段逻辑是否值得继续放在触发器里”。当触发链过长、上下文标记难以维护时,把后续写操作迁移到应用层或事件队列,往往更容易得到可预测的执行结果。















