SQL Server日期函数实战:格式化、运算与时区处理详解
本文详解SQL Server中处理日期的核心函数。重点解析传统CONVERT()与现代FORMAT()在日期格式控制上的差异,演示EOMonth获取月末、DATEFROMPARTS构建日期等常用操作,并提供时区切换、周几判断及按时间段查询数据的实用SQL代码示例。



本文详解SQL Server中处理日期的核心函数。重点解析传统CONVERT()与现代FORMAT()在日期格式控制上的差异,演示EOMonth获取月末、DATEFROMPARTS构建日期等常用操作,并提供时区切换、周几判断及按时间段查询数据的实用SQL代码示例。
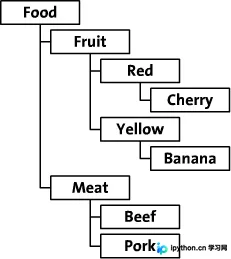
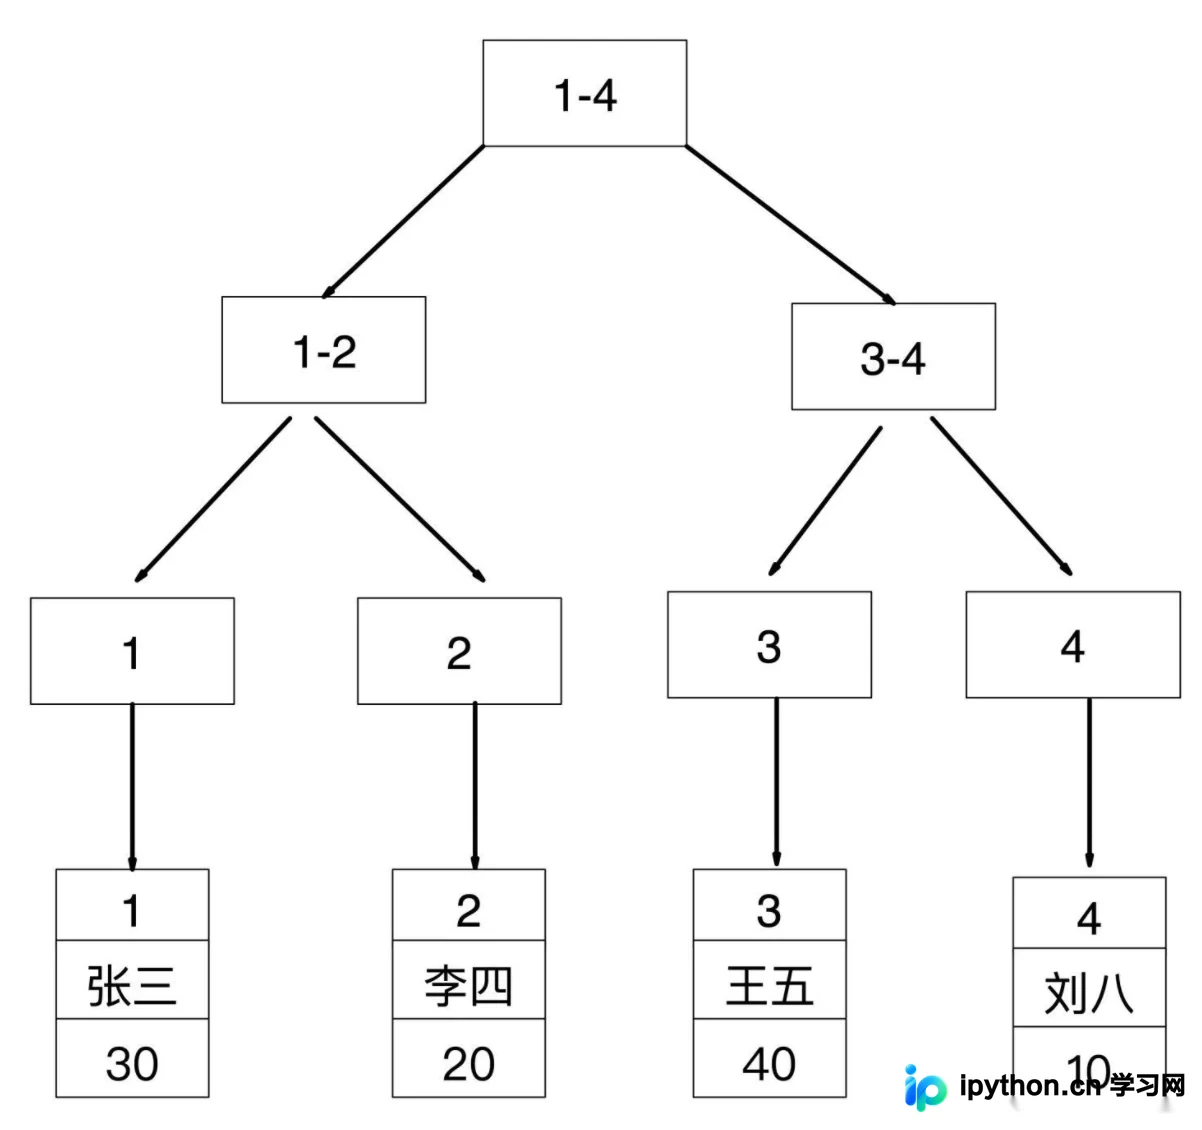
在关系型数据库中存储树形结构通常面临查询效率与数据冗余的权衡。本文对比两种主流方案:直观的邻接表模型适合小规模数据,而基于前序遍历的扩展预排序遍历树(左右值编码)通过数字区间优化了深层递归查询。文章详细解析了左右值模型的SQL CRUD操作逻辑及存储过程实现,帮助开发者根据业务场景选择最佳存储策略。
本文梳理MySQL中复杂的日期区间查询技巧,重点指出DATE_FORMAT导致索引失效的问题并提供优化方案。汇总now、curdate等时间获取函数,以及date_format、str_to_date转换方法,并结合date_add、datediff计算周期数据,提升SQL查询效率。
本文详解 MySQL 中回表(二次查询)导致的性能损耗机制,以及利用覆盖索引实现“只查索引”的优化策略。通过对比聚簇索引与普通二级索引的执行过程,结合 EXPLAIN 结果分析,展示如何通过联合索引避免回表,提升 SQL 执行效率并降低全表扫描风险。
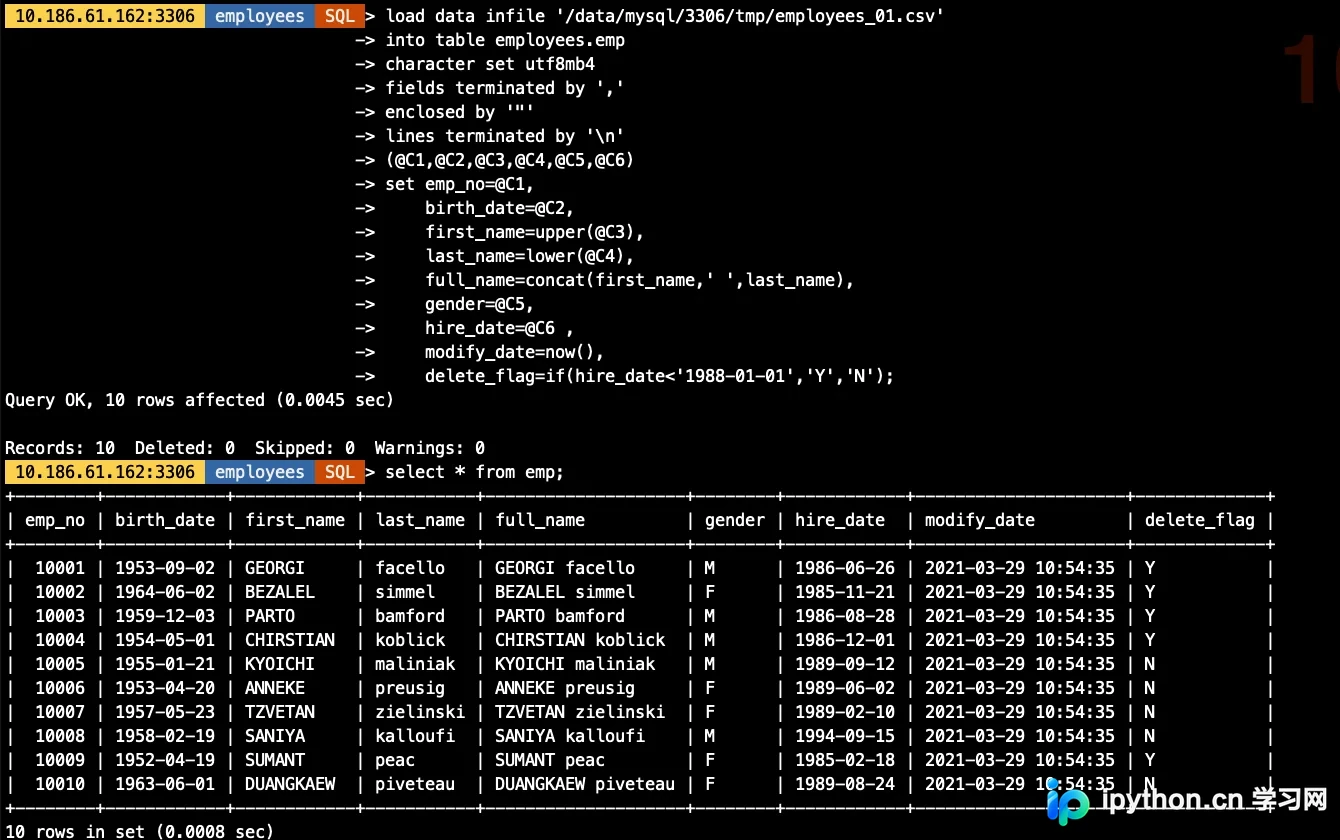
本文详解MySQL Shell中Parallel Table Import Utility(import_table)的使用。该工具支持8.0.23及以上版本,具备并发导入、多文件通配符匹配、限速及压缩文件处理等核心功能。通过具体代码示例,展示如何利用decodeColumns实现字段映射、函数处理及逻辑判断,并与传统LOAD DATA INFILE进行性能对比,证明其在大数据量导入场景下的显著效率优势。
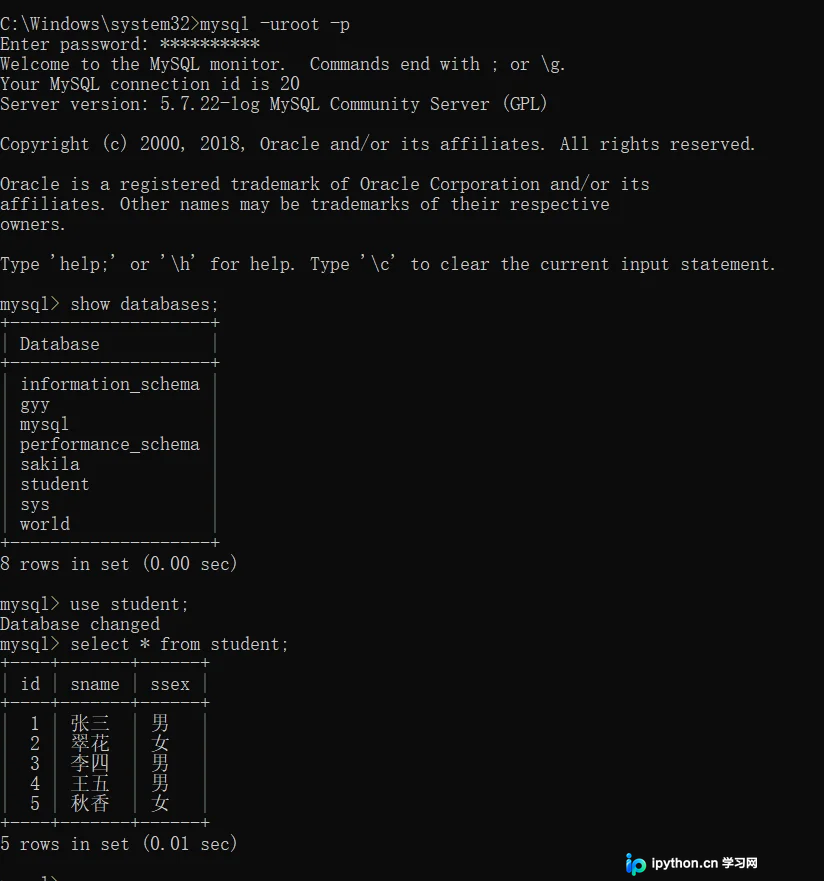
本文详细讲解MySQL数据库的备份与还原方法。首先介绍mysqldump工具的使用,通过命令行将指定数据库导出为SQL文件;随后演示如何删除库并新建同名库,利用source命令在MySQL客户端内完成数据导入,确保业务数据的安全性与可恢复性。
本文详解SQL Server中两种常用的表数据复制语句:INSERT INTO SELECT和SELECT INTO。前者需目标表已存在,支持指定列或全部列复制;后者自动创建目标表,但要求目标表不存在且通常只能执行一次。通过具体代码案例对比两者优先级、适用场景及语法细节,帮助开发者高效进行数据备份与迁移。
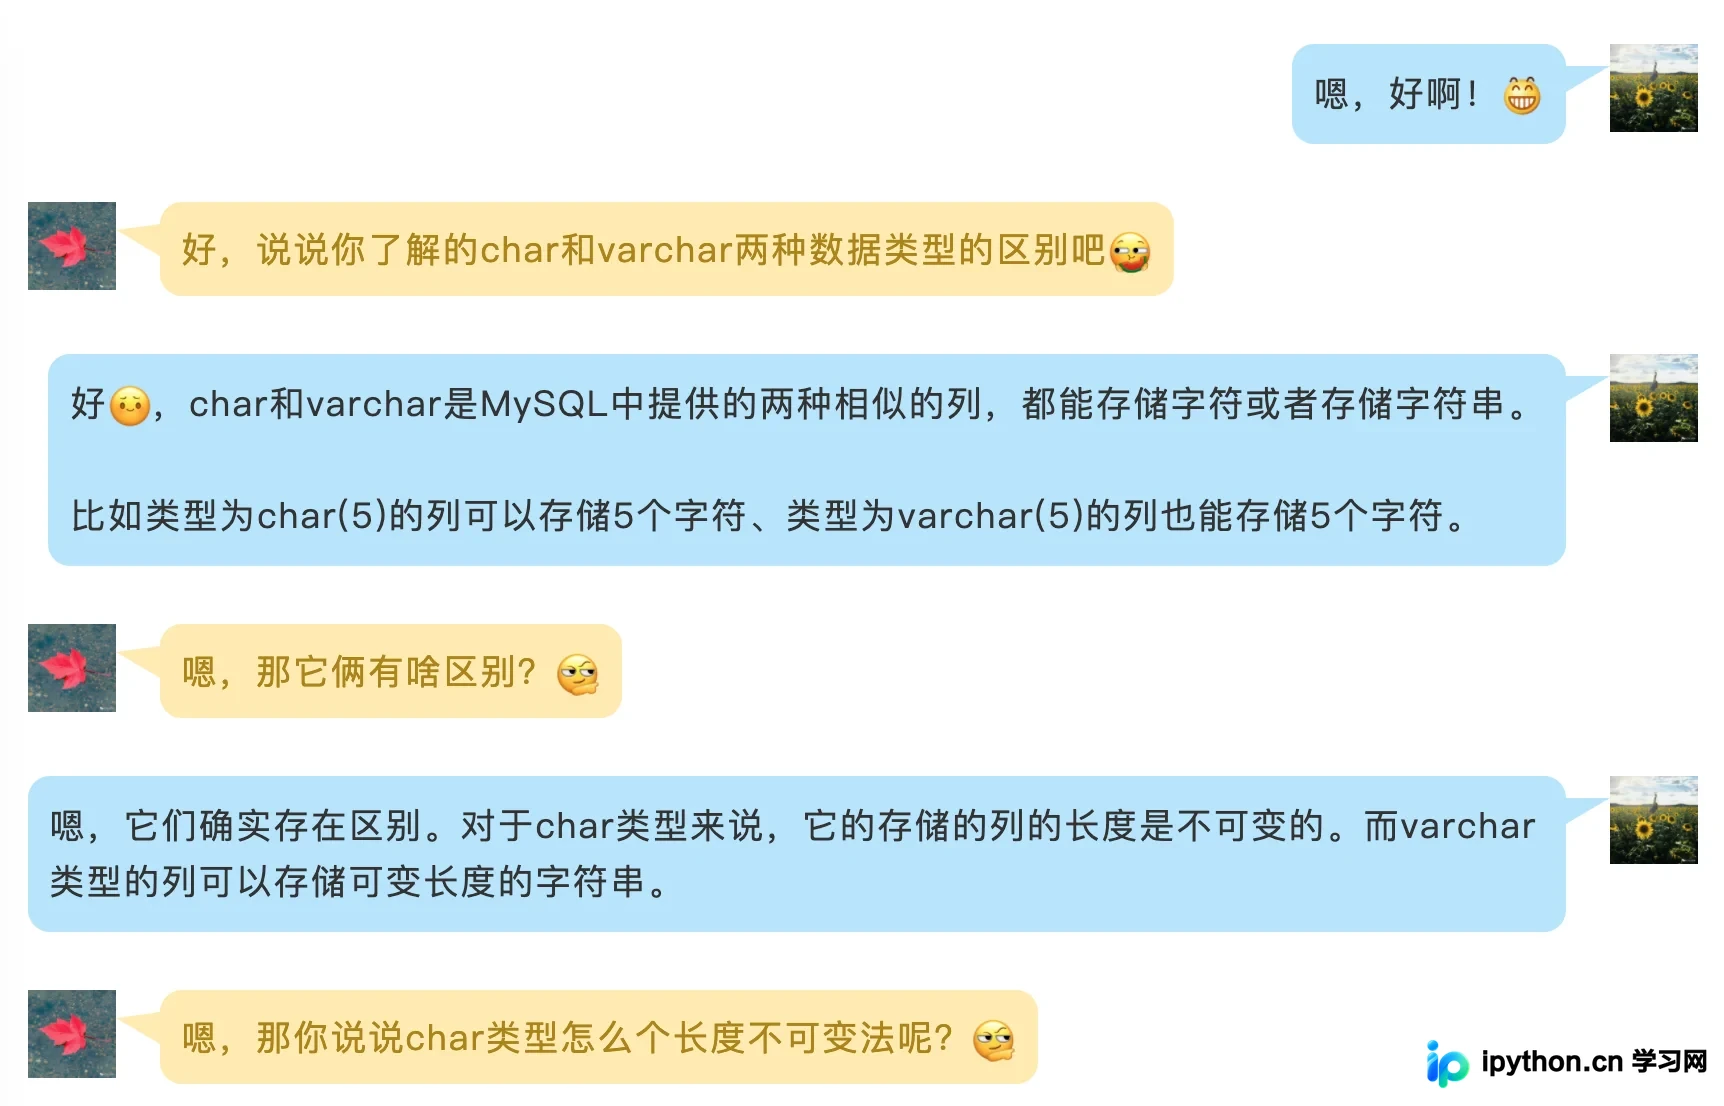
在MySQL中,CHAR是固定长度字符类型,不足补空格;VARCHAR是可变长度,仅存实际内容加1-2字节头信息。CHAR适合定长且短小的数据如MD5哈希,查询速度快;VARCHAR适合不定长文本以节省空间。合理选择能显著提升存储空间利用率与I/O效率,避免不必要的资源浪费。
本文详细介绍MySQL中LOCATE和POSITION函数的用法,涵盖基本语法、参数说明及大小写敏感特性。通过具体SQL示例演示如何查找子串首次出现位置及指定起始位置后的索引,帮助开发者高效处理字符串匹配查询任务。
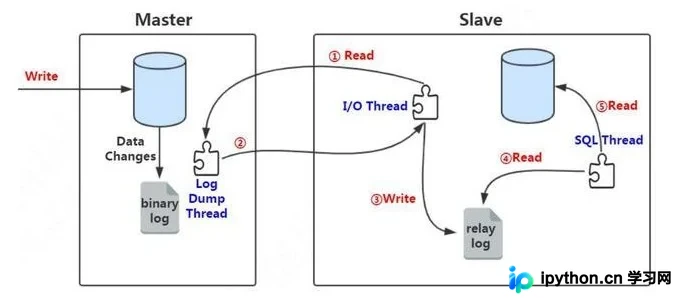
本文详细解析MySQL主从复制中实现数据过滤的两种核心思路。重点讲解为何推荐在从库而非主库进行过滤,并通过CHANGE REPLICATION FILTER命令展示具体的过滤配置步骤(包括库级与表级过滤)。同时提供GTID模式下解决因表结构不一致导致的SQL线程报错及自动恢复方案。
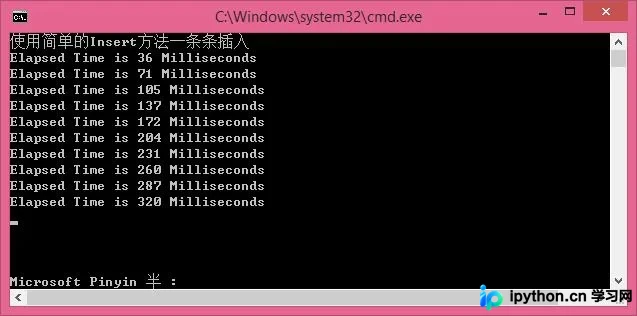
针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
在 SQL Server 中无法直接使用类似 Oracle 的 rownum 来删除前 N 行。本文介绍了三种实现方式:利用 CTE 配合 ROW_NUMBER() 函数(推荐,无需建表)、通过创建临时视图或临时表删除、以及直接删除 Top N 记录(需注意去重风险)。重点说明如何通过排序字段确保删除的是真正的前N条业务数据,避免误删。