



很多人第一次遇到日期转换问题,往往会觉得是 SQL 语法写错了,但真正的问题通常出在“数据库怎么理解这段字符串”。同样一条 CAST(... AS DATE),在 SQL Server、PostgreSQL、MySQL 里可能得到不同结果,甚至一个报错、一个返回 NULL、一个还能查出错数据。下面就按几类最常见的场景拆开看,判断标准也很明确:先看字符串格式是否可被稳定解析,再看转换是否会吞错,最后看写法会不会拖垮查询性能。
为什么同一条 CAST 在不同数据库里结果不一样
CAST('03/08/2026' AS DATE) 在不同数据库中的表现并不一致,原因不是语法差异,而是各库对日期字符串的默认解析规则不同。
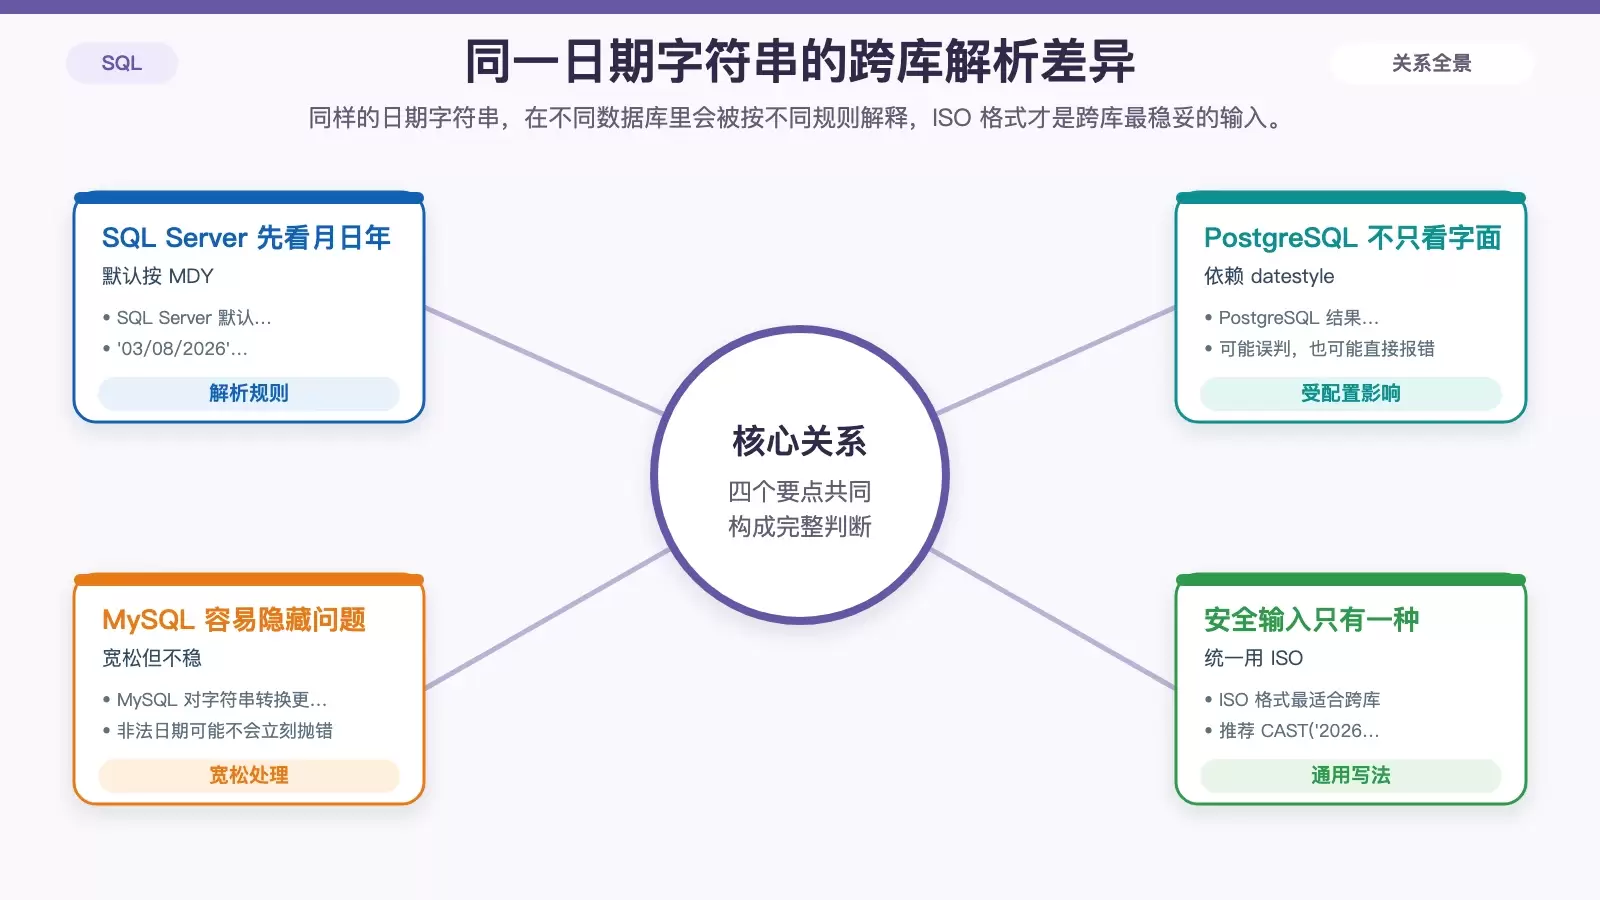
SQL Server 默认按 MDY(月/日/年)理解这类字符串,所以 '03/08/2026' 会被识别为 3 月 8 日。PostgreSQL 虽然默认更接近 YMD 习惯,但最终结果仍会受到 datestyle 设置影响,可能误判,也可能直接报错。MySQL 对这类转换通常更宽松,但宽松不等于可靠。
这里最关键的一点是:CAST 不负责“猜格式”,它只会按数据库既有规则做类型映射。只要输入不是明确、统一的日期格式,就不能指望它稳定工作。
真正安全的写法只有一种:
CAST('2026-08-03' AS DATE)这是主流数据库普遍接受的 ISO 格式,跨库时最值得优先使用。像 '08.03.2026'、'03-08-2026'、'03/08/2026' 这类带分隔符但不是 ISO 标准的写法,基本都不该直接交给 CAST。
如果业务输入已经固定成某种地区格式,就不要继续依赖通用转换。比如在 SQL Server 里,可以显式指定格式:
CONVERT(DATE, '03/08/2026', 103)这能强制按 DD/MM/YYYY 解析,但要注意,这种写法不可跨库,迁移到 PostgreSQL 或 MySQL 后不能直接复用。
非法日期返回 NULL,比直接报错更难排查
另一类更隐蔽的问题是,字符串看上去像日期,但其实值本身无效,例如:
CAST('2026-13-01' AS DATE)这类输入在不同数据库里的处理方式也不同。SQL Server 通常会直接中断并报 Msg 241,问题比较容易暴露;而 MySQL 与 PostgreSQL 在某些场景下可能返回 NULL,这反而更危险,因为查询不会失败,只会悄悄少数据。
这种情况下,定位问题不能只靠 CAST 的结果,而要先把可疑数据筛出来。常见做法是先校验格式,再做转换。
MySQL 可以先用正则过滤:
WHERE col NOT REGEXP '^\d{4}-(0[1-9]|1[0-2])-(0[1-9]|[12][0-9]|3[01])$'PostgreSQL 对应写法是:
WHERE col ~ '^\d{4}-(0[1-9]|1[0-2])-(0[1-9]|[12][0-9]|3[01])$'SQL Server 更适合直接找出转换失败的行:
TRY_CAST(col AS DATE) IS NULL AND col IS NOT NULL这几种方法都不是为了替代最终转换,而是为了把脏数据暴露出来,避免错误被静默吞掉。
还有一个经常被忽略的细节:失败原因不一定是“日期值错了”,也可能是字符串里混入了空格、不可见字符,甚至全角数字。例如 U+0000 这类不可见字符就可能让本来看似正常的数据转换失败。因此在校验前最好先做一次清理:
TRIM(col)先清洗、再匹配、最后转换,通常比直接把原始字符串丢给 CAST 更可控。
为什么 WHERE 里写 CAST 会影响结果和性能
很多人排查日期查询时,会写出类似语句:
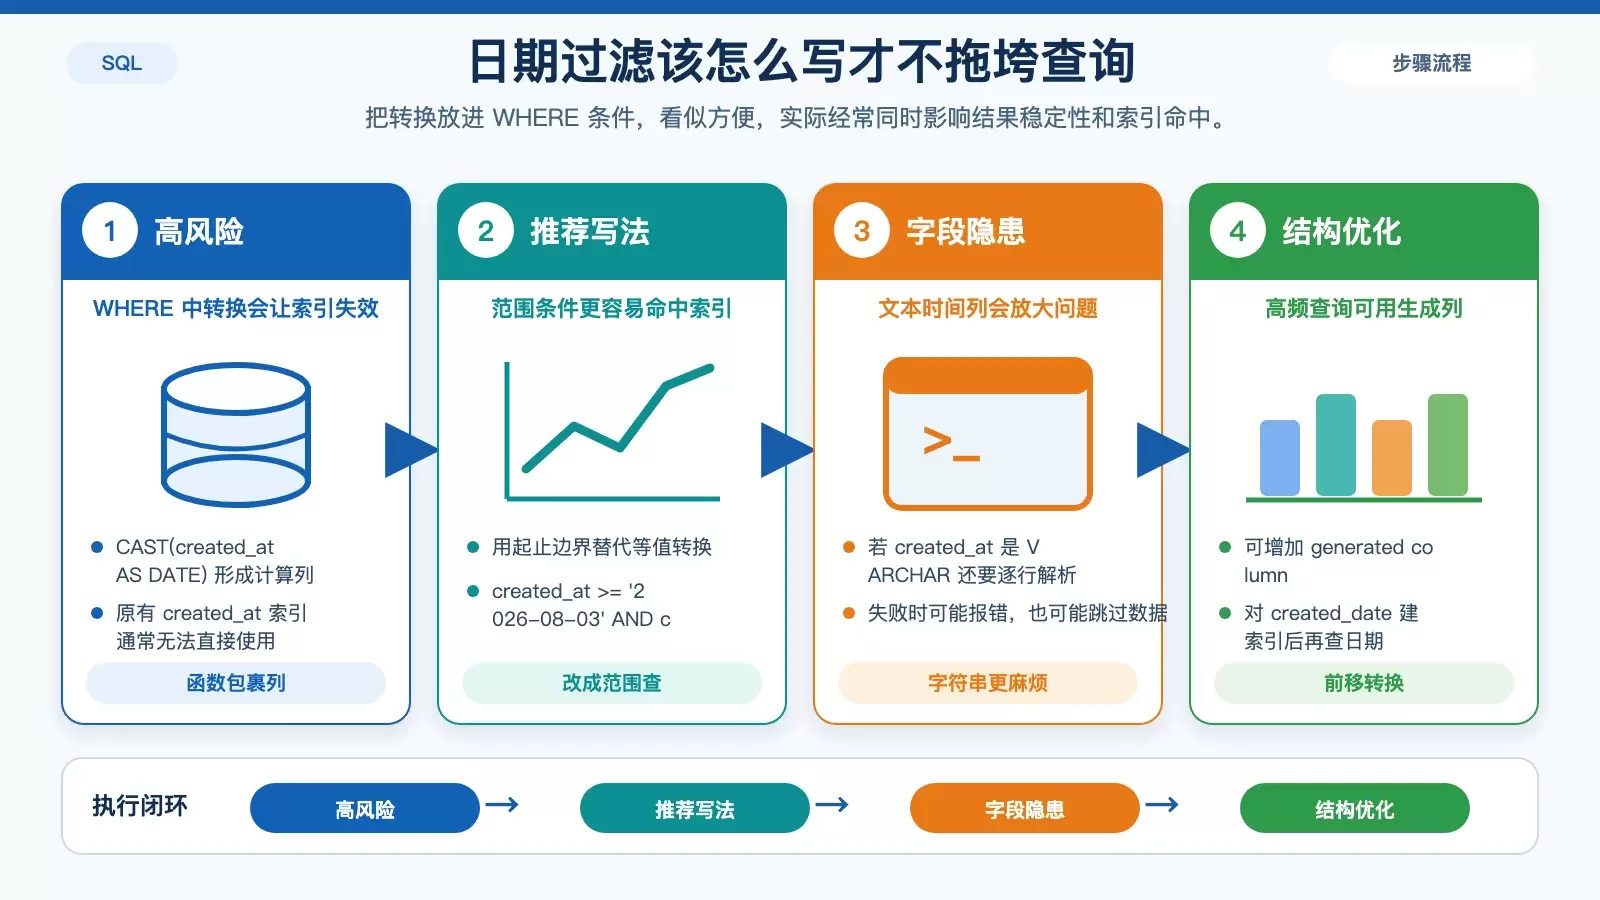
WHERE CAST(created_at AS DATE) = '2026-08-03'表里明明有 '2026-08-03 14:22:05',却查不出预期结果,或者查询突然变慢。这里通常不是 CAST 语法本身的问题,而是两个更实际的影响叠在一起:索引失效,以及隐式或显式的类型转换成本。
CAST(created_at AS DATE) 会把原列变成计算表达式。只要在列上包了一层函数,数据库通常就没法直接利用 created_at 原有索引,结果往往只能走全表扫描。数据量一大,性能问题就会立刻放大。
如果 created_at 本身还是 VARCHAR,情况会更复杂。数据库需要先把字符串逐行解析成日期或时间,再参与比较;解析失败时,有的数据库会报错,有的则会直接跳过该行或返回空结果,排查起来很费时间。
更稳妥的写法是范围查询:
WHERE created_at >= '2026-08-03' AND created_at < '2026-08-04'这类条件更容易命中索引,也避免了在查询阶段对每一行做函数计算。
如果字段确实以字符串形式存储,而且又需要高频按日期过滤,可以考虑在表中增加生成列,把转换前移:
ALTER TABLE t ADD created_date DATE GENERATED ALWAYS AS (CAST(created_at AS DATE)) STORED再针对 created_date 建索引,这样既能保留原始字段,也能让按日期查询回到可优化的路径上。
一个简单判断标准是:凡是出现在 WHERE 条件里的日期转换函数,都值得先怀疑性能和稳定性。尤其是线上表数据量较大时,尽量不要把日期解析留到查询时再做。
带时区或毫秒的字符串,别指望 CAST 直接兜底
再往前走一步,很多业务里拿到的并不是纯日期,而是完整时间戳,例如:
'2026-08-03T12:00:00.123Z'
'2026-08-03 12:00:00+08'
这类字符串看上去“已经很标准”,但并不意味着可以直接用原生 CAST 无脑转换。问题不在于格式粗糙,而在于它们已经超出 CAST 只做基础类型映射的能力边界。
面对带毫秒、时区偏移、UTC 标记的字符串,各数据库通常都需要专门函数处理,而不是靠简单的 CAST(... AS DATE) 或 CAST(... AS DATETIME) 自动识别。
SQL Server 常见做法是:
TRY_CONVERT(datetimeoffset, col)或者:
PARSE(col AS datetime2 USING 'en-US')PostgreSQL 可以使用严格模板匹配:
TO_TIMESTAMP(col, 'YYYY-MM-DD"T"HH24:MI:SS.US"Z"')这里模板必须和原始字符串完全对应,少一个字符或分隔符不同,都可能失败。
MySQL 的常见写法是:
STR_TO_DATE(col, '%Y-%m-%dT%h:%i:%s.%fZ')但在实际使用前,还需要确认具体版本是否支持微秒解析,否则结果可能不符合预期。
如果这类字段是持续入库的数据,最稳妥的策略仍然不是“查询时补救”,而是入库前统一清洗成标准 ISO 日期时间字符串。把格式归一化放到数据进入系统之前,后面的查询、过滤、统计才会稳定。
实务里可以直接套用的判断规则
把上面几类问题归纳一下,日期转换是否可靠,基本可以按下面几个标准快速判断。
1. 先看输入是不是 ISO 格式
如果不是 YYYY-MM-DD 这样的标准格式,就不要默认认为 CAST 一定能跨库工作。越依赖地区写法、分隔符写法,结果越不可预测。
2. 再看数据库失败时是报错还是返回 NULL
直接报错虽然会打断查询,但更容易发现;静默返回 NULL 才是更危险的情况,因为它会把数据质量问题伪装成“正常的空结果”。
3. 查询条件里尽量别对列做日期转换
尤其是 WHERE CAST(col AS DATE) = ... 这类写法,往往意味着索引无法利用,数据一多就会退化为扫描。
4. 复杂时间串要用专用解析函数
时区、毫秒、T 分隔符、Z 标记,都不是原生 CAST 擅长处理的对象。该用 CONVERT、TRY_CONVERT、TO_TIMESTAMP、STR_TO_DATE 时,不要硬套统一写法。
一句话总结:CAST 适合处理已经规范化的数据,不适合替代数据清洗。只要输入格式不统一、字段类型不干净,或者查询还想兼顾性能,就不该把希望放在它“自动理解”字符串这件事上。















