



当一条 SQL 已经套到三层以上时,继续往里包子查询,风险通常比收益更大:有的库会在解析阶段就因递归深度或栈空间限制报错,有的则是在数据量上来后突然超时。更稳妥的做法,是把“中间结果怎么产生、哪些步骤需要复用、哪里该建索引”拆开来看,分别用 CTE、临时表、JOIN 重写或中间表断链来处理,这样才能判断改写后到底是更快了,还是只是表面上变平了。
CTE 不是语法糖,关键在于中间结果能否明确落地
嵌套超过三层的子查询,通常就该进入重构范围了。这不是单纯的代码风格问题,而是要避免查询在下一次数据量翻倍后突然变慢,甚至在编译前就失败。MySQL 解析器栈空间有限,PostgreSQL 和 SQL Server 也都有明确的递归深度约束,超过限制后可能直接拒绝编译,连 EXPLAIN 都跑不出来。像 ERROR 1038 (HY001): Out of sort memory 这类问题,就可能出现在解析阶段,而不是执行阶段。
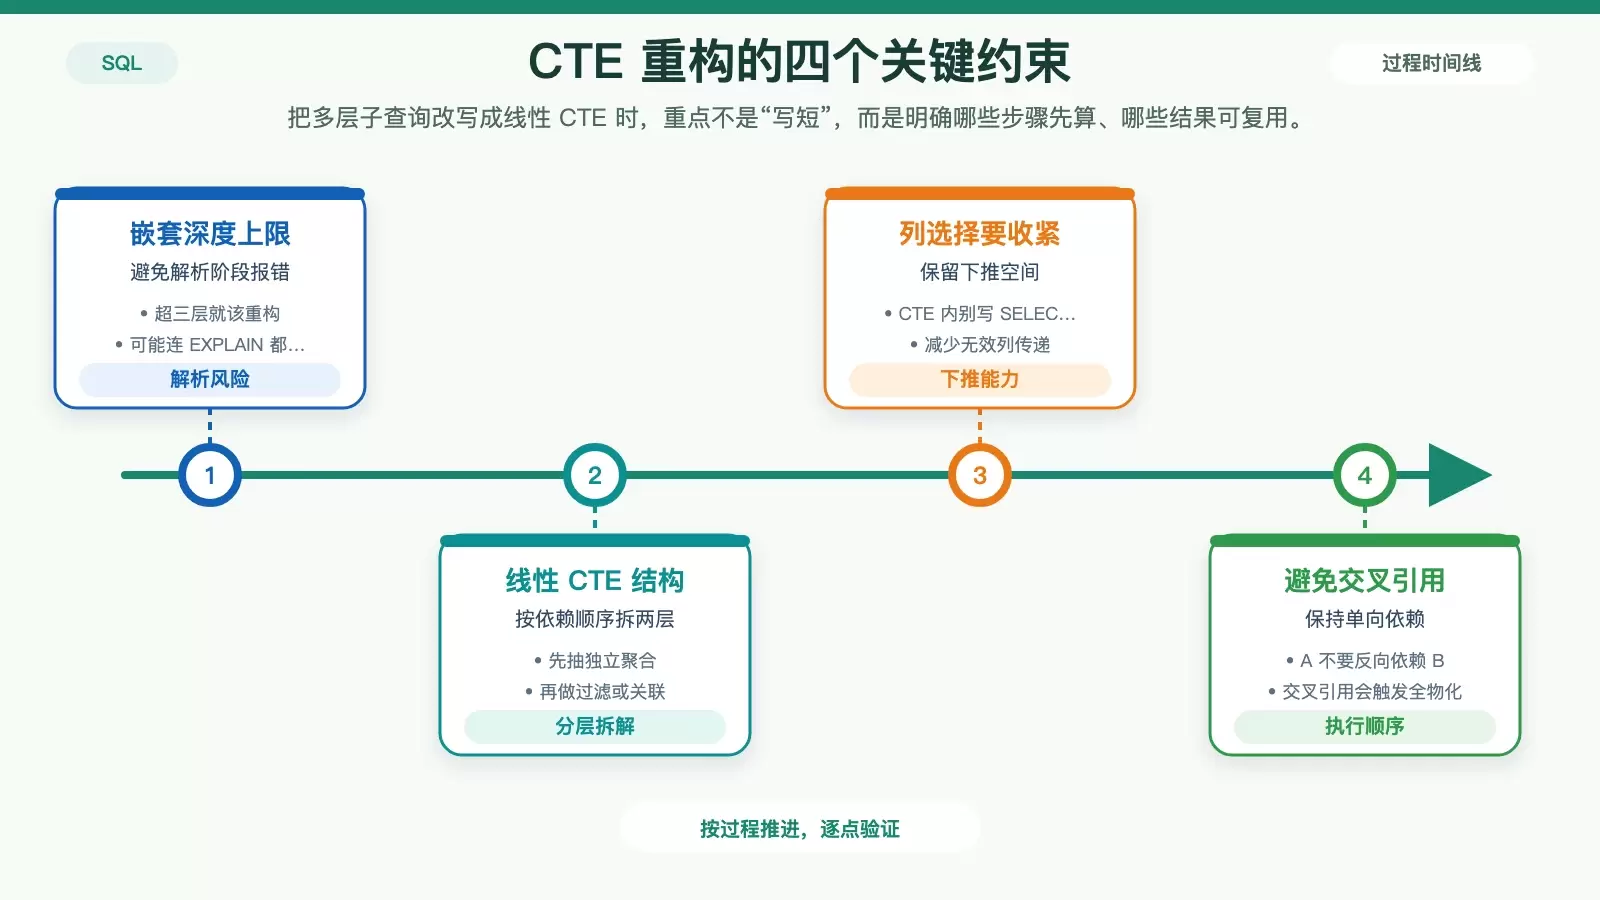
CTE 的价值,不是为了把 SQL 写短,而是向优化器明确表达:这段逻辑先算出一个中间结果,后面再引用。它本质上是一种“先声明、再复用”的结构化写法。但要注意,WITH 并不天然等于强制物化:
- PostgreSQL 默认更倾向把 CTE 视作物化边界。
- MySQL 8.0+ 如果需要显式控制,通常要借助
MATERIALIZED提示。 - SQL Server 是否物化,更多依赖统计信息和查询复杂度,由优化器自行决定。
因此,重构时应该先把那些不依赖外层上下文的计算抽出来,作为第一层 CTE。例如把聚合先独立出来:
SELECT AVG(amount) FROM orders可以整理为:
avg_order AS (
  SELECT AVG(amount) AS avg_amt FROM orders
)
然后第二层再基于第一层做过滤或关联,命名尽量体现业务含义,例如:
high_value_orders AS (
  SELECT * FROM orders
  WHERE amount > (SELECT avg_amt FROM avg_order)
)
这里有几个容易被忽略的点:
- CTE 内尽量不要写
SELECT *,否则外层WHERE条件可能无法有效下推到基表。 - 多个 CTE 最好保持单向依赖,不要出现 A 依赖 B、B 又依赖 A 的交叉引用,否则会破坏线性执行顺序,甚至触发全物化。
- 如果 CTE 内含有
ORDER BY或LIMIT,还要额外留意是否引发了意外物化,导致执行计划偏离预期。
什么时候该放弃 CTE,直接改用临时表
CTE 更适合轻量、中间结果较小、并且只使用一次的场景。实际工程里,如果中间结果开始变大,或者同一段逻辑会被多次引用,临时表往往比 CTE 更稳。
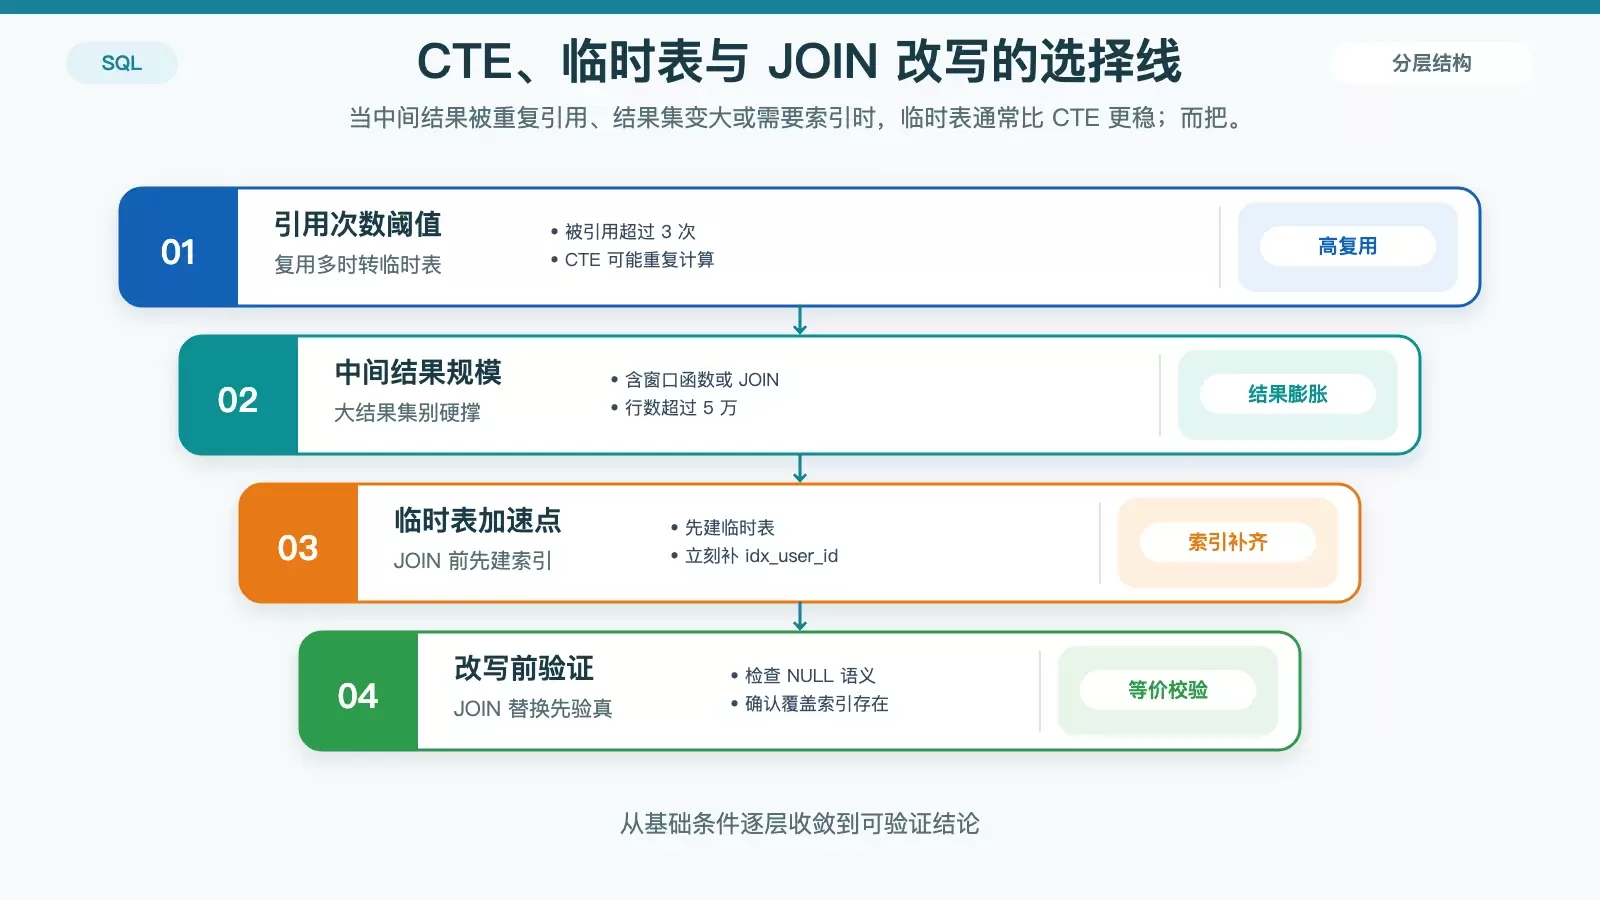
下列情况通常就该从 WITH 切换到 CREATE TEMPORARY TABLE:
- 同一中间结果被主查询引用 3 次以上,因为 CTE 可能在每次调用时重复计算。
- 中间结果里包含窗口函数、跨表 JOIN,并且行数已经超过 5 万。
- 后续 JOIN 依赖中间字段索引,例如要基于
temp_orders.user_id加速关联。 - 排查问题时需要直接查看中间结果,而 CTE 无法像普通表一样单独
SELECT * FROM cte_name。
一个典型写法是先生成临时表,再立刻补上索引:
CREATE TEMPORARY TABLE tmp_active_users AS
SELECT id, name FROM users WHERE status = 'active';
CREATE INDEX idx_user_id ON tmp_active_users(id);这一步不能省。很多 SQL 改写后看起来层级少了,但因为临时表没建索引,后续 JOIN 仍然会走全表扫描,执行计划里就会出现 type=ALL。一旦看到这个信号,就说明你只是把复杂度换了位置,并没有真正解决性能问题。
从维护角度看,临时表还有两个直接好处:一是每一步都可以独立验证结果,二是中间层可以加索引、便于调优。代价是会多出显式建表和清理步骤,因此更适合复杂链路和高复用查询,不适合很短、一次性的简单语句。
把 IN 或 EXISTS 改写成 JOIN 前,先确认三类等价条件
很多人看到嵌套子查询,第一反应就是把 IN 或 EXISTS 全部改成 JOIN。这类改写不一定错,但前提是你得先验证语义是否一致,否则结果可能先变了,性能还未必更好。
首先要检查子查询结果里是否可能出现 NULL。例如:
WHERE col IN (SELECT id FROM t)如果直接改成 JOIN,而子查询返回集合里本来可能带 NULL,那 JOIN 会自动过滤掉这些值,结果就不再等价。
其次要确认被驱动表具备合适的覆盖索引。比如子查询对应的是客户表,那么至少要有类似:
customers(status, id)这样的索引;否则即便你把子查询写成 JOIN,底层依然可能是全表扫描,性能不会有本质改善。
第三个关键点,是把主表过滤尽量前置。更合理的写法是:
SELECT ...
FROM orders o
JOIN (
  SELECT id FROM customers WHERE status = 'active'
) c ON o.customer_id = c.id
而不是先把整张 customers 表 JOIN 进来,再在外层写:
WHERE c.status = 'active'前者更容易把过滤条件压缩到子查询内部,减少参与关联的数据量。
另外,使用 LEFT JOIN ... WHERE ... IS NOT NULL 去模拟 EXISTS 时,还要特别留意重复行问题。如果关联关系是多对一或一对多,结果集可能被放大。这种情况下,通常要么改用 INNER JOIN,要么补上 DISTINCT,否则逻辑上就已经偏离原查询了。
视图嵌套超过三层,先断开依赖链再评估执行计划
子查询嵌套之外,另一类常见问题是视图套视图。视图链一旦超过三层,复杂度会迅速失控。此时麻烦不只是 SQL 难读,而是依赖关系开始变得不可追踪:像 pg_depend、sys.dm_exec_describe_first_result_set 这类元数据工具,面对过深嵌套时往往很难还原真实链路。SQL Server 还有 32 层的硬限制,碰到上限会直接报 Msg 319,连编译都过不去。
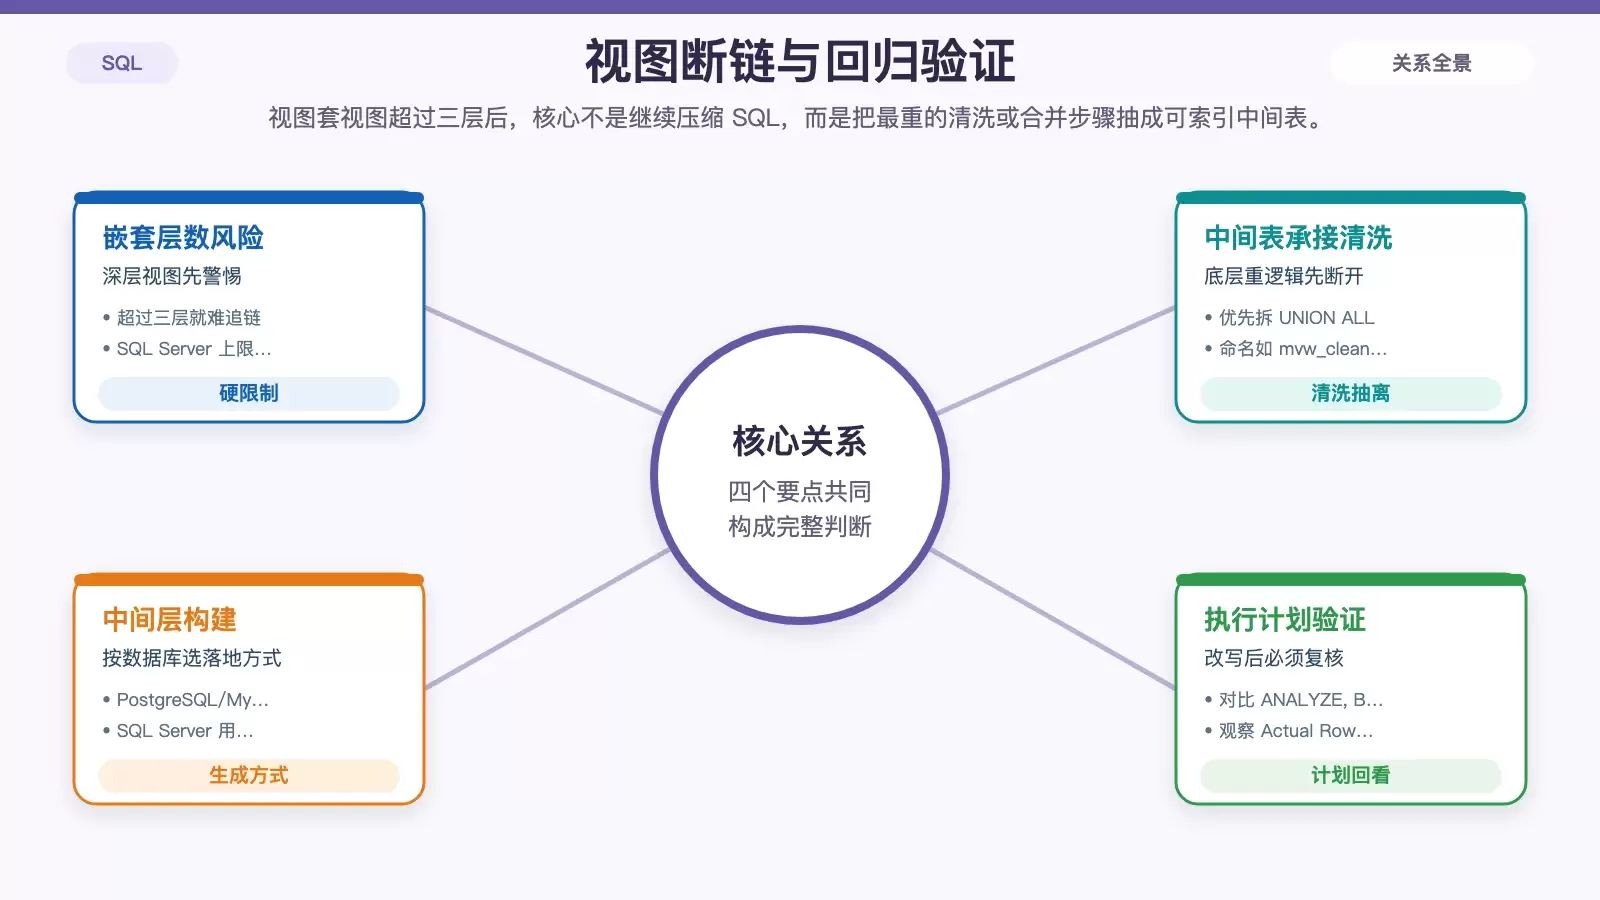
这类场景里,真正可行的办法往往不是继续压缩成一个更大的 WITH,而是主动“断链”,把底层最重的清洗或合并步骤拆成中间表。尤其是包含 UNION ALL 或多源汇总的部分,通常最适合先抽出来,做成带索引的中间层,例如命名为 mvw_cleaned_orders。
具体落地时,可以根据数据库类型选择:
- PostgreSQL / MySQL:使用
CREATE TABLE AS SELECT - SQL Server:使用
SELECT INTO
这样做的重点,是不要再把性能寄托在视图层层下推上,而是把真正复杂的部分先固定成一个可检查、可索引的结果集。
如果这张中间表需要周期性刷新,还应在调度任务中明确加入:
TRUNCATE + INSERT避免数据 stale。与此同时,也别把“拆出来”当成万能答案。有些原始视图链本来就具备不错的条件下推能力,强行改成单个大 CTE 后,反而可能导致结果集提前膨胀。因此改写前后都应该对比执行计划,重点看 EXPLAIN (ANALYZE, BUFFERS) 里的 Actual Rows 是否明显暴增。
说到底,重构 SQL 不是为了让语句看起来更扁平,而是为了让每一步都可观察、可索引、可复用。真正决定成败的,往往不是表面层级,而是这些细节有没有处理到位:中间结果里的 NULL 陷阱、JOIN 字段是否缺索引、以及 CTE 里 ORDER BY、LIMIT 带来的意外物化。只要这些问题还在,再漂亮的分层也只是换了一种复杂写法。















