



查数据断档时,很多人先想到“子查询能不能直接找缺口”,但问题的核心其实不在子查询,而在你是否把断档定义成了可比较的条件。下面按最常见的几类场景展开:什么时候用 NOT EXISTS 找断层起点,什么时候该补全序列再做差集,以及哪些“看起来能跑”的写法会在大表或脏数据里直接失真。
用 NOT EXISTS 找 ID 断层起点
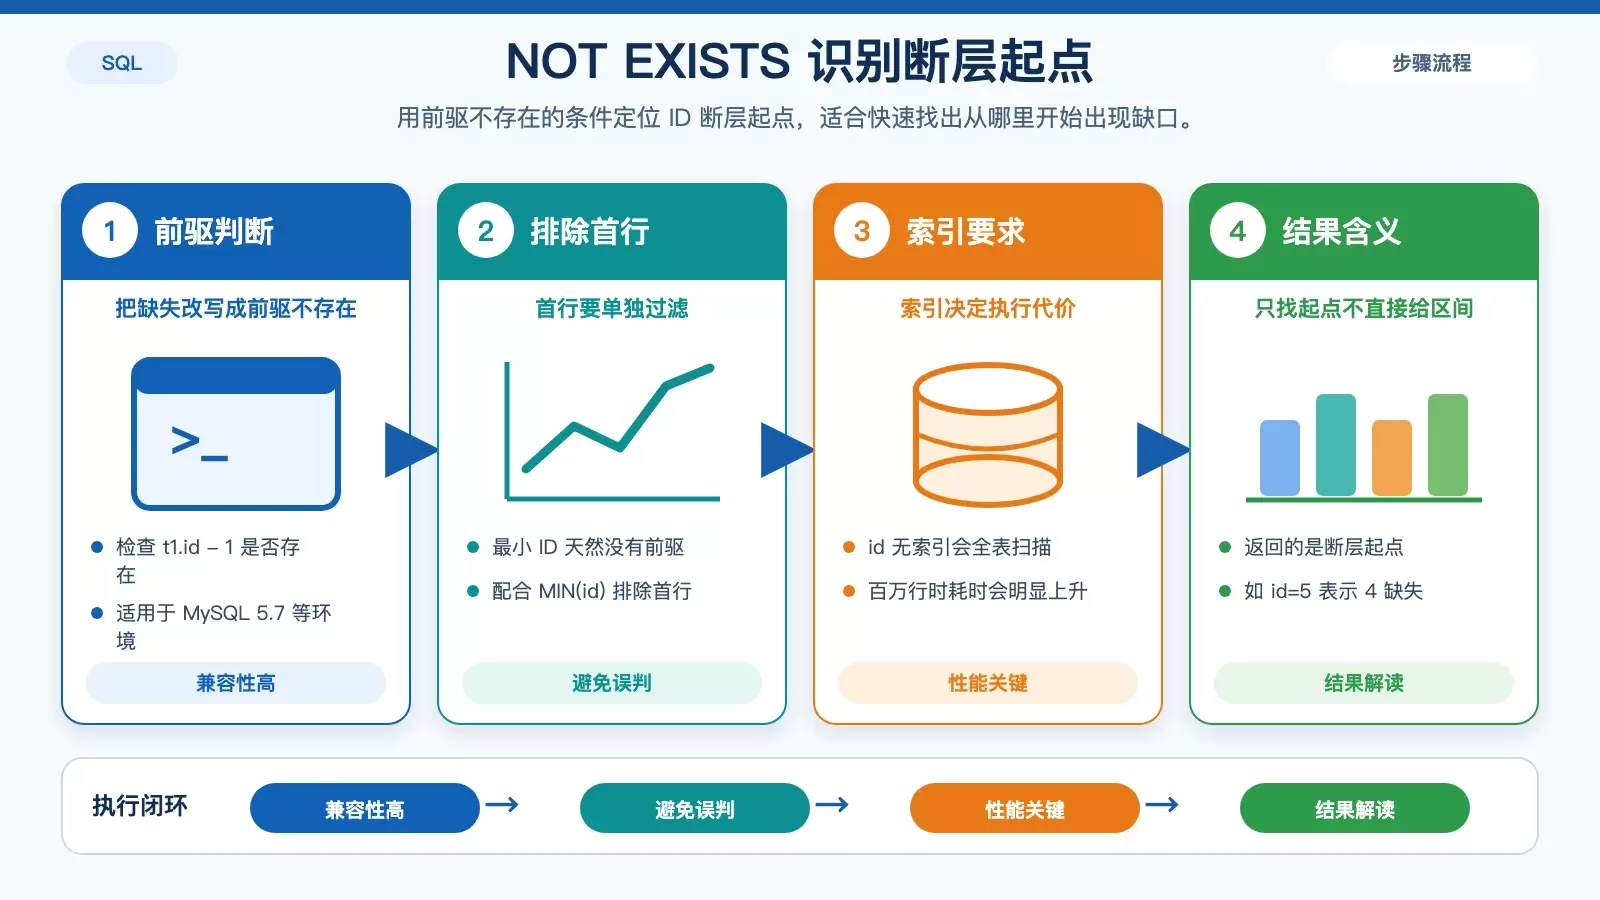
如果目标是找出“从哪里开始断了”,NOT EXISTS 往往是最轻量、兼容性也最好的方案。它不依赖窗口函数,MySQL 5.7、PostgreSQL、SQL Server 都能用,思路是把“缺失某个 ID”改写成“当前行的前一个 ID 不存在”。
核心判断条件如下:
WHERE NOT EXISTS (SELECT 1 FROM t2 WHERE t2.id = t1.id - 1)不过这条条件本身会把表中的最小 ID 也算进去,因为它天然没有前驱。所以还要加上一层过滤,排除首行误判:
t1.id > (SELECT MIN(id) FROM t1)组合起来后,这种写法返回的是“断层起点”。例如结果里出现 id=5,它表达的含义不是 5 缺失,而是 4 不存在,缺口从 4 这个位置开始暴露出来。
这种写法成立的前提
id必须有索引。否则相关子查询很容易退化成全表扫描,数据量到百万行时,执行时间可能从秒级拉到分钟级。id需要非空且最好唯一。只要存在NULL或重复值,前驱判断就可能失真,结果不再可靠。- 如果源数据质量一般,建议先做过滤,例如:
WHERE id IS NOT NULL AND id > 0。
还要注意一点:这种方法只负责告诉你“哪里开始断”,并不会直接产出完整缺失区间。也就是说,它适合快速定位异常点,但如果你要拿到 gap_start 和 gap_end 这样的区间结果,还要继续配合 LEAD(),或者再关联一次去找最大连续后继。
用 EXCEPT 或补全序列列出所有缺值
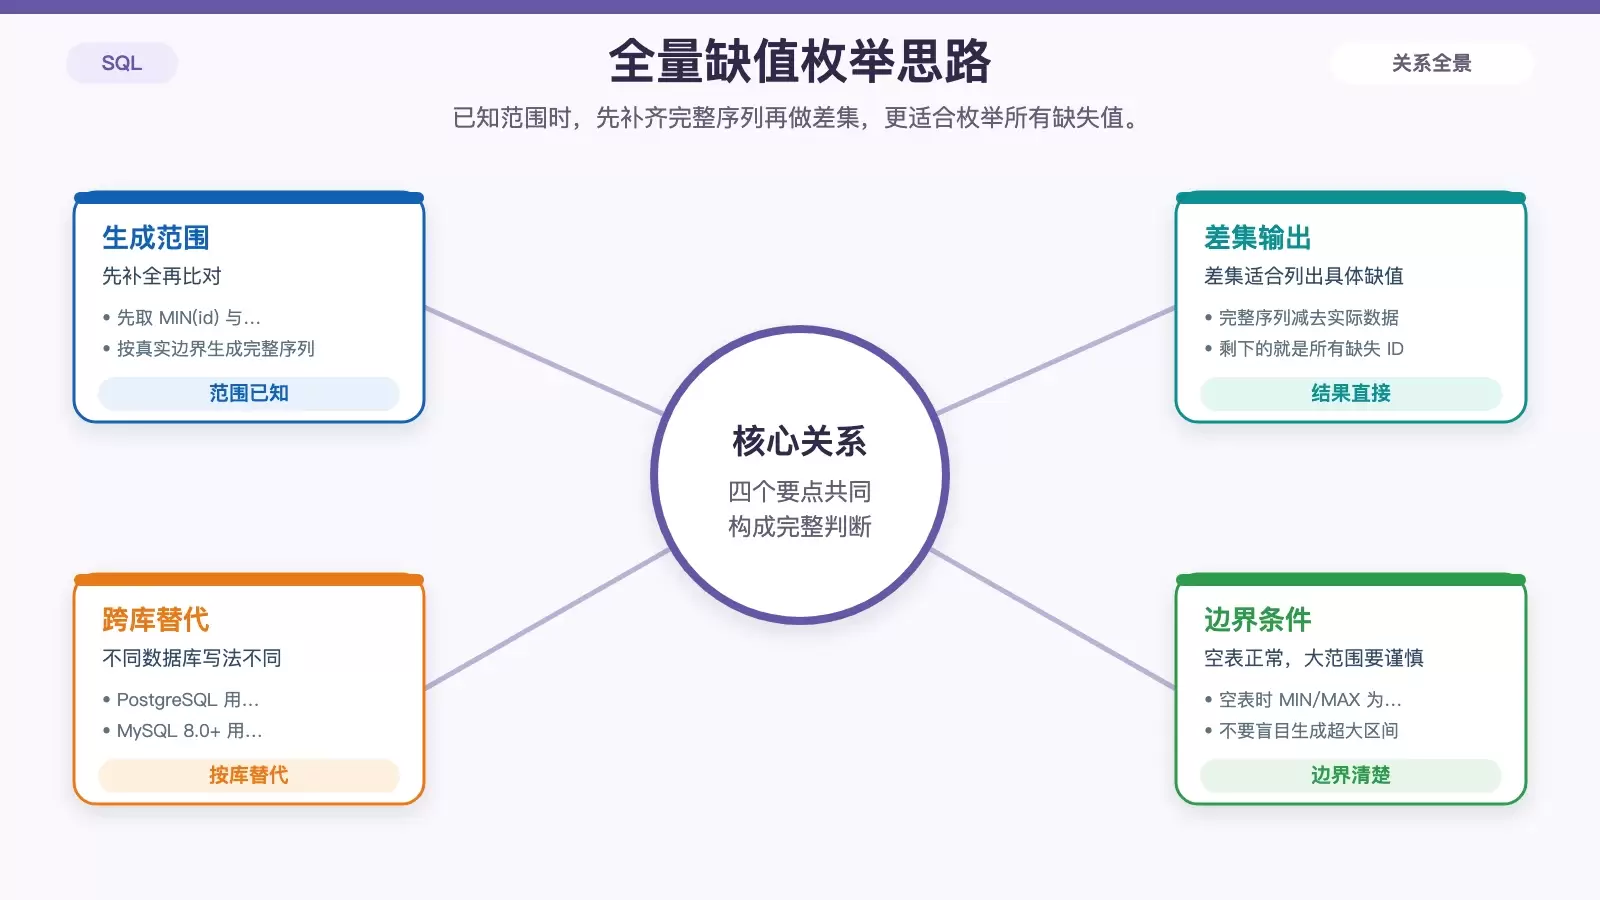
当你已经知道 ID 的合理范围,而且需求不是找断层起点,而是想把每一个缺失值都列出来时,思路就该切换成“先生成完整序列,再和实际数据做差集”。在这种场景下,EXCEPT 通常比嵌套子查询更直观,执行计划也更容易优化。
PostgreSQL 的典型写法是:
SELECT g.id FROM generate_series((SELECT MIN(id) FROM t), (SELECT MAX(id) FROM t)) AS g(id)
EXCEPT
SELECT id FROM t
这段 SQL 的含义很直接:先用 generate_series 生成从最小 ID 到最大 ID 的全量序列,再减去表中实际存在的值,剩下的就是所有缺失 ID。
不同数据库的替代方式
- PostgreSQL 可以直接使用
generate_series。 - MySQL 8.0+ 没有这个函数,通常用
WITH RECURSIVE递归生成序列替代。 - SQL Server 递归时一般要补上
OPTION (MAXRECURSION 0),否则层数默认有限制。
这里还有两个经常被误判的问题。
第一,如果表为空,MIN(id) 和 MAX(id) 都会返回 NULL,这时整个 generate_series 不会执行。这个表现是正确行为,不是 bug,因为空表本来就没有可推导的范围。
第二,不要为了省事直接写死一个超大区间,比如 generate_series(1, 1000000)。序列跨度越大,内存和时间消耗越明显,而且增长往往不是线性的。更稳妥的方式始终是先拿到真实的 MIN/MAX,再按实际边界生成。
模拟 LAG() 的常见陷阱
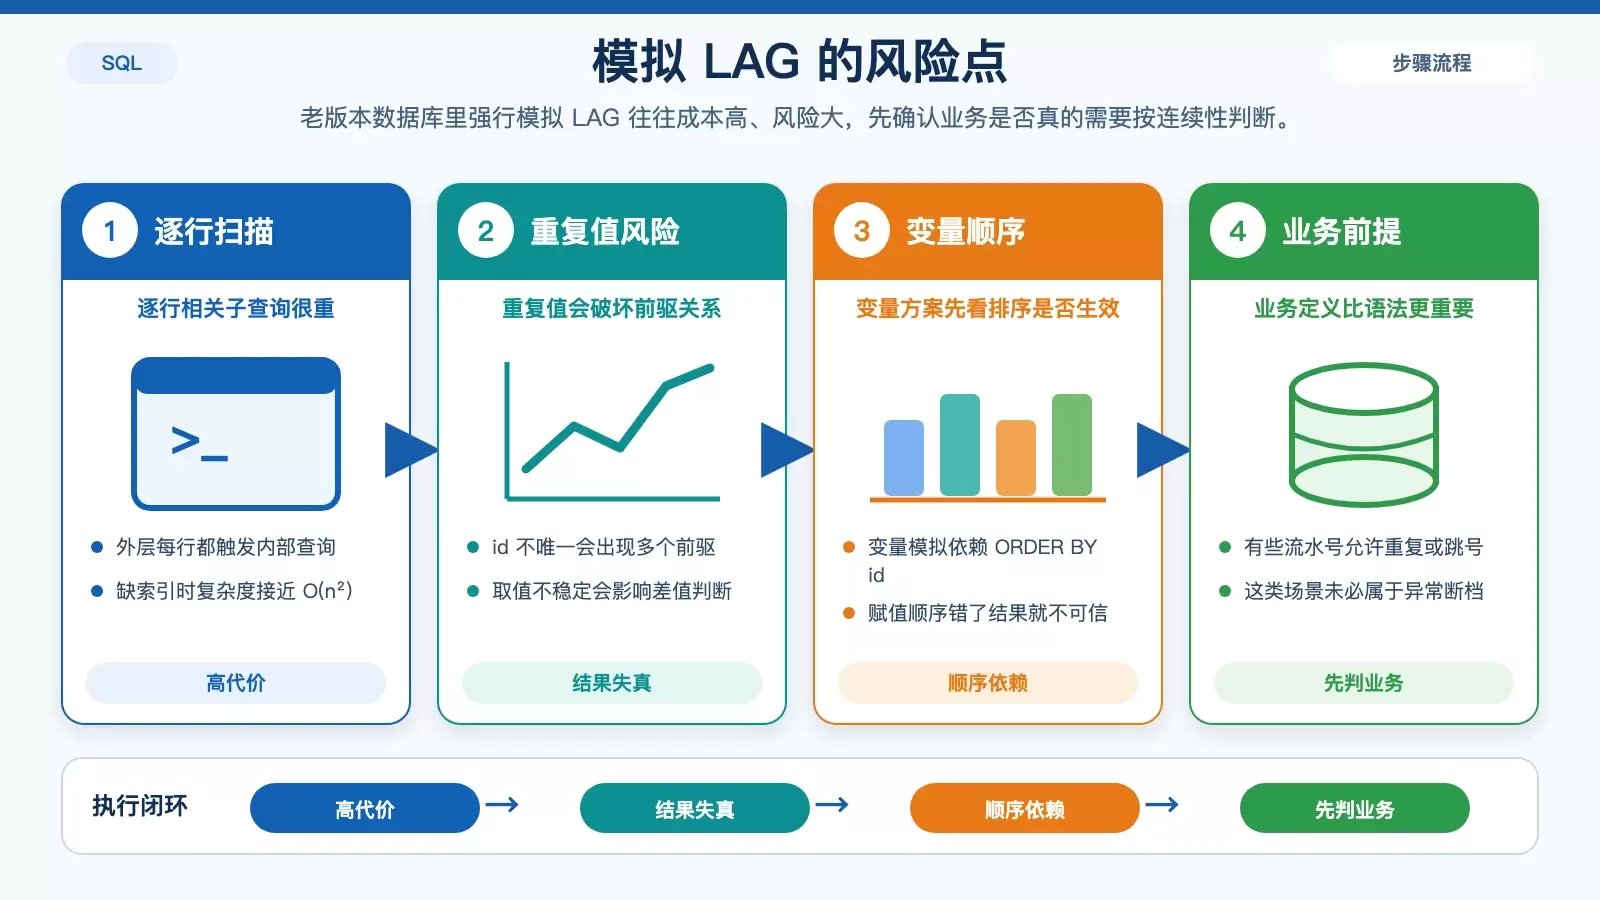
在不支持窗口函数的旧版本环境里,最容易出现的误区,是用自连接加子查询去硬模拟 LAG()。SQL 看起来能跑,但一旦表大、索引缺失或者键值不干净,代价会非常高。
典型例子如下:
SELECT a.id, (SELECT id FROM t b WHERE b.id < a.id ORDER BY b.id DESC LIMIT 1) AS prev_id FROM t a这类写法的问题主要有两层。
- 如果没有给
id建索引,外层每一行都会触发一次内部扫描,复杂度很容易接近O(n²)。 - 如果
id本身不唯一,子查询取到的“前一个值”可能只是多个候选中的任意一个,后续再做差值判断时,结论会直接失真。
有些人会进一步改成变量模拟,例如用 @prev := @prev 一类写法来保存前一行值。这比逐行相关子查询通常更省成本,但前提是外部查询的 ORDER BY id 必须真实生效,否则变量赋值顺序错乱,结果同样不可信。
所以在老版本里,与其急着研究怎么“模拟出窗口函数效果”,不如先回到业务本身,确认断档定义是不是成立。比如某些支付流水号允许因重试而重复,或者某些业务 ID 天生会跳号,这种情况下你看到的并不是异常断档,而是系统设计本来就允许的结果。
先定义清楚,到底什么才算断档
真正最容易被忽略的,通常不是 SQL 语法,而是“断档”这个词本身的业务定义。
你要判断的到底是:
- 按
ID的自然顺序是否连续; - 还是按业务时间戳是否发生跳变;
- 或者某个编号字段连续,但写入时间已经明显乱序。
这几种情况虽然都像“数据有缺口”,但背后的问题完全不同。同一张表里,order_id 看起来连续,不代表数据链路就健康;如果 created_at 明显乱序,往往更值得优先排查,因为它可能意味着写入延迟、重放、补单或上游链路异常。
换句话说,子查询只能帮你表达规则,不能替你决定规则本身。先把断档标准说清楚,再选 NOT EXISTS、EXCEPT 或其他方案,结果才有解释价值。















