



很多“复购查询”之所以结果不准,不是窗口函数不会写,而是把“首次购买”这件事定义得太粗。要查准首次购买后的订单,必须先按真实下单时间为每个用户确定首单,再结合退款过滤、时间精度和重复下单等边界条件,才能得到可落地的 SQL 结果。
先用 ROW_NUMBER() 找到每个用户的首次购买
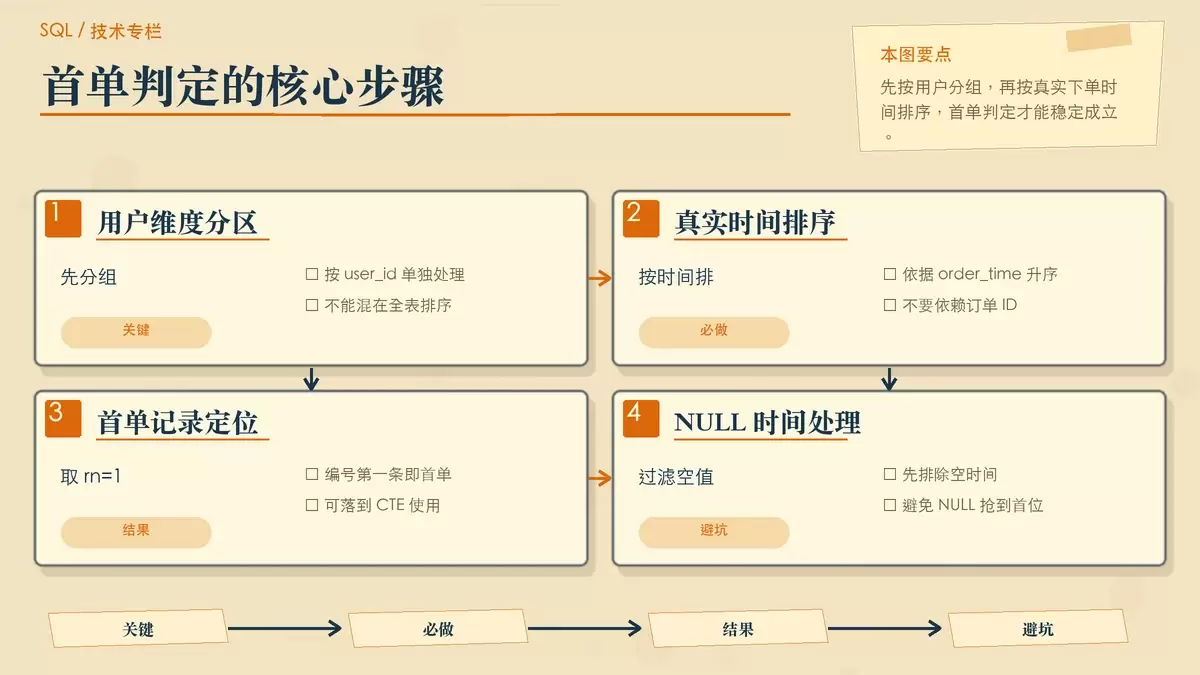
这类查询的第一步,不是直接统计复购,而是先锁定每个 user_id 的首次购买时间。只有时间基准明确了,“首次购买后”这个条件才有意义。
这里不能依赖订单 ID、插入顺序,甚至也不能简单理解成“最早的一条记录”。判断首单时,必须以实际下单时间字段排序,比如 order_time。
最常见的误区,是直接对订单表写 MIN(order_time)。这样只能拿到某个范围内的最早时间,或者在分组后拿到每个用户的最小时间点,但很难直接保留对应订单的完整行信息;一旦后面还要查首单明细、排除退款单或处理同秒重复下单,窗口函数会更稳妥。
更适合的方式,是先在用户维度内编号:
ROW_NUMBER() OVER (
  PARTITION BY user_id
  ORDER BY order_time
)
这段逻辑的含义很直接:
- 按
user_id分组,每个用户单独排序 - 按
order_time升序,最早的订单排在前面 - 编号结果里,
rn = 1就是该用户的首次购买记录
在正式查询里,通常会把这一步放进 CTE 或临时表中。另一个不能省略的条件是:先过滤 order_time IS NOT NULL。如果时间字段存在空值,不同数据库对 NULL 的排序位置可能不同,最终就可能把一条没有真实下单时间的记录误当成首单。
如果业务里还要排除退款单,也建议在这一步同步处理。因为一旦“首次购买”本身被判错,后面所有复购记录都会跟着偏掉。
确定首单后,怎么筛出首次购买后的复购订单
拿到每个用户的 first_order_time 之后,复购订单的判定就简单很多了:同一用户下,所有 order_time 晚于该时间点的订单,都可以视为首次购买后的后续订单。
这一步常见有两种写法。
写法一:用自连接直接匹配
这是最直观、也最容易解释给业务方听的一种方式。左侧是全部订单,右侧是每个用户只保留一条首单时间的结果集,然后按用户和时间条件连接:
ON a.user_id = b.user_id
AND a.order_time > b.first_order_time
这样连出来的,就是所有发生在首单之后的订单。
这种方式有两个关键点:
- 右表必须是每个用户一行的结果,比如通过 CTE 先取出
rn = 1的首单记录 - 连接字段最好有索引,至少要关注
user_id和时间字段,否则在大表上性能会明显变差
如果右表没有先收敛成单行结果,而是直接拿原始订单去连,很容易把同一用户的多条记录互相匹配,造成结果膨胀,甚至接近笛卡尔积。
写法二:用 LAG() 辅助判断顺序
LAG() 适合在用户分组内部做前后行比较,写法相对紧凑。但它并不是凭空就能判断“是否发生在首单之后”,而是要先通过子查询或 CTE,把每个用户的 first_order_time 算出来,再带回到每一行订单上。
换句话说,LAG() 更像是做顺序比较的辅助工具,不能替代“先确定首单”的那一步。对于只想查出所有复购订单的场景,自连接通常更清晰;如果后面还要继续比较相邻购买行为,LAG() 的延展性会更好。
如果还要统计复购次数或第二次购买时间,窗口写法要跟着变
不少需求并不满足于“找出所有复购订单”,还会继续追问:每个用户复购了几次?第二次购买发生在什么时候?这时不能只停留在首单筛选上,窗口函数的统计口径也要同步调整。
统计每个用户的复购次数
如果数据库是 PostgreSQL,可以直接用带条件的聚合窗口:
COUNT(*) FILTER (WHERE order_time > first_order_time)
OVER (PARTITION BY user_id)
它的含义是:在每个用户分区内,只统计那些时间晚于首单的订单。
但这个写法并不是所有数据库都支持。MySQL 8.0+ 不支持 FILTER,这时要改写成条件求和:
SUM(CASE WHEN order_time > first_order_time THEN 1 ELSE 0 END)
OVER (PARTITION BY user_id)
如果是 SQL Server,通常也要使用 CASE 或 IIF 来表达同样的逻辑。
查询第二次购买时间
如果需求不是统计次数,而是定位“第二次购买时间”,思路也很清楚:先过滤掉首单,只保留 order_time > first_order_time 的订单;再对这些后续订单重新做一次排序编号,取 rn = 1。
这相当于对“复购集合”再做一轮 ROW_NUMBER()。第一次编号用于找首单,第二次编号用于找首单之后的第一笔订单,也就是通常所说的第二次购买。
这些边界情况,往往才是复购查询出错的根源
窗口函数本身并不复杂,真正容易让结果失真的,是业务口径和脏数据处理没有提前说清楚。下面这些情况,在真实订单表里都很常见。
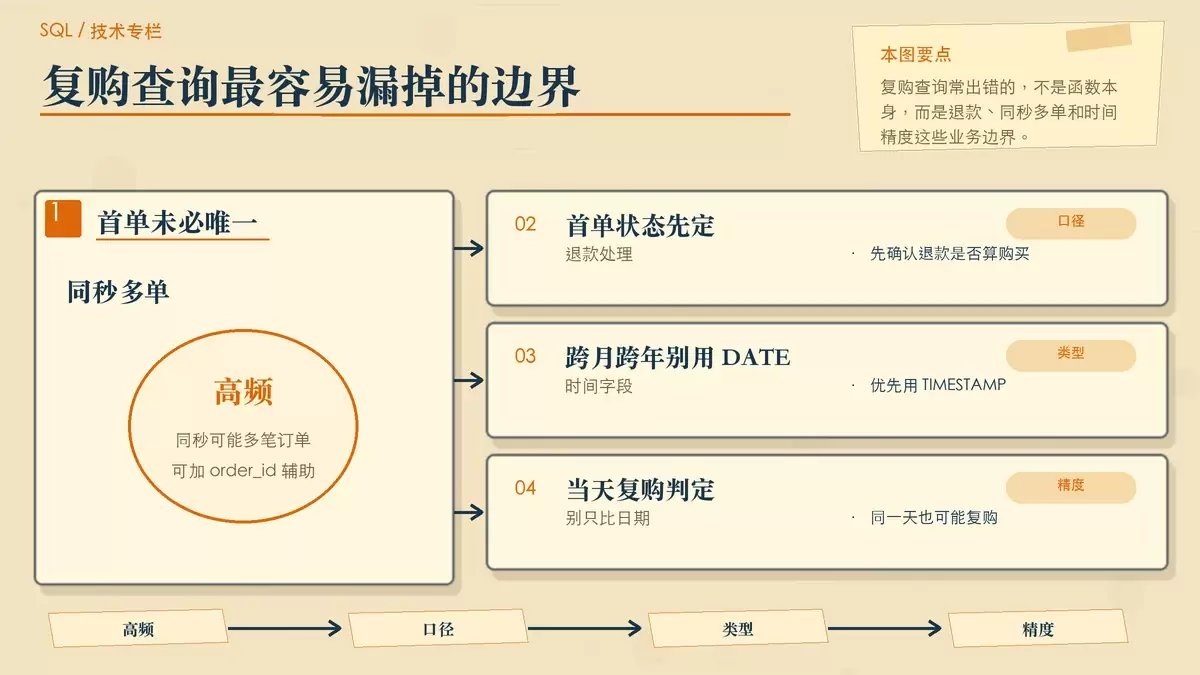
同一用户同秒下单,首单未必只有一条
如果同一个用户在同一秒内产生了多笔订单,单纯按 order_time 排序虽然能借助 ROW_NUMBER() 给出确定性结果,但这个“第一条”未必符合业务上的首单定义。
遇到这种情况,常常需要引入额外排序字段,例如在相同 order_time 下再按 order_id 升序,或者先和业务确认:同秒多单是算一笔首次购买,还是只认最早落库的一单。必要时可以用 MIN(order_id) 作为辅助去重依据。
退款订单要不要参与首单判断
如果订单状态里存在 status = 'refunded',就必须先确认退款单是否算购买行为。很多复购查询漏数,根源就在这里:首单被一笔已退款订单占掉了位置,导致真正有效订单被误判成复购。
如果业务定义里退款单不算购买,应该在初始 CTE 里先加上:
WHERE status != 'refunded'这一步越早做越好,因为它影响的是首单基准本身,而不只是最终筛选结果。
跨月跨年查询时,时间类型不能偷懒
只要查询范围跨天、跨月甚至跨年,就要特别注意 order_time 的字段类型。更稳妥的是使用 TIMESTAMP,或者带时区的 TIMESTAMPTZ。
如果把时间当字符串处理,或者只保留成 DATE,凌晨订单、时区转换、跨天边界这些问题都会混进来,最后出现“明明有复购却没查出来”的情况。
首次和复购发生在同一天,不能只比日期
新用户当天首购后又马上下单,是很常见的场景。如果 SQL 里只比较 DATE(order_time),那么同一天内的首单和复购会被压成同一个日期,导致复购判定失效。
因此,“首次购买后”这件事必须基于精确时间戳来判断,至少要比到秒,而不是只看日历日期。
先定口径,再写窗口函数,复购结果才可靠
这类查询的主线其实很固定:先用 ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY order_time) 找到每个用户的首单,再用时间比较筛出首单之后的订单,最后根据需求补上复购次数或第二次购买时间。
真正决定结果是否可信的,不只是语法对不对,而是这些前提是否提前确认:是否过滤 order_time IS NOT NULL、退款单算不算购买、同秒多单如何去重、时间字段是否保留到足够精度。把这些口径先对齐,SQL 才不会在上线后反复返工。















