



做 SQL JOIN 时,中文字段明明肉眼一致,结果却连不上,很多人第一反应是怀疑 SQL 条件写错,或者怀疑表里数据有脏值。实际上,这类问题更常见的根因在连接层:客户端发给 MySQL 的字符串在解析前就被错误转码了,或者跨表比较时使用了不同的校对规则。下面按实际排查顺序来拆:先看连接字符集三项,再看不同驱动的连接写法,最后判断是否需要处理 COLLATE,而不是一上来就改表。
JOIN 中文字段匹配失败,先查三处字符集
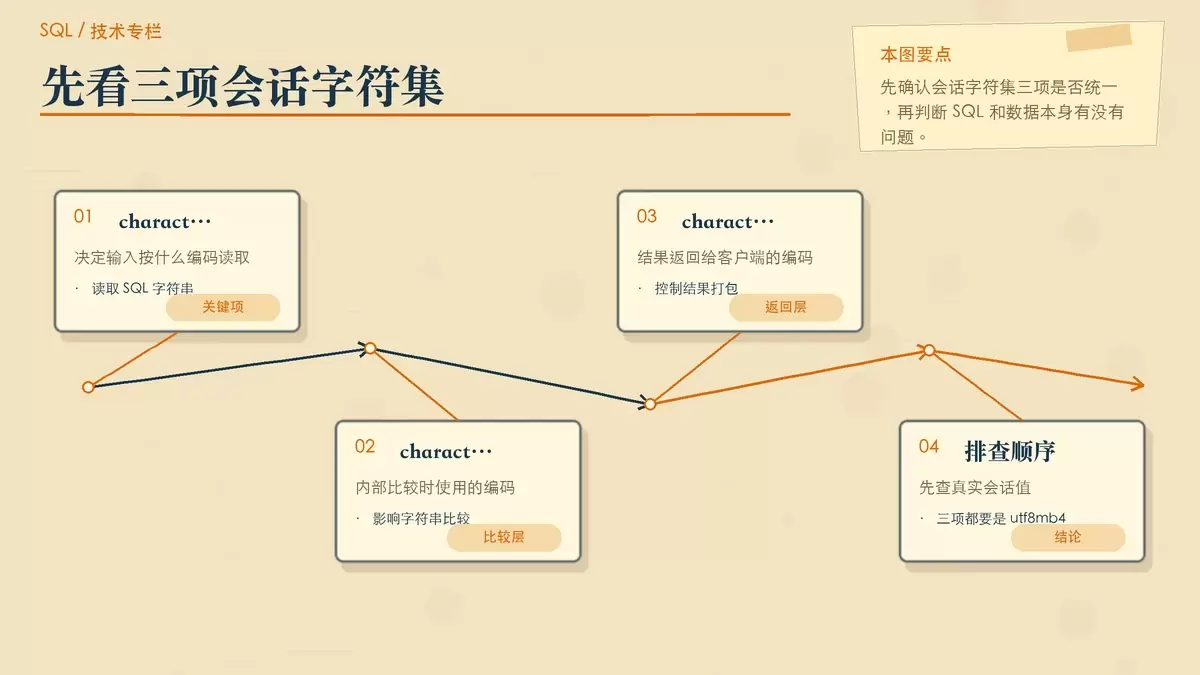
如果 JOIN 条件里的中文字段“看起来一样却连不上”,大概率不是 SQL 本身有问题,而是 character_set_client、character_set_connection、character_set_results 这三项没有统一。哪怕两张表里的字段都定义成 utf8mb4_unicode_ci,只要连接参数里混进了 latin1 或 gbk,MySQL 就可能在解析 ON 条件前先做一次错误转码。
这也是最容易被忽略的一点:很多人只看建表语句或配置文件里的默认值,却没看当前会话真正使用的字符集。实际排查时,先执行下面这条命令:
SHOW VARIABLES LIKE 'character_set%';重点盯住下面三项,它们必须全部是 utf8mb4:
character_set_client:MySQL 按什么编码读取你发过来的 SQL 字符串character_set_connection:MySQL 内部执行字符串比较时使用什么编码character_set_results:查询结果返回给客户端时按什么编码打包
如果这三项里有任意一项不是 utf8mb4,中文 JOIN 条件就可能在进入比较逻辑之前已经被错解。比如“张三”的 UTF-8 字节被当成 Latin-1 去解释,最终当然无法匹配到原本正确存储的数据。
连接字符串漏掉 charset=utf8mb4,是最常见原因
一种很典型的现象是:同一条 JOIN 语句,在 Navicat 里手工执行没问题,放进程序里却返回空结果。这通常说明表结构和 SQL 逻辑本身没错,问题出在驱动初始化连接时没有显式声明字符集。
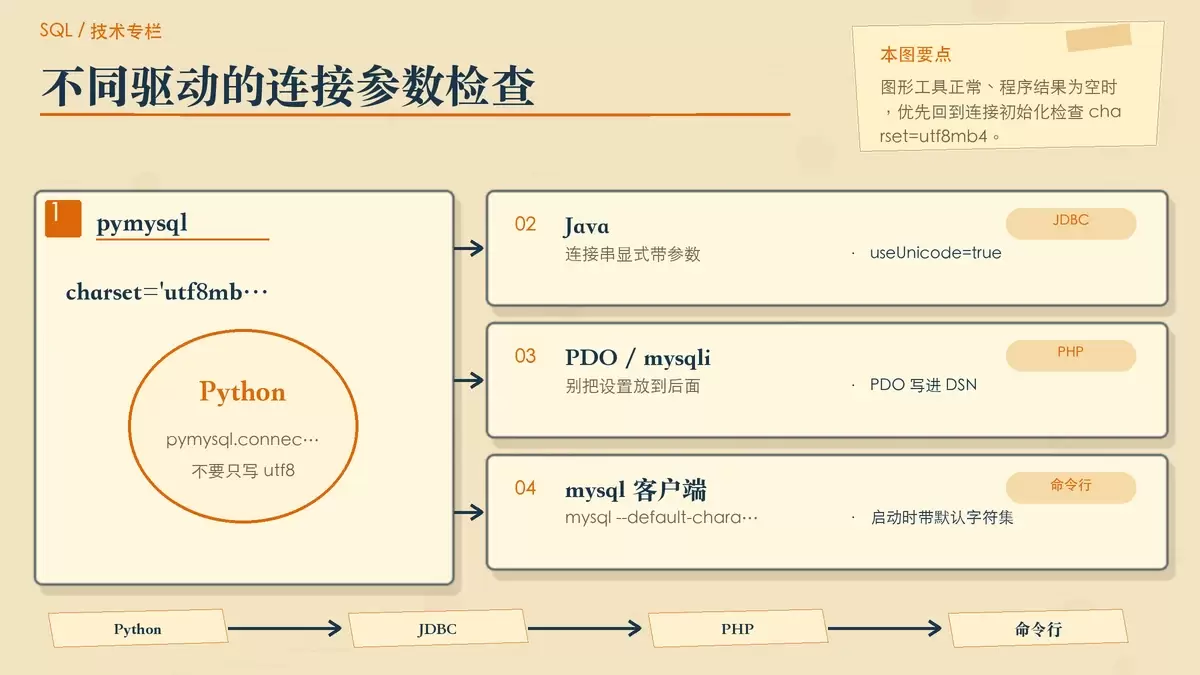
这里不要依赖所谓“自动协商”或默认配置。不同语言和驱动的参数写法不一样,但核心规则只有一条:在连接建立时明确指定 utf8mb4。
Python + pymysql
pymysql.connect() 里必须显式传入 charset='utf8mb4'。只写 charset='utf8' 不够,因为 MySQL 里的 utf8 不是完整 UTF-8,而是历史上的三字节实现。
charset='utf8mb4'Java + JDBC
JDBC 连接串里要明确带上字符集参数:
jdbc:mysql://host/db?useUnicode=true&characterEncoding=utf8mb4这里要注意两点:一是参数值必须写 utf8mb4,不是 UTF-8;二是如果你把这段内容放在 XML 或 properties 等场景里,& 需要正确转义。
PHP + PDO / mysqli
PDO 需要把字符集直接写进 DSN:
mysql:host=localhost;charset=utf8mb4如果使用 mysqli,则要在 connect() 之后立刻执行:
set_charset('utf8mb4')mysql 命令行客户端
命令行排查时也别忽略客户端编码。建议显式带上参数启动:
mysql --default-character-set=utf8mb4 -u root -p如果不加这个参数,客户端可能仍然按 latin1 处理输入,导致你以为是 SQL 或数据有问题,实际上只是会话字符集不对。
所以,排查这类问题时可以先做一个简单判断:如果图形工具里正常、代码里异常,优先检查连接字符串,而不是先改 SQL。
跨表 JOIN 时,COLLATE 不一致也会造成隐性匹配失败
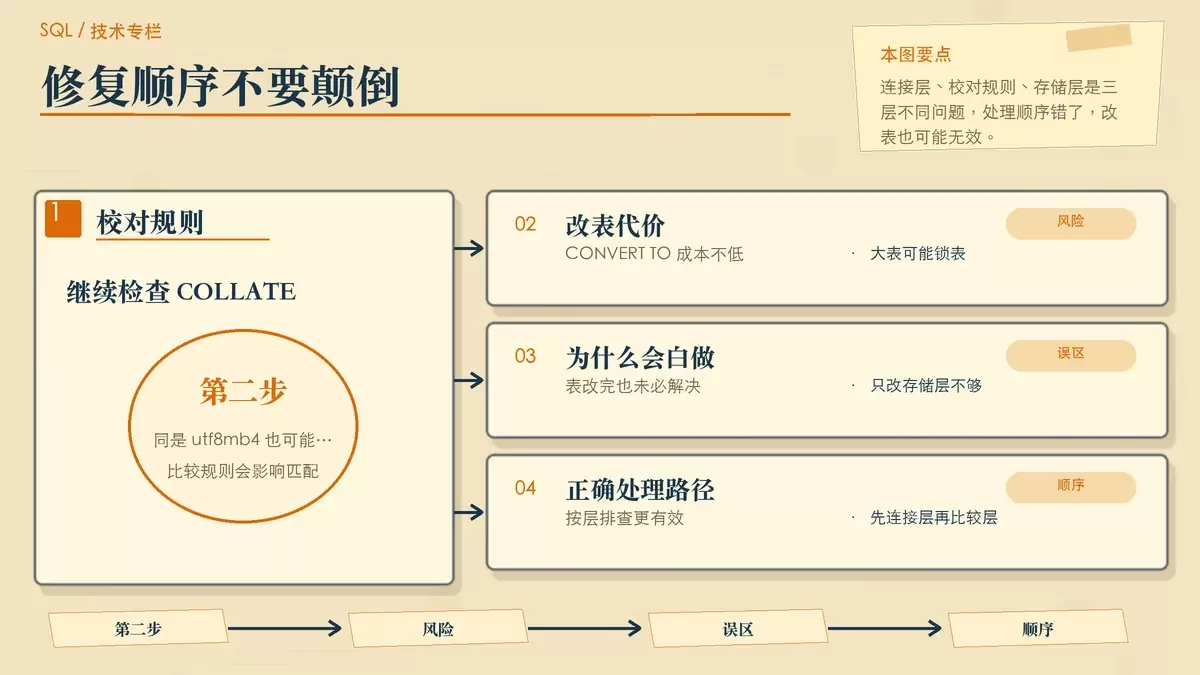
如果连接层已经确认是 utf8mb4,JOIN 仍然有中文匹配异常,就该继续看字段的校对规则,也就是 COLLATE。这是另一类常见但不容易第一眼发现的问题。
比如两张表的同名字段都使用 utf8mb4,但一个是 utf8mb4_unicode_ci,另一个是 utf8mb4_general_ci,表面看字符集一致,实际比较规则却不同。JOIN 时 MySQL 可能发生静默的比较逻辑变化,结果就会出现“看起来相同”的值匹配不上,或者把边界数据漏掉。
可以先查字段当前实际使用的校对规则:
SELECT COLUMN_NAME, COLLATION_NAME FROM information_schema.COLUMNS WHERE TABLE_SCHEMA = 'db_name' AND TABLE_NAME = 'table_name';确认后,通常有两种处理思路:
- 临时验证:直接在 JOIN 条件里强制统一校对规则
ON a.name COLLATE utf8mb4_unicode_ci = b.name COLLATE utf8mb4_unicode_ci- 长期处理:在表结构里显式声明字段校对规则,不依赖数据库默认值
name VARCHAR(50) COLLATE utf8mb4_unicode_ci NOT NULL选择校对规则时,中文场景下不要继续使用 utf8mb4_general_ci。更稳妥的做法是优先考虑 utf8mb4_unicode_ci,如果是 MySQL 8.0.30+,也可以评估更细粒度的 utf8mb4_zh_0900_as_cs。
不要用 ALTER TABLE CONVERT TO 代替连接层修复
不少人遇到 JOIN 中文字段异常时,会直接把两张表都执行一遍 ALTER TABLE ... CONVERT TO CHARACTER SET utf8mb4,觉得这样就能一次性修好。实际情况往往不是这样。
原因很简单:CONVERT TO 改的是存储层,而前面提到的字符错解问题,很多发生在连接层和比较层。也就是说,哪怕表已经改成 utf8mb4,只要应用连接还是 latin1,JOIN 条件照样可能在进入执行阶段前被错误解释。
而且,这类操作本身还有额外成本和风险:
- 大表执行时可能锁表、重建索引,并占用双倍级别的磁盘空间,线上环境需要非常谨慎
CONVERT TO会影响整张表的所有相关字段,处理不当可能带来额外副作用- 即使表结构改完,如果连接参数没有修正,问题仍然不会消失
因此更合理的顺序应该是:先固定连接字符串中的 charset=utf8mb4,再用 SHOW VARIABLES 验证三项会话字符集是否已经统一;确认连接层无误后,再检查字段 COLLATE;只有确实存在存储层历史遗留问题时,才考虑执行表级转换。
换句话说,JOIN 中文字段异常的排查优先级,不是“先改表”,而是“先确认当前连接到底在用什么编码”。连接层没修正,后面的调整很容易白做。















