



订单按年月汇总,看起来只是把日期裁成“2024-05”这样一个键再分组,但真正影响结果可用性的,往往是格式是否统一、排序是否自然,以及筛选条件有没有把索引用废。下面按 MySQL、PostgreSQL、SQL Server 和跨数据库场景分别拆开讲,顺带把哪些写法适合展示、哪些写法更利于执行计划,一次说明白。
MySQL:优先用 DATE_FORMAT 提取年月
在 MySQL 里,按年月分组统计订单,最稳妥的方式是用 DATE_FORMAT(order_time, '%Y-%m')。它会直接返回类似 '2024-05' 的字符串,分组结果清晰,排序和展示也都比较省事。
很多人会先想到 YEAR() 和 MONTH(),但如果后续还要拼接成年月字符串,就容易把格式处理搞乱。比如 2024-1 和 2024-10 这种场景,如果月份没有统一补零,结果在展示和比较时都容易出问题。相比之下,DATE_FORMAT 直接把月份格式固定为两位,更适合拿来做聚合键。
常见但不够顺手的写法是:
GROUP BY YEAR(order_time), MONTH(order_time)这种写法确实能完成分组,但结果通常会拆成年、月两列。只要后面还要接报表、图表,或者想直接返回一个统一键值,就还得再做一次加工,实际并不省事。
使用时还要注意三个前提:
order_time最好是DATETIME或DATE类型;如果字段里存的是字符串,先用STR_TO_DATE()转换。- 表数据量较大时,要给
order_time建索引,否则一旦在查询里套函数,代价很容易放大。 - 不要在
WHERE里直接写DATE_FORMAT(order_time, '%Y-%m')的等值判断,这类条件通常没法有效利用索引。
更合适的筛选方式是改成时间范围:
order_time >= '2024-05-01' AND order_time < '2024-06-01'这样既能按月过滤,又更有机会走到索引。换句话说,DATE_FORMAT 更适合出现在 SELECT 和 GROUP BY,而不是过滤条件里。
PostgreSQL:展示用 TO_CHAR,计算用 DATE_TRUNC
PostgreSQL 没有 MySQL 的 DATE_FORMAT,最接近、也最省事的替代方案是 TO_CHAR(order_time, 'YYYY-MM')。如果你的目标是按年月输出一个直观的分组键,这通常就是首选。
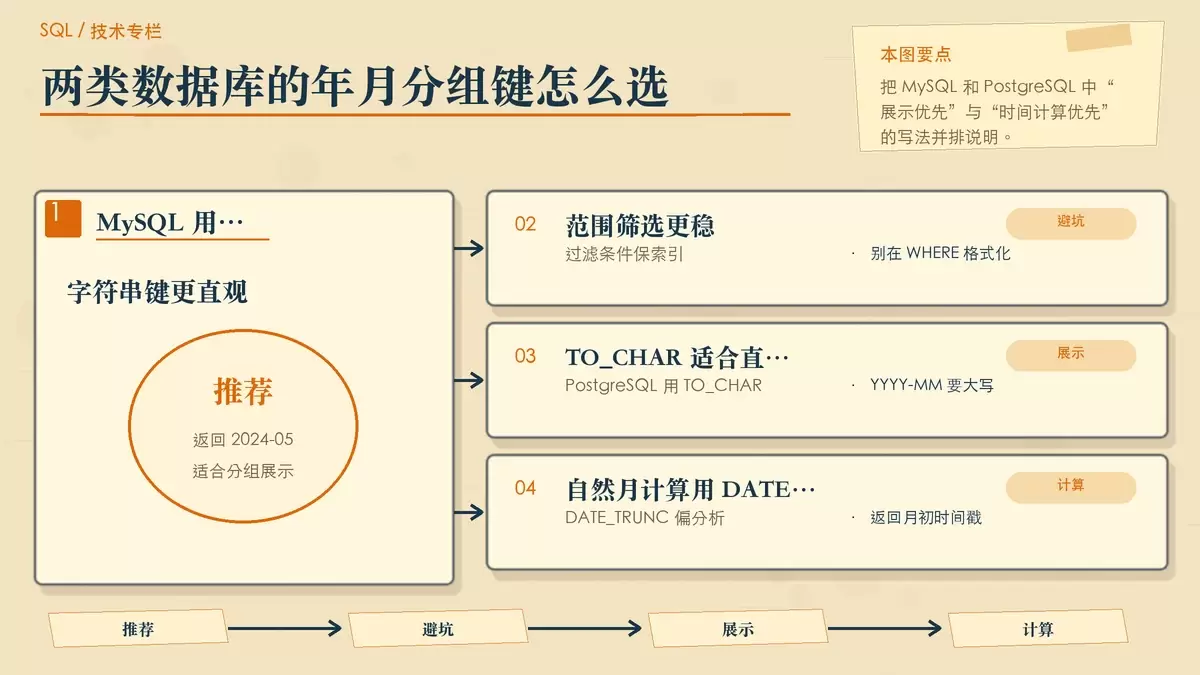
这里要特别留意格式模板的大小写。YYYY 表示四位年份,MM 表示补零月份;如果写成 YY 或 mm,结果就会出错,尤其在排查聚合异常时很隐蔽。
TO_CHAR(order_time, 'YYYY-MM')除了 TO_CHAR,PostgreSQL 里还有一个常见方案是 DATE_TRUNC('month', order_time)。它返回的不是字符串,而是类似 2024-05-01 00:00:00 的时间戳,适合后续还要做时间差、窗口计算或进一步时间运算的场景。
如果只是为了“每月一组”并直接展示,TO_CHAR 更轻;如果你要围绕自然月做更严谨的时间分析,DATE_TRUNC 往往更可靠。
这里也有一个和 MySQL 类似的误区:把 EXTRACT(YEAR FROM order_time) 与 EXTRACT(MONTH FROM order_time) 拆开使用,再在别处自己拼接。这样做不但步骤更多,也同样会遇到 2024-1 与 2024-10 这种格式歧义问题。
SQL Server:能不用 FORMAT 就别用
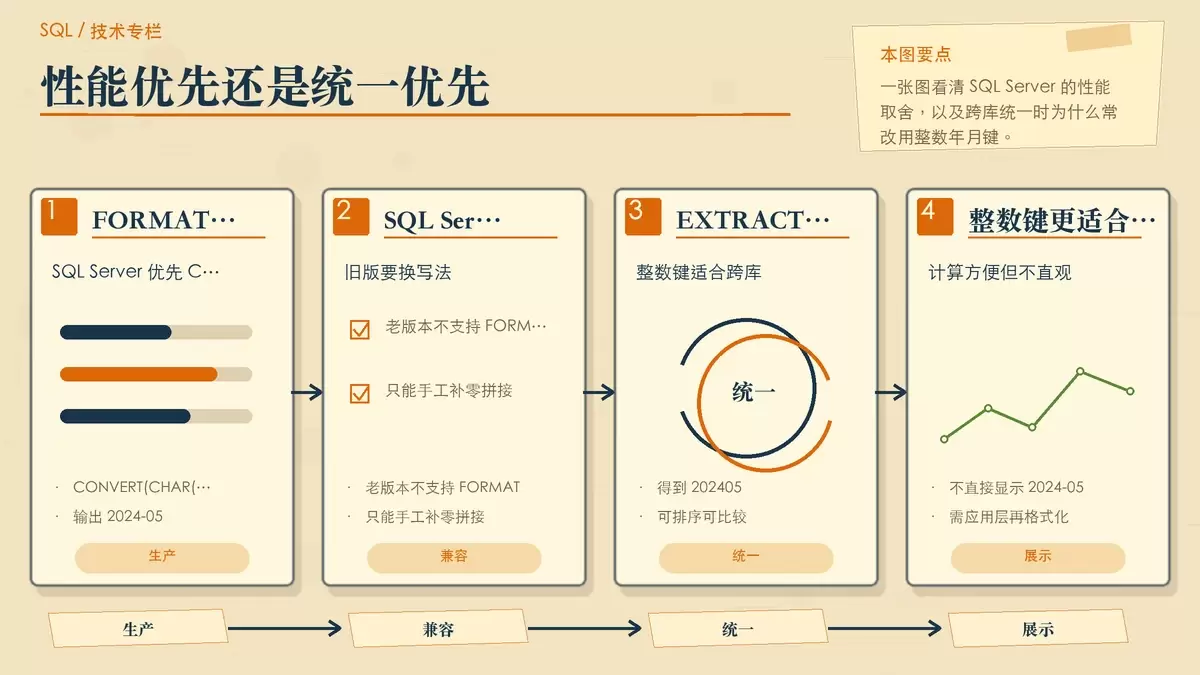
在 SQL Server 里,SQL Server 2012+ 确实支持 FORMAT(order_time, 'yyyy-MM'),语法很直观,初看也最像现代写法。但在生产环境里,它往往不是优先选项。
原因很简单:FORMAT 的开销偏高,尤其在大表或高频统计里,性能通常会比 CONVERT 慢好几倍。更稳的做法是:
CONVERT(CHAR(7), order_time, 120)这个写法会直接拿到 '2024-05' 这样的结果,而且不依赖 .NET 格式化引擎,执行代价更可控。
例如:
CONVERT(CHAR(7), '2024-05-15 14:22:03', 120)返回值就是 '2024-05',对于按月分组已经足够。
这部分尤其要注意几个性能和兼容性细节:
FORMAT一旦出现在WHERE或JOIN中,几乎可以默认会让索引利用率变差。- 如果字段类型是
SMALLDATETIME,它的精度只有到秒,而且存在默认四舍五入,边界时间的归属要额外留心。 - SQL Server 2008 及更早版本不支持
FORMAT,这时只能退回到手工拼接方案。
兼容旧版本时,可用下面这种写法:
RIGHT('0000' + CAST(YEAR(order_time) AS VARCHAR), 4) + '-' + RIGHT('00' + CAST(MONTH(order_time) AS VARCHAR), 2)它虽然冗长,但在老环境里是可用的。
跨数据库场景:用整数年月键更容易统一
如果项目要同时兼容多种数据库,或者你正在写一套尽量贴近标准 SQL 的逻辑,那么与其强求每个库都输出同样的字符串格式,不如先统一成整数年月键。
一个常见做法是:
EXTRACT(YEAR FROM order_time) * 100 + EXTRACT(MONTH FROM order_time)这样可以得到类似 202405 的整数值。它的优点很明确:可比较、可排序,也不受语言环境或日期格式设置影响。对于很多数据库来说,数值表达式在优化上也更直接。
这套思路在 PostgreSQL 和 MySQL 中都可以直接使用;如果换到 SQL Server,则对应写法是:
YEAR(order_time) * 100 + MONTH(order_time)整数键还有一个实际优势:接 BI 工具时,做时间轴切片、同比、环比等计算,通常会比直接拿字符串更顺手。
不过它也有明显限制。像 202405 这种键值适合分组和计算,却不适合直接作为前端展示结果。如果需要输出成 '2024-05',还得补一层 CASE 处理,或者交给应用层做格式化。
最后怎么选:先看数据库,再看索引和用途
把几种方案放在一起看,选择逻辑并不复杂:
- MySQL 里,展示和分组优先考虑
DATE_FORMAT(order_time, '%Y-%m')。 - PostgreSQL 里,想要直观结果就用
TO_CHAR(order_time, 'YYYY-MM'),要进一步做时间计算则考虑DATE_TRUNC('month', order_time)。 - SQL Server 里,生产环境通常优先
CONVERT(CHAR(7), order_time, 120),谨慎使用FORMAT。 - 跨库兼容时,整数年月键更容易统一,但展示层通常需要额外格式化。
真正上线时,不要只看写法是否简洁。年月字符串看着方便,但如果把函数直接塞进过滤条件,或者忽略字段类型和索引状态,查询一旦跑到大表上,执行计划往往就会立刻暴露问题。先确认数据库类型,再判断你是更看重展示、兼容,还是性能,通常就能选出更合适的那一套写法。















