



同比增长率看起来只是一个简单公式,但真正容易出错的地方在于“同期”二字。只要时间序列不连续、分组键不完整,很多人顺手写出的 LAG() 就会把同比算成环比。下面按判断逻辑、通用写法和排错信号三部分展开,帮助你先确认口径,再决定该用自连接还是窗口函数。
什么是同比增长率,为什么不能直接用 LAG()
同比增长率的标准公式是:(本期值 - 同期值) / 同期值。这里的“同期值”必须是上一年同一时间周期的数据,比如 2024 年 3 月要对比 2023 年 3 月,而不是简单对比结果集中的上一行。
这也是很多 SQL 写法出错的根源。像 LAG(value, 1) 这样的写法,取到的是“前一行”,通常对应相邻月份或相邻记录,本质更接近环比,而不是同比。只要数据里有缺月、跳月,或者同一个分组的数据并不严格连续,结果就会被悄悄带偏,而且不一定会直接报错。
因此,算同比时要先把时间维度对齐,再去关联“当前周期”和“去年同周期”。常见做法有两类:一种是先聚合后自连接,兼容性最好;另一种是在时间序列补齐后再用 LAG(value, 12),但前提比较严格。
用 LEFT JOIN + 日期偏移计算同比
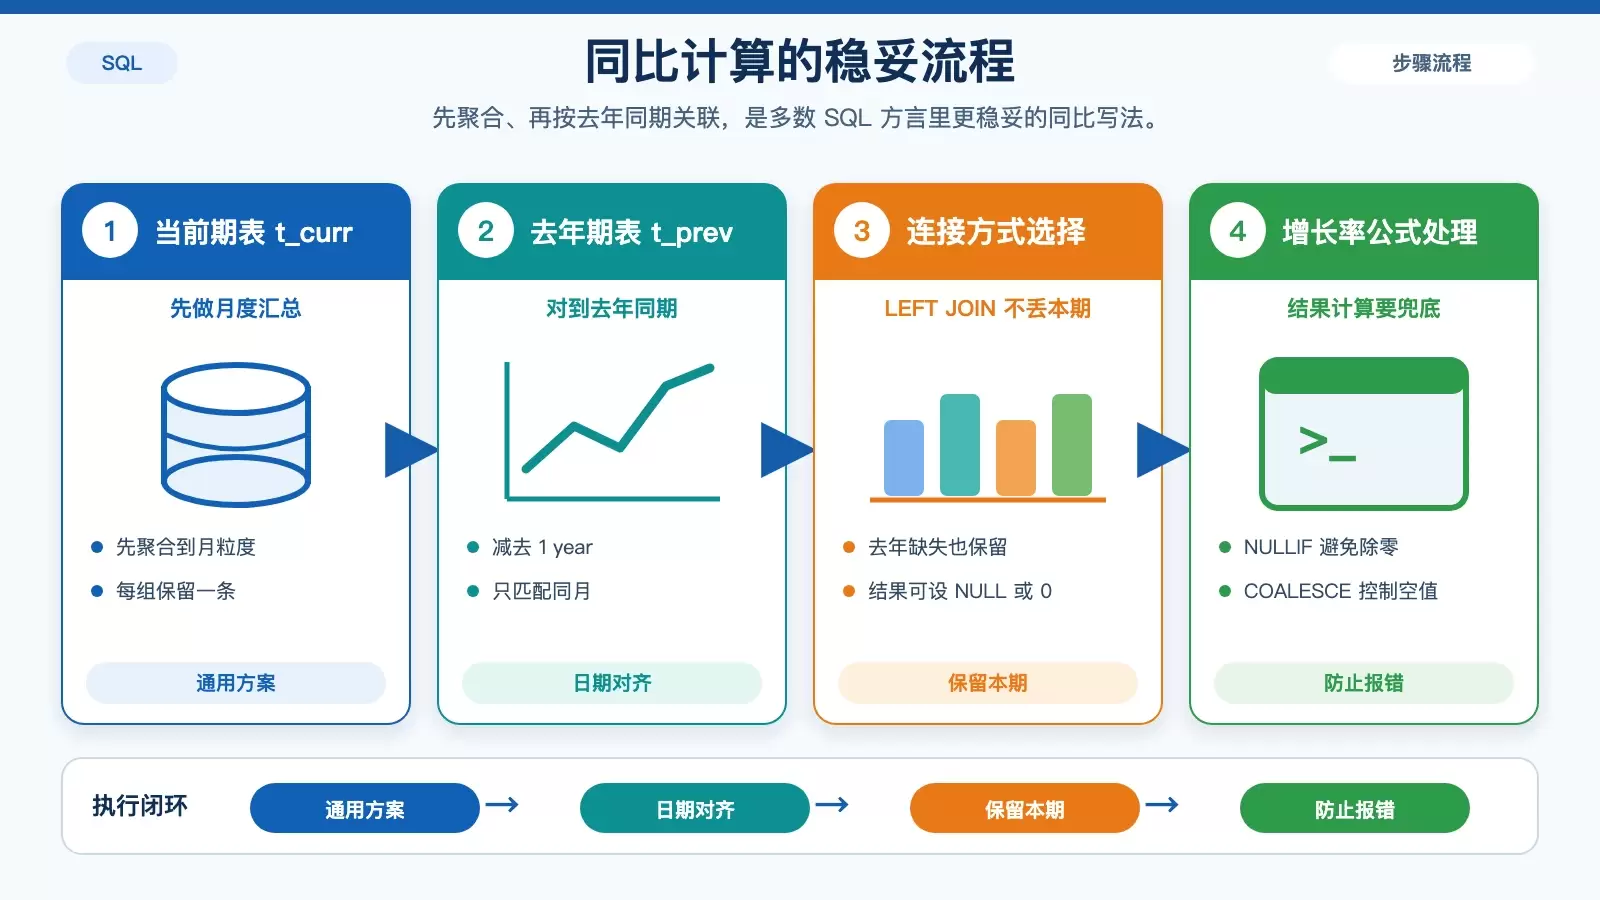
如果你希望写法稳、兼容性强,而且后续还要做索引优化或排查问题,优先考虑 LEFT JOIN。这种方法适用于 MySQL、PostgreSQL、SQL Server 等常见数据库,核心思路也比较直观:先得到“本期数据”,再去找“去年同月”的对应值。
实现思路
- 先按
year、month,或者按date_trunc('month', order_date)把原始数据聚合成每组每月一条记录,形成当前周期表,例如t_curr - 再准备去年同期表
t_prev,通过日期减去 1 年来建立对应关系。MySQL 常用DATE_SUB(..., INTERVAL 1 YEAR),PostgreSQL 常用- INTERVAL '1 year' - 使用
LEFT JOIN把本期记录和去年同期记录关联起来,这样即便去年没有数据,本期数据也不会丢失 - 最后计算增长率时,用
NULLIF避免除零,用COALESCE控制空值结果是保留为NULL还是转成0
PostgreSQL 示例
SELECT
t_curr.year_month,
t_curr.group_name,
ROUND(
COALESCE((t_curr.total - t_prev.total) * 1.0 / NULLIF(t_prev.total, 0), 0),
4
) AS yoy_rate
FROM monthly_sales t_curr
LEFT JOIN monthly_sales t_prev
ON t_curr.group_name = t_prev.group_name
AND t_prev.year_month = t_curr.year_month - INTERVAL '1 year';
这段 SQL 的好处在于,逻辑和业务定义是一一对应的:本期是谁、同期是谁、缺失时怎么处理,都能直接看出来。对资讯站读者来说,这种写法也更容易调试,因为一旦结果不对,可以先单独查 t_curr 和 t_prev 是否聚合正确,再检查关联条件是否完整。
另外,增长率缺失后到底显示 NULL 还是 0,不要只看技术实现,还要看业务口径。如果去年没有同期数据,把结果直接补成 0 虽然方便展示,但可能会掩盖“无可比基数”的事实,这一点在报表里要提前确认。
什么时候可以用窗口函数和 LAG(value, 12)
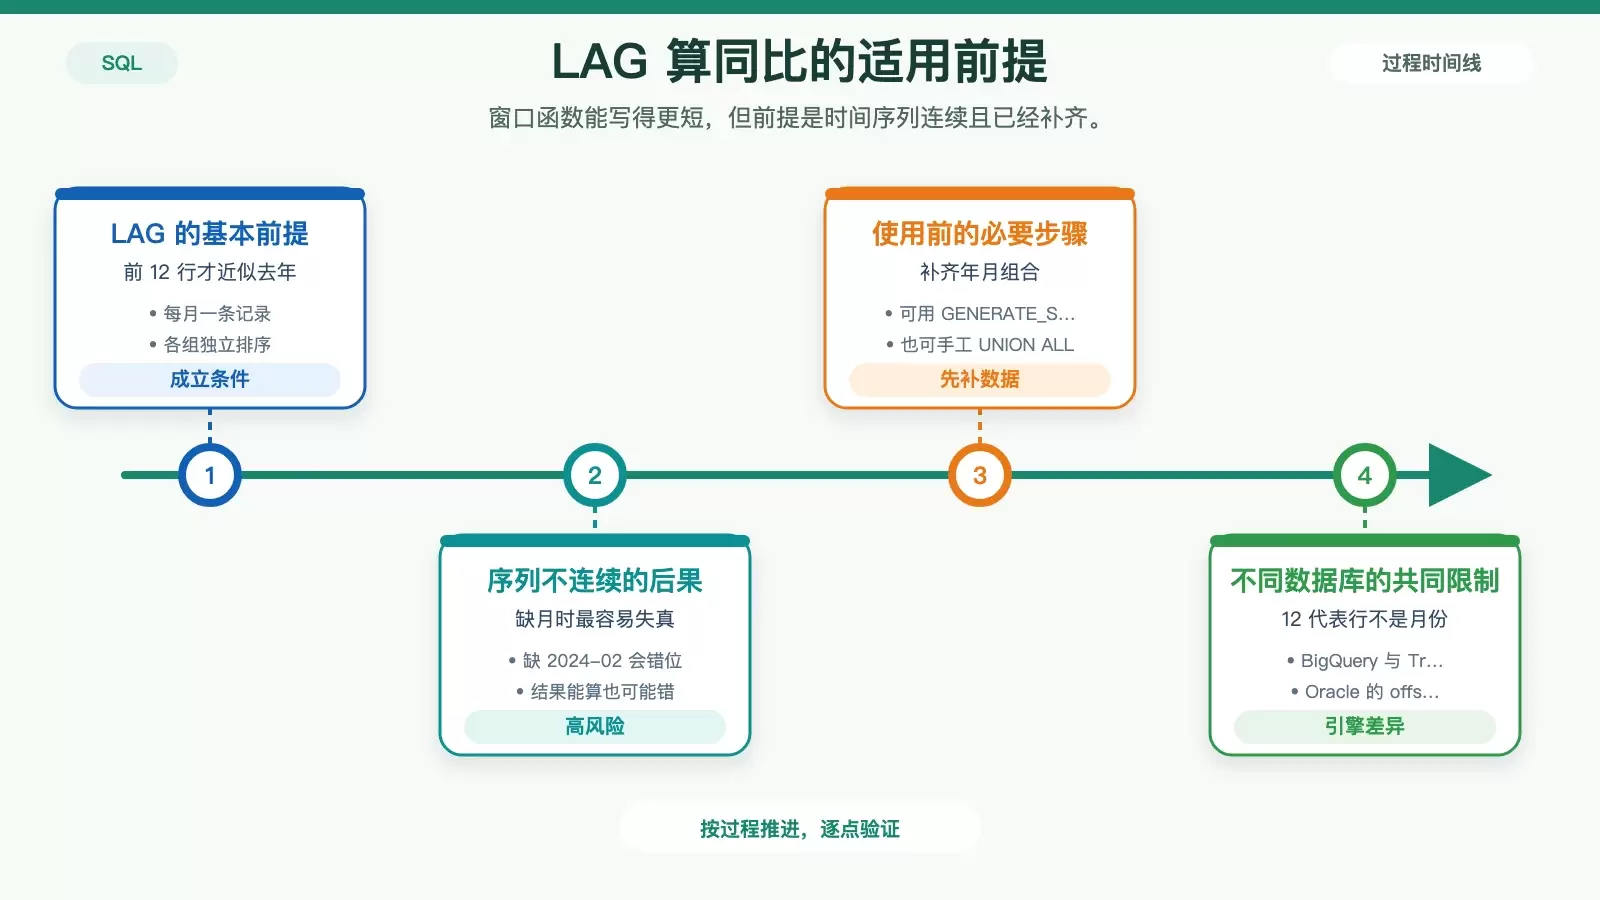
窗口函数并不是不能算同比,而是约束条件比很多人想象得更严格。像 BigQuery、Trino 以及部分新版 PostgreSQL,可以配合时间列排序来处理序列数据,但真正常见的写法还是 LAG(total, 12)。问题在于,12 表示前 12 行,不是天然代表前 12 个自然月。
只有在下面几个条件同时满足时,LAG(value, 12) 才近似等价于同比:
- 每个分组下严格做到每月一条记录
- 年月序列连续,中间没有缺失月份
- 排序字段稳定,通常要明确按
year, month排序 - 原始数据中的空档已经补齐
如果其中任何一个条件不满足,LAG(..., 12) 都可能取错行。比如缺了 2024 年 2 月的数据,那么往前 12 行时,很可能拿到的不是 2023 年 3 月,而是别的月份,结果表面上能算出来,实际已经偏离同比定义。
必须先补全时间序列
因此,若你一定要用 LAG,先补齐所有年月组合再说。PostgreSQL 可以借助 GENERATE_SERIES,其他数据库也可以用 UNION ALL 等方式手工构造完整日历表,然后再和原始聚合结果做 LEFT JOIN。只有把缺失月份显式补出来,窗口函数按 12 行回看才有意义。
还有一个常见误区是 Oracle 中的 LAG(value, 12)。这里的 12 同样是行偏移,不是“12 个日历月”。如果数据表不是天然连续的月序列,就不能直接把它当同比使用。
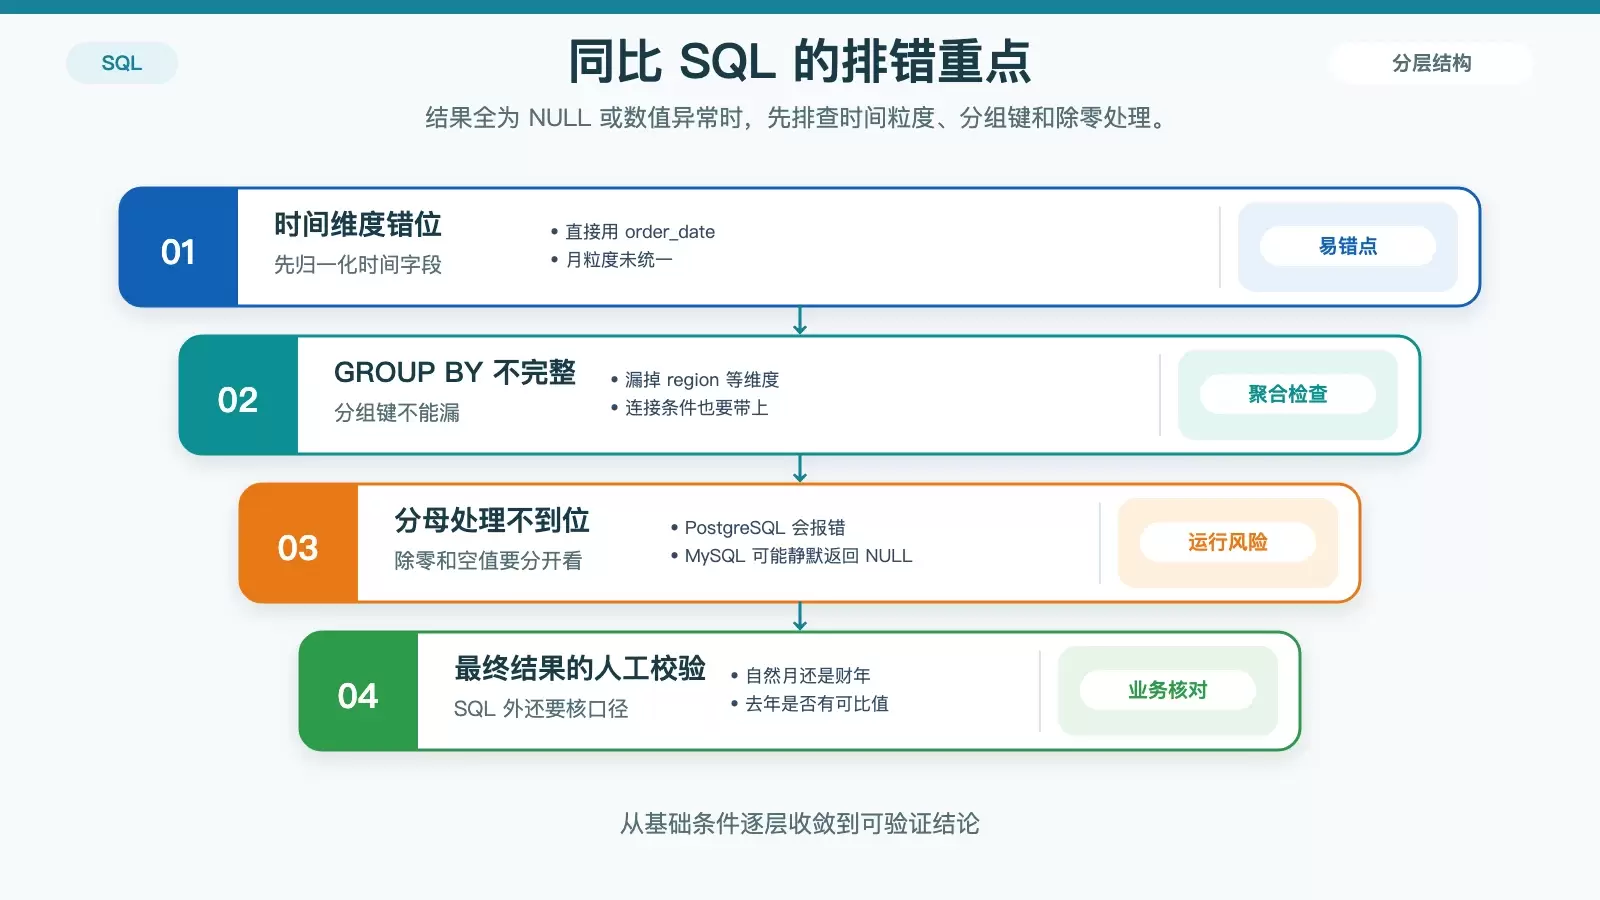
分组后计算同比失败的三个典型信号
很多同比 SQL 不是写不出来,而是写完后结果全是 NULL、值明显不对,或者不同数据库表现不一致。遇到这种情况,通常先看下面三个位置。
1. 时间字段没有归一化
如果直接拿 order_date 去分组或排序,而不是先统一到月、季度这样的业务粒度,就容易出现错位。比如你写了按年、月提取字段,但底层数据仍是日级记录,那么同一个月的多行数据和跨年边界混在一起后,窗口函数就可能在错误的位置取值。
更稳妥的方式是先生成统一的时间键,例如月度报表就先落成 year_month,季度报表就先落成季度字段,再进入后续同比计算。
2. GROUP BY 漏掉业务分组键
这是报表类 SQL 中非常常见的问题。比如你想按 region 看同比,却只按年份或月份聚合,最后得到的就是所有地区混合后的总值,再去同比自然会失真。
判断方法很简单:凡是你希望在结果中独立展示的维度,通常都应该同时出现在聚合和关联条件里。对于示例中的 group_name,它既要参与当前期聚合,也要出现在与去年同期的连接条件中,否则不同组别之间会相互串值。
3. 没处理除零和空值
同比公式里分母是去年同期值,所以只要去年同期为 0 或者不存在,就会触发异常或返回空值。这里至少要明确两层处理:
- 用
NULLIF(denominator, 0)规避除零 - 再根据报表需求决定是否用
COALESCE(..., 0)把结果补成 0
不同数据库的表现也不一样。PostgreSQL 遇到除零通常直接报 division by zero;MySQL 可能返回 NULL,但不会明显提示,这就容易让人误判成“去年没数据”。因此,别只盯着最终结果,先把分母列单独查出来看一遍,往往更快。
落地时先确认口径,再决定写法
从实现角度看,最稳妥的路径依然是先统一时间粒度,再用 LEFT JOIN + 去年同期偏移 计算同比;只有在时间序列已经补齐、每组严格连续的前提下,LAG(value, 12) 才适合作为简化写法。
真正难的部分通常不在 SQL 语法,而在业务口径确认上。你需要核对的是:当前报表到底按自然月、财年还是业务自定义周期统计;去年同期是否存在有效可比数据;缺失值和零值在报表上分别该怎么展示。把这些条件先确认清楚,再回头选 SQL 写法,结果才不会看着正确、实际跑偏。















