


python必背源代码线程池ThreadPoolExecutor代码
本文详解 Python 官方标准库 concurrent.futures.ThreadPoolExecutor 线程池核心必背源代码模板,涵盖 submit、map、as_completed 经典范式、核心架构原理、异常兜底及生产避坑指南。
在 Python 编写爬虫批量抓取、调用第三方 RESTful API、并行读写本地海量小文件或多源数据聚合时,频繁创建和销毁原生线程会带来昂贵的系统上下文切换与栈内存开销。Python 官方标准库 concurrent.futures 模块提供的 ThreadPoolExecutor(线程池执行器)是目前最规范、最安全且工业级通用的解决方案。掌握其经典范式与核心代码,能够以极低心智负担写出高效健壮的并发程序。
一、核心必背代码模板(直接可运行的标准范式)
在实际生产中,使用线程池最推荐的语法结构是上下文管理器(with 语句)搭配 submit() 与 as_completed()。该模式不仅能保证所有任务执行完毕后自动回收线程资源,还能在任务完成的第一时间拉取结果,避免因等待个别长耗时任务而阻塞整体流程。
1. 核心必背范式:submit() + as_completed() 模板
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def task_worker(task_id: int, duration: float) -> str:
    """
    业务处理单元函数(例如发送网络请求或处理数据)
    """
    time.sleep(duration)
    # 模拟偶发业务异常,验证线程池的异常捕获机制
    if task_id == 4:
        raise ValueError(f"任务 {task_id} 模拟业务数据解析异常")
    return f"任务 {task_id} 成功完成 (耗时 {duration}s)"

def run_thread_pool():
    # 准备任务列表:每个任务传入独立的参数与模拟耗时
    tasks = [(1, 1.5), (2, 0.8), (3, 2.0), (4, 1.0), (5, 0.5)]

    # 1. 创建线程池上下文,max_workers 指定最大工作线程数
    with ThreadPoolExecutor(max_workers=3, thread_name_prefix="Worker") as executor:
        # 2. 提交任务,并使用字典记录 {future: 任务参数},用于追踪溯源
        future_to_task = {
            executor.submit(task_worker, t_id, dur): t_id
            for t_id, dur in tasks
        }

        # 3. as_completed 监听完成状态:先完成的任务优先出队
        for future in as_completed(future_to_task):
            task_id = future_to_task[future]
            try:
                # 4. 获取返回值。如果任务抛出异常,将在 .result() 处重新抛出
                result = future.result()
                print(f"[成功] 任务 ID: {task_id} -> {result}")
            except Exception as exc:
                # 5. 单个任务异常被隔离捕获,不影响其他并发任务正常执行
                print(f"[失败] 任务 ID: {task_id} 执行发生异常: {exc}")

if __name__ == "__main__":
    run_thread_pool()
注意观察上述输出顺序:任务 5 耗时仅 0.5 秒,最先产出结果;任务 4 抛出的异常被精准定位到任务 ID 并打印出来,没有中断其它任务;with 代码块退出时,主线程会自动等待所有工作线程清理并优雅退出。
2. 极简批量映射范式:executor.map() 模板
如果你的任务参数形式完全一致(例如对一个 URL 列表做同样的下载操作),且要求返回的结果必须与输入序列的顺序严格一致,可以使用如同内置 map() 般简洁的 executor.map() 模板:
import time
from concurrent.futures import ThreadPoolExecutor

def square(num: int) -> int:
    time.sleep(0.5)
    return num * num

def run_map_pool():
    numbers = [1, 2, 3, 4, 5]
    with ThreadPoolExecutor(max_workers=3) as executor:
        # map 接收函数和可迭代对象,返回结果迭代器(按 numbers 原始顺序 yield)
        results = executor.map(square, numbers)
        for num, res in zip(numbers, results):
            print(f"输入: {num} -> 平方结果: {res}")

if __name__ == "__main__":
    run_map_pool()
二、ThreadPoolExecutor 核心架构与底层运行机理
要想在工程中灵活自如地驾驭线程池,必须理解其内部四大核心组件之间的协同协作关系:
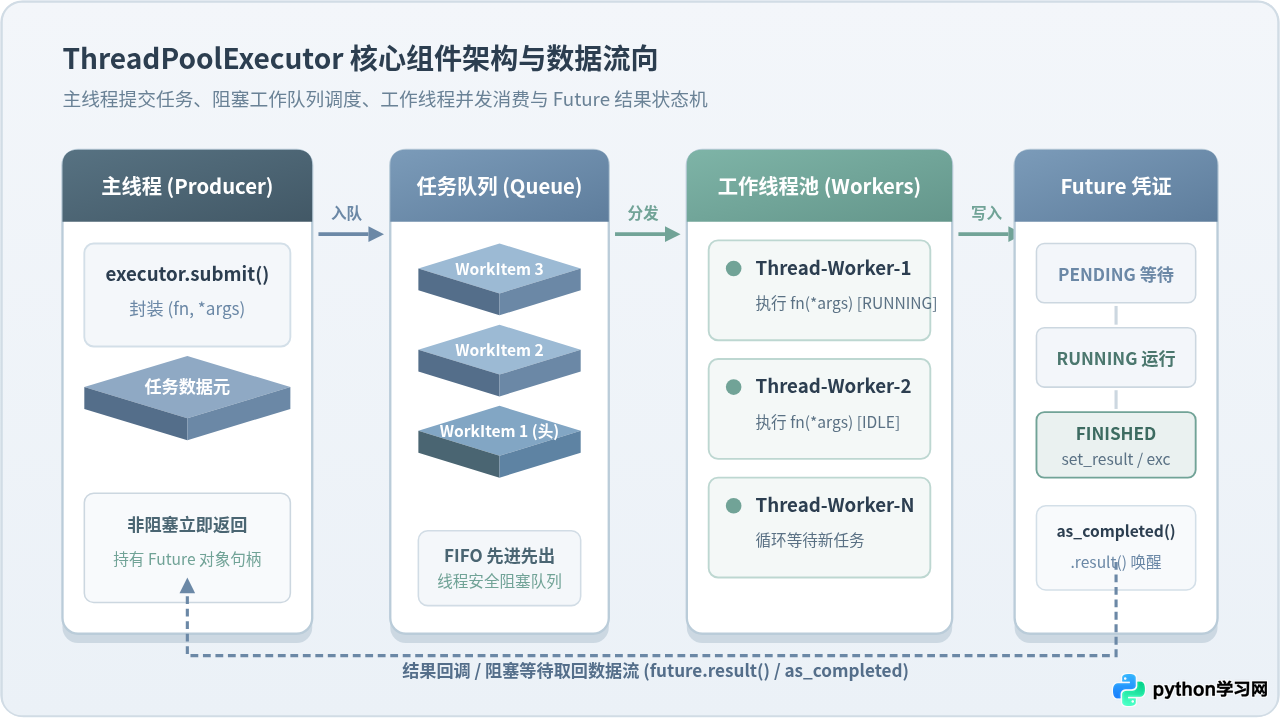
如图 1 所示,整个线程池由以下关键部分构成:
- 主线程与任务生产者:调用
executor.submit()时,主线程不会阻塞等待任务执行,而是把函数指针与参数封装成_WorkItem对象压入队列,并立即向主线程返回一个未完成的Future对象。 - 任务阻塞队列(Work Queue):线程池内部维护一个线程安全的 FIFO 阻塞队列(默认无界队列
queue.SimpleQueue)。当工作线程空闲时,会自动从中取出任务。 - 工作线程集合(Worker Threads):池中驻留不超过
max_workers数量的常驻线程。线程反复从队列抓取任务并执行fn(*args, **kwargs),执行完毕后转入 IDLE 状态继续等待下一个任务。 - Future 状态机与凭据对象:每个任务执行前后经历
PENDING(排队中)->RUNNING(运行中)->FINISHED(完成或异常)的状态迁移。执行得到的值或捕获的异常会被写入 Future 内部。主线程通过future.result()或as_completed()来监听与提取该状态。
三、submit() 与 map() 的核心差异与选型决策
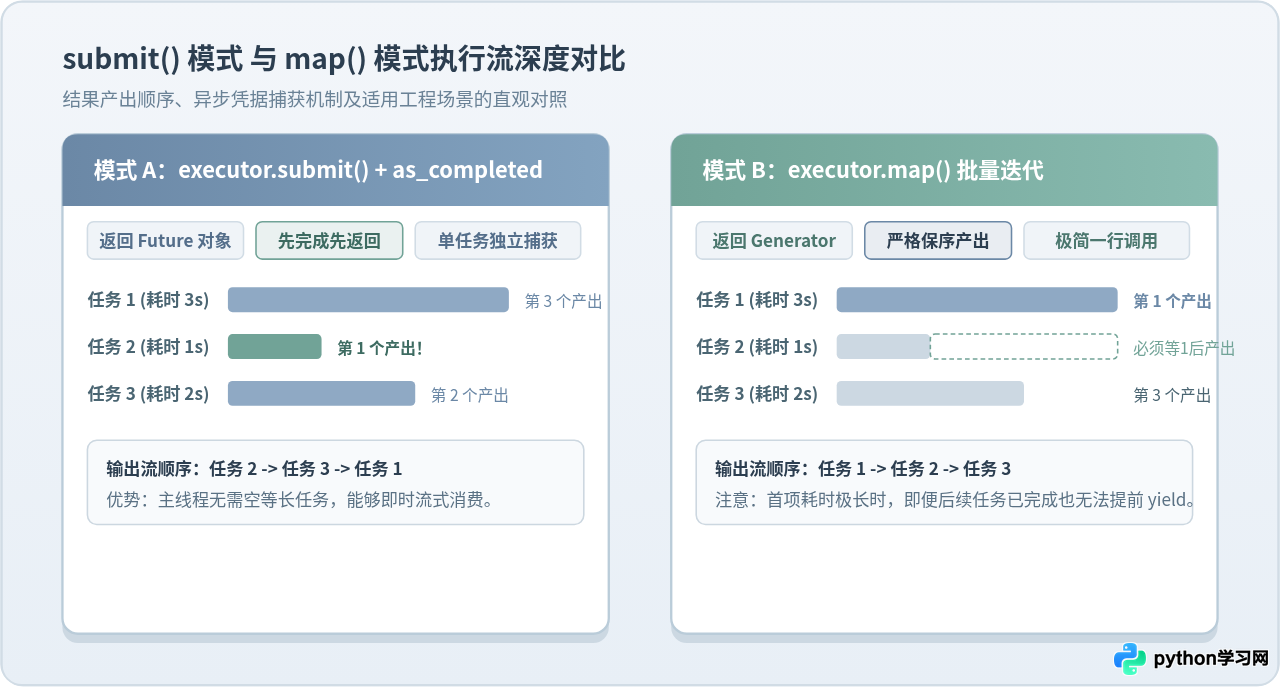
初学者最常纠结的问题是:何时使用 submit(),何时使用 map()?两者的深层机制存在显著差异:
| 对比维度 | executor.submit() + as_completed() | executor.map() |
|---|---|---|
| 返回值类型 | 返回单个 Future 对象,可放入集合或字典中管理 |
返回一个包含实际计算结果的生成器迭代器 |
| 结果返回顺序 | 完成优先(乱序):耗时短的任务先返回,流式处理极快 | 严格保序:即使后面的任务早跑完,也必须等前面的项产出 |
| 异常抛出时机 | 只有主动调用 future.result() 时才在该处抛出异常,便于单点 try/except |
在 for result in results: 迭代到抛异常的那一项时直接抛出 |
| 任务传参灵活性 | 高。每个任务可以传入不同数量、不同类型的参数 | 中等。参数必须是对齐的可迭代集合(类似 zip()) |
| 超时控制支持 | 支持在 future.result(timeout=...) 或 as_completed 上设单项超时 |
支持在 map(..., timeout=...) 上设置整轮迭代超时 |
| 典型适用场景 | 网络爬虫、响应时间不确定的异构 API 请求、需精准记录出错项 | 批量图片无序转格式、数学计算批量映射、输入输出严格对应的报表计算 |
四、生产级线程池标准操作步骤(6 大规范)
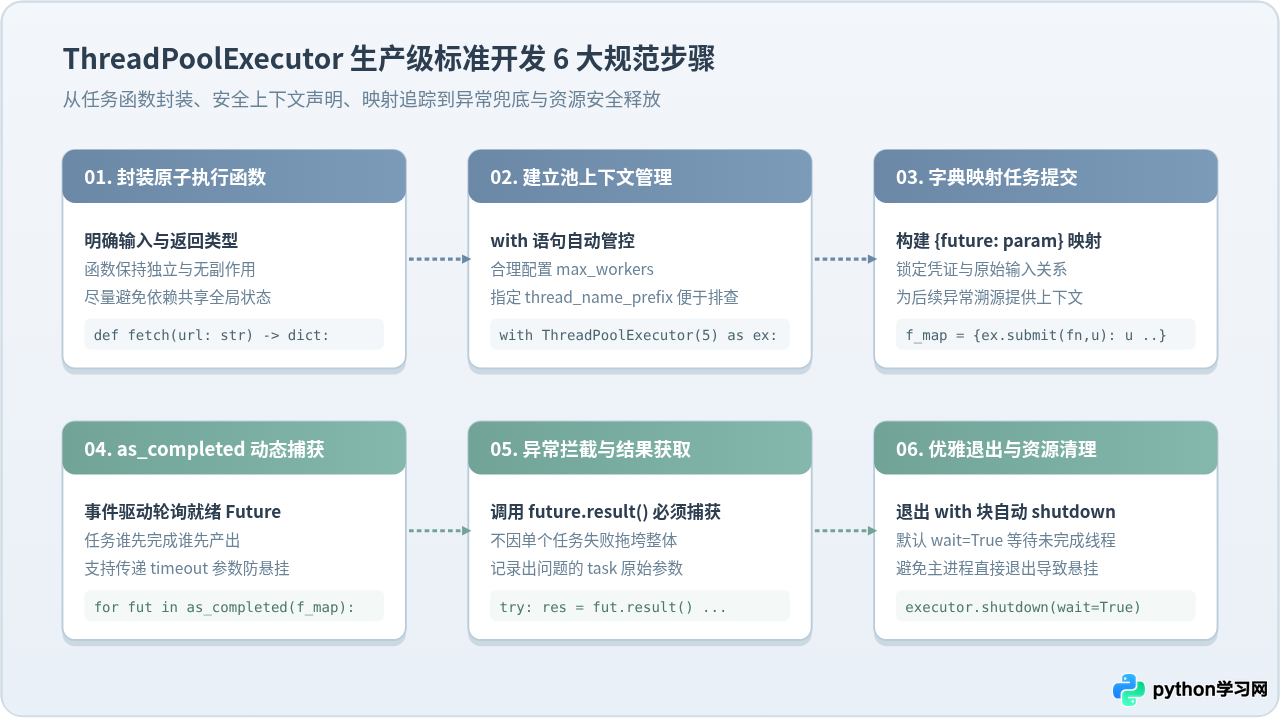
在正式的企业级后端服务或脚本工具中,为了保证系统具备容错性与健壮性,建议读者遵循以下 6 步标准操作规程进行编写:
-
步骤 1:封装独立的原子工作单元函数
工作函数应有清晰的入参与返回值类型注解,并保证任务尽量自包含,避免隐式依赖未加锁的全局可变对象(如全局字典、文件句柄等)。 -
步骤 2:使用上下文管理器声明线程池
始终采用with ThreadPoolExecutor(max_workers=..., thread_name_prefix=...) as executor:。给线程加上前缀可以在日志或排查断点时清晰区分哪一条日志来自哪一个 Worker 线程。 -
步骤 3:提交任务并维护上下文映射字典
不要直接将executor.submit()的返回值丢弃到无序列表里,而应使用future_to_param = {executor.submit(fn, item): item for item in items}。这样在后续解析中,无论哪一个任务报错,都能立刻得知是针对哪一条数据出错了。 -
步骤 4:通过 as_completed 建立事件驱动消费流
使用for future in as_completed(future_to_param):,使主线程以事件驱动方式第一时间获得处理完成的通知,显著缩短多任务整体流水线端到端时延。 -
步骤 5:安全解包结果与隔离异常
必须在循环体内包含try...except块包裹future.result()。这样即使其中 10% 的网络请求因为超时或断网失败,剩下的 90% 数据依然能够被正常处理和持久化。 -
步骤 6:依赖上下文自动触发安全优雅关闭
退出with作用域时,Python 解释器会自动调用executor.shutdown(wait=True),它会阻止外部向池中提交新任务,并安全等待当前仍在执行中的工作线程处理完毕,绝不会造成线程悬挂(dangling threads)。
五、核心参数配比与生产环境避坑指南
许多开发者在多线程编程中往往会遇到“开了多线程反而更慢”、“程序内存暴涨”或者“异常不报错直接没了”等诡异现象。以下是必须牢记的避坑法则:
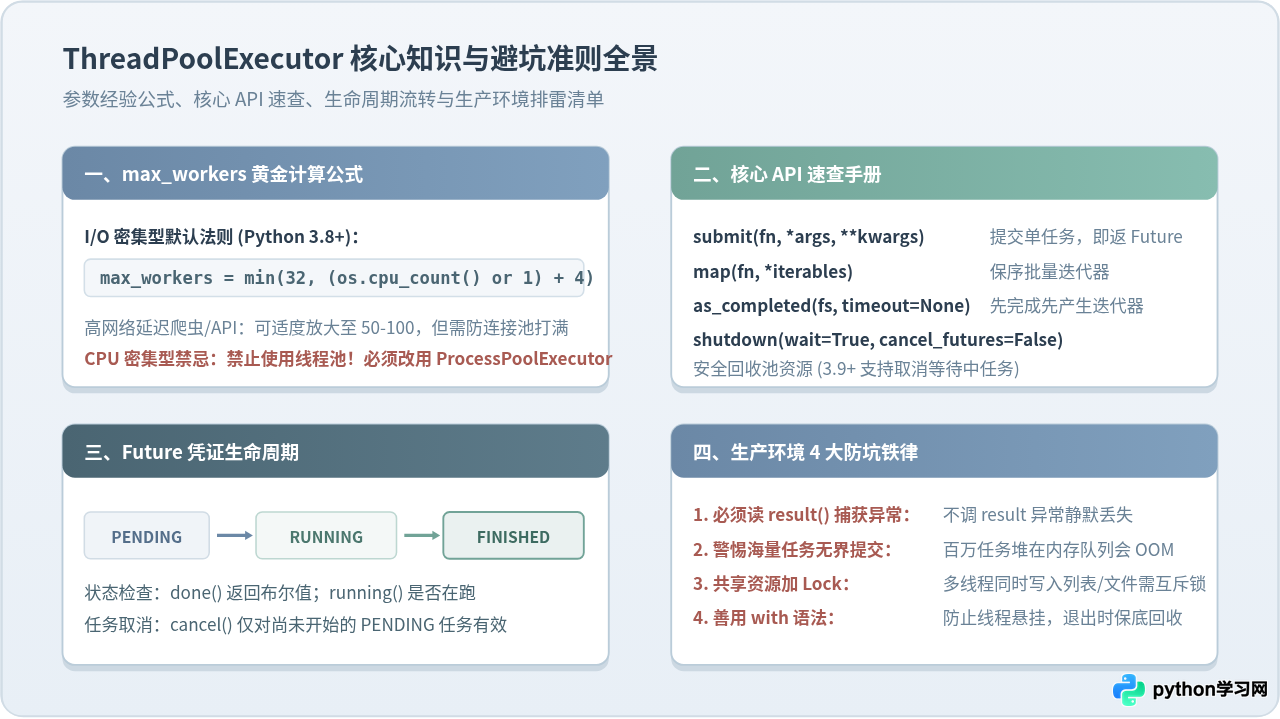
1. max_workers 的黄金计算法则
线程数绝对不是越大越好。在 Python 中,由于 GIL(全局解释器锁)的存在,同一时刻只能有一个线程在 CPU 核心上执行 Python 字节码:
- I/O 密集型任务(网络、磁盘、数据库等):当线程遇到网络阻塞或 I/O 等待时,会自动释放 GIL,此时多线程并发收益极大。自 Python 3.8 起,官方采用的默认公式为:
max_workers = min(32, (os.cpu_count() or 1) + 4)
若为高延迟外网请求,可根据目标服务的并发承载能力和本机端口连接池大小微调至 20~100,避免设置成数千导致系统频繁上下文切换崩溃。 - CPU 密集型任务(图像处理、加解密、复杂科学计算):在 GIL 限制下,多线程不仅无法利用多核加速,还会因线程频繁抢锁导致运行速度慢于单线程。针对此类场景,必须将
ThreadPoolExecutor替换为ProcessPoolExecutor(进程池)。
如果在提交任务后既没有调用 future.result(),也没有使用 as_completed,那么即便任务函数内部抛出了 ZeroDivisionError、IndexError 或网络异常,该异常也会被静默地保存在 Future 对象内部,程序在控制台上不会有任何报错信息,导致严重隐患!
由于 ThreadPoolExecutor 内部的工作队列是无界的,如果你写出 for i in range(10_000_000): executor.submit(...),即使 max_workers=5,系统也会瞬间在内存中创建一千万个 Future 和 _WorkItem 对象,直接打爆内存导致 OOM(内存溢出崩溃)。针对超大规模数据集,应使用信号量(threading.Semaphore)或按批次(batch)分块提交。
虽然 Python 的某些单条操作(如 list.append)是原子操作,但在业务逻辑中“先判断再修改”复合逻辑(例如自增计数器 count += 1、更新字典内部嵌套状态、写入同一日志文件)绝非线程安全。在多个线程需要修改共享数据时,必须显式引入 threading.Lock() 配合 with lock: 使用,防止数据错乱竞争。
总结与记忆口诀
最后,我们将 ThreadPoolExecutor 的核心用法归纳为一句简短的开发口诀,便于在面试和日常实战中随时默写与默念:
submit 字典做映射,as_completed 先做完先得;
result 查验防静默,CPU 密集换进程池。”
只要在代码编写过程中牢记上述 6 步规范,结合具体业务耗时合理配置 max_workers,并在提取结果时严格做好异常兜底,就能在实际工程中安全、稳定地发挥出 Python 多线程并发的最佳性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















