


Python爬取微信公众号文章:API接口与网页抓取两种方法
本文详细讲解使用Python爬取微信公众号文章的两种主流实用方案:基于微信公众平台后台API接口与基于搜狗微信网页自动化抓取,涵盖核心原理、完整代码示例、反爬对策及选型对比。
一、微信公众号文章生态与反爬机制原理
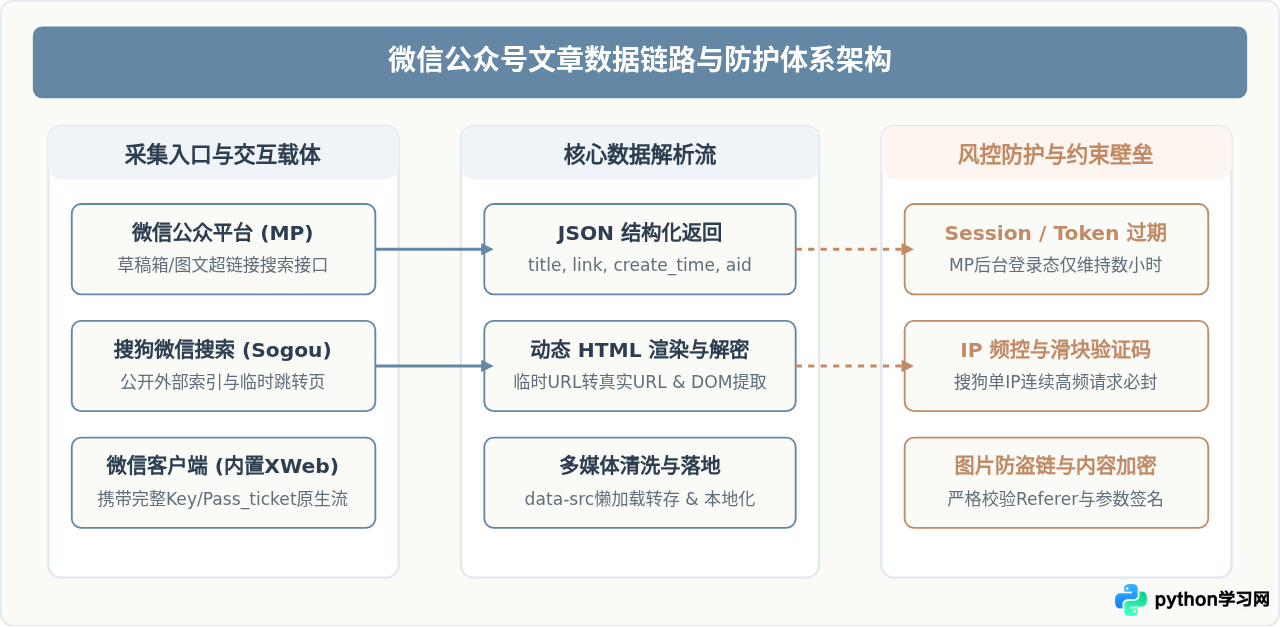
在编写抓取代码前,必须先看清微信文章的技术载体与其防御壁垒。公众号文章本质上是一套受控的 Web 页面,但它并不向普通公开网络直接暴露完整的历史列表分页接口。微信文章的分发依赖两套不同的核心参数链路:
- 永久唯一标识参数:包括代表公众号唯一身份的
__biz、代表文章消息批次的mid、文章内部位置序列idx以及内容校验签名的sn。这四个参数共同锚定了一篇独立文章。 - 动态鉴权会话参数:在微信客户端或公众平台内部流转时,伴随携带
key、pass_ticket、appmsg_token等时效性极强的校验串。缺少这些动态串,部分接口将拒绝下发阅读数、点赞数乃至历史图文列表。
此外,微信文章内的多媒体资源(尤其是图片)普遍采用 data-src 懒加载机制,且图片域名 mmbiz.qpic.cn 设置了 Referer 检查,未正确处理时易出现“此图片来自微信公众平台,未经允许不可引用”的占位图。
二、方法一:基于微信公众平台后台 API 接口抓取
这是目前针对特定目标公众号进行历史文章批量抓取时最稳定、结构最规范的技术手段。任何拥有普通个人订阅号或服务号的开发者,都可以在公众号后台利用“新建图文素材 -> 插入超链接”功能,调用微信官方后台提供的图文检索接口。
1. 运作原理与关键参数
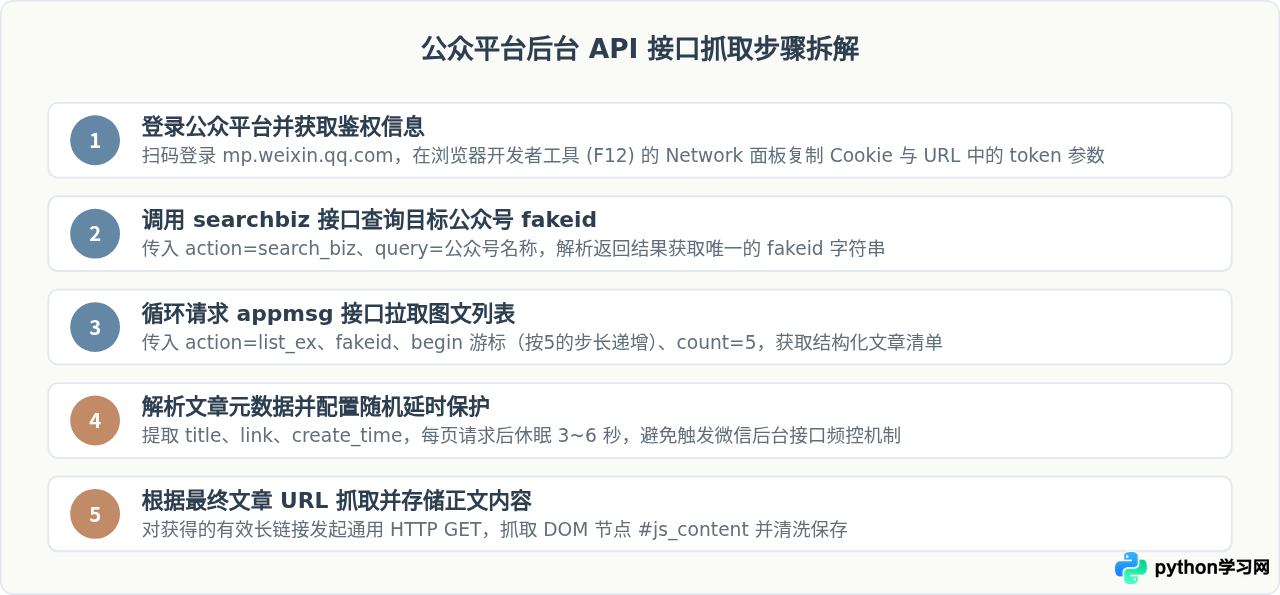
在公众平台写文章时,编辑器支持搜索其他公众号的文章并引用其链接。该过程实际上向服务端发送了两个关键接口请求:
/cgi-bin/searchbiz:根据输入的公众号名称(如“Python猫”或特定微信号),搜索并返回该公众号对应的内部唯一标识fakeid(即该公众号对外的__biz经过 Base64/内部映射的编码值)。/cgi-bin/appmsg:携带提取到的fakeid、当前登录管理员的token以及有效的Cookie,以分页的形式请求该公众号已发布的文章列表,直接返回包含标题、链接、发布时间等字段的纯 JSON 响应。
2. Python 完整实现示例
下面是一个使用 requests 库实现的完整自动化查询与翻页抓取脚本。执行前需替换自己的有效 COOKIE 和 TOKEN:
import time
import random
import requests

class WeChatMpApiScraper:
    def __init__(self, cookie_str: str, token: str):
        self.token = token
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
            "Referer": f"https://mp.weixin.qq.com/cgi-bin/appmsg?t=media/appmsg_edit_v2&action=edit&isNew=1&type=77&token={token}&lang=zh_CN",
            "Cookie": cookie_str
        })
        self.base_url = "https://mp.weixin.qq.com/cgi-bin"

    def get_fakeid(self, target_account_name: str) -> str:
        """根据公众号名称获取对应的 fakeid"""
        search_url = f"{self.base_url}/searchbiz"
        params = {
            "action": "search_biz",
            "begin": "0",
            "count": "5",
            "query": target_account_name,
            "token": self.token,
            "lang": "zh_CN",
            "f": "json",
            "ajax": "1"
        }
        resp = self.session.get(search_url, params=params, timeout=10)
        data = resp.json()

        if data.get("base_resp", {}).get("ret") != 0:
            raise RuntimeError(f"搜索公众号失败: {data.get('base_resp')}")

        biz_list = data.get("list", [])
        if not biz_list:
            raise ValueError(f"未找到公众号: {target_account_name}")

        target_biz = biz_list[0]
        print(f"匹配到公众号: {target_biz['nickname']} (fakeid: {target_biz['fakeid']})")
        return target_biz["fakeid"]

    def fetch_articles(self, fakeid: str, max_pages: int = 3):
        """分页获取图文列表"""
        appmsg_url = f"{self.base_url}/appmsg"
        articles = []

        for page in range(max_pages):
            begin = page * 5
            params = {
                "action": "list_ex",
                "begin": str(begin),
                "count": "5",
                "fakeid": fakeid,
                "type": "9",
                "query": "",
                "token": self.token,
                "lang": "zh_CN",
                "f": "json",
                "ajax": "1"
            }

            resp = self.session.get(appmsg_url, params=params, timeout=10)
            res_data = resp.json()

            if res_data.get("base_resp", {}).get("ret") != 0:
                print(f"获取文章列表受限或Token失效: {res_data.get('base_resp')}")
                break

            msg_list = res_data.get("app_msg_list", [])
            if not msg_list:
                print("已无更多历史文章。")
                break

            for item in msg_list:
                article_info = {
                    "title": item.get("title"),
                    "link": item.get("link"),
                    "create_time": item.get("create_time"),
                    "aid": item.get("aid")
                }
                articles.append(article_info)
                print(f"[{page+1}] 抓取到: {article_info['title']}")

            # 严格控制访问频次,避免触发后台频控
            sleep_duration = random.uniform(3.5, 6.0)
            time.sleep(sleep_duration)

        return articles

# 示例调用 (需替换实际凭据)
if __name__ == "__main__":
    MY_COOKIE = "slave_user=...; slave_sid=...; bizuin=...;"
    MY_TOKEN = "123456789"

    scraper = WeChatMpApiScraper(cookie_str=MY_COOKIE, token=MY_TOKEN)
    try:
        biz_id = scraper.get_fakeid("人民日报")
        results = scraper.fetch_articles(fakeid=biz_id, max_pages=2)
        print(f"共抓取到 {len(results)} 篇文章元数据")
    except Exception as e:
        print(f"抓取异常: {e}")
sn 的真实微信文章长链接,但不直接包含阅读量与在看量(阅读数接口需要微信移动客户端环境的 key 才能调取)。
三、方法二:基于搜狗微信搜索与网页自动化抓取
如果手头没有可用的微信公众号管理后台,或者抓取目标是全网按关键词搜索聚合文章,搜狗微信搜索(weixin.sogou.com)则是首选公开渠道。搜狗是目前极少数拥有微信官方授权建立外网搜索索引的平台,支持按账号检索与按关键词检索。
1. 运作机制与中间跳转链解析
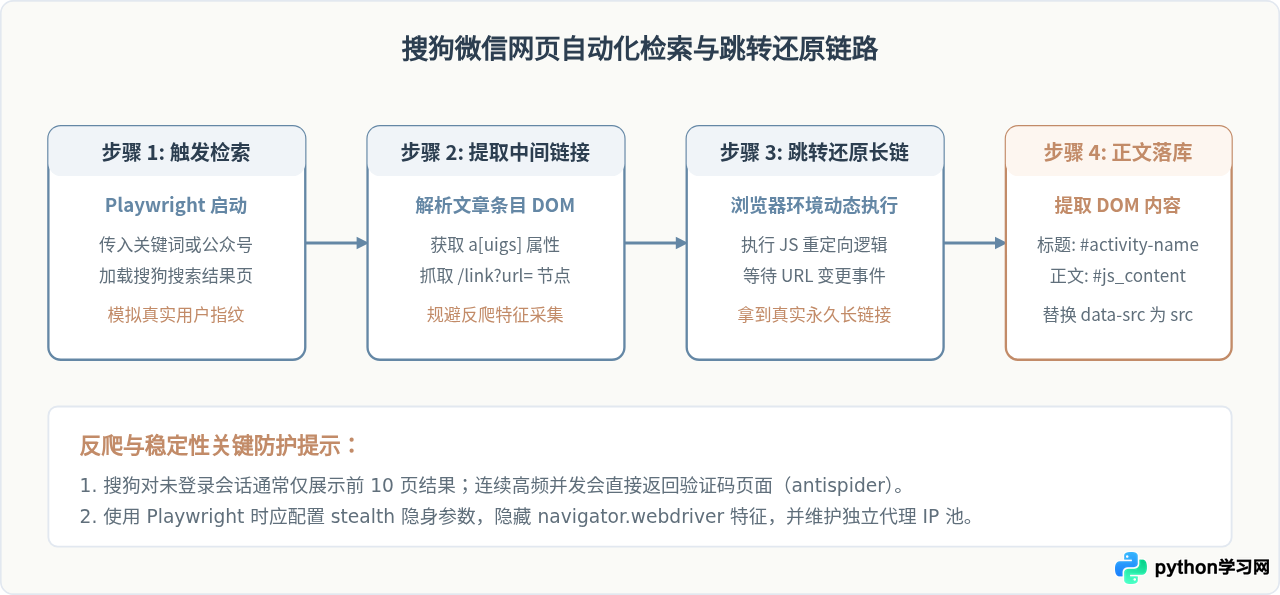
搜狗微信并不是直接展示微信文章的最终链接,而是采用了一套防爬转向机制:
- 列表页搜索:请求
https://weixin.sogou.com/weixin?type=2&query=关键词。搜狗服务端在 HTML 中返回匹配的简要文章卡片。 - 动态加密中间链接:卡片中的
<a href="/link?url=...">并非微信原生网址,而是经过搜狗自身算法混淆的中间重定向地址。 - 脚本计算与跳转:当用户点击链接时,搜狗页面加载一段微型 JavaScript 代码,在客户端拼接出一段带时间戳与防篡改签名的计算参数,最后通过
window.location.replace()跳转至真正的mp.weixin.qq.com/s?...页面。
对于这类包含前端脚本混淆与反爬重定向的页面,使用基于浏览器的无头自动化工具(如 Playwright 或 Selenium)比手写逆向 JS 更加健壮且抗变动。
2. Playwright 自动化网页抓取代码
在 Python 环境中执行 pip install playwright 并运行 playwright install chromium,使用如下脚本即可实现免逆向的搜狗微信自动化检索与正文清洗:
import asyncio
from playwright.async_api import async_playwright

async def scrape_wechat_by_sogou(keyword: str, max_articles: int = 5):
    """
    使用 Playwright 自动化检索搜狗微信并抓取文章正文
    """
    async with async_playwright() as p:
        # 启动 Chromium 浏览器,避免特征检测
        browser = await p.chromium.launch(
            headless=True,
            args=["--disable-blink-features=AutomationControlled"]
        )
        context = await browser.new_context(
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"
        )
        page = await context.new_page()

        # 访问搜狗微信文章检索接口
        search_url = f"https://weixin.sogou.com/weixin?type=2&query={keyword}"
        print(f"正在访问搜狗微信检索页面: {search_url}")
        await page.goto(search_url)

        # 检查是否遭遇验证码拦截
        if "antispider" in page.url:
            print("触发搜狗反爬验证码,请配置代理IP或减缓采集频次。")
            await browser.close()
            return []

        # 获取文章卡片列表
        article_items = await page.query_selector_all(".news-box .news-list li")
        print(f"当前页面共发现 {len(article_items)} 条搜索结果")

        collected_data = []

        for idx, item in enumerate(article_items[:max_articles]):
            title_elem = await item.query_selector("h3 a")
            if not title_elem:
                continue

            title = (await title_elem.inner_text()).strip()
            # 获取搜狗跳转链接
            intermediate_href = await title_elem.get_attribute("href")
            if not intermediate_href:
                continue

            full_link = f"https://weixin.sogou.com{intermediate_href}" if intermediate_href.startswith("/") else intermediate_href

            # 打开新标签页处理重定向并抓取正文
            detail_page = await context.new_page()
            try:
                await detail_page.goto(full_link, wait_until="domcontentloaded", timeout=15000)
                await detail_page.wait_for_timeout(2000)  # 等待JS自动跳转完成

                real_url = detail_page.url
                if "mp.weixin.qq.com" not in real_url:
                    print(f"[{idx+1}] 跳转未完成或仍在搜狗域名: {real_url}")
                    await detail_page.close()
                    continue

                # 提取微信文章正文元素
                content_elem = await detail_page.query_selector("#js_content")
                if content_elem:
                    # 将图片 data-src 替换为实际可用 src
                    await detail_page.evaluate("""
                        () => {
                            const imgs = document.querySelectorAll('#js_content img');
                            imgs.forEach(img => {
                                const realSrc = img.getAttribute('data-src');
                                if (realSrc) {
                                    img.setAttribute('src', realSrc);
                                }
                            });
                        }
                    """)
                    clean_html = await content_elem.inner_html()
                    collected_data.append({
                        "title": title,
                        "url": real_url,
                        "html_content": clean_html[:200] + "..."  # 示例截取
                    })
                    print(f"[{idx+1}] 成功采集文章: {title}")
                else:
                    print(f"[{idx+1}] 未定位到 #js_content 容器")

            except Exception as err:
                print(f"处理文章 [{title}] 时出错: {err}")
            finally:
                await detail_page.close()

            # 随机休眠防风控
            await asyncio.sleep(3.0)

        await browser.close()
        return collected_data

if __name__ == "__main__":
    articles = asyncio.run(scrape_wechat_by_sogou("Python技术", max_articles=2))
    print(f"采集结束,成功落地 {len(articles)} 篇正文。")
四、两种抓取方法的深度对比与选型指南
在实际工程选型中,不能孤立看待技术难易,而是要依据具体的业务需求(目标是监控特定账号的历史沉淀,还是全网按词汇抓取最新资讯)在两者之间权衡选择:
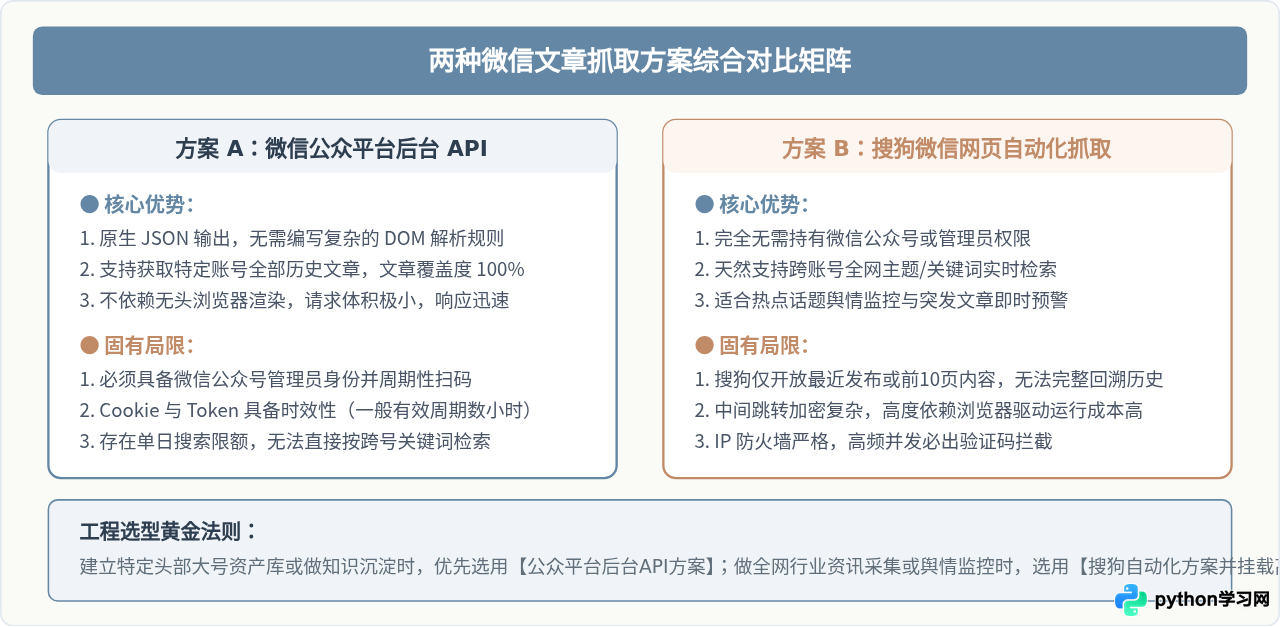
| 对比维度 | 公众平台后台 API 接口 | 搜狗微信网页自动化抓取 |
|---|---|---|
| 账号门槛 | 需要注册任意一个普通微信公众号并扫码登录 | 无需账号,打开网页即可访问 |
| 历史回溯能力 | 极强,可翻页抓取目标账号自注册以来的所有图文 | 较弱,搜狗搜索通常仅保留近期的 10 页索引结果 |
| 抓取数据格式 | 纯 JSON 数据,包含精确发布时间戳、永久链接 | HTML 页面,需解析临时中间链接后再重定向到真实页面 |
| 资源开销与速度 | 轻量 HTTP 请求,并发资源占用极低,单条响应百毫秒级 | 需常驻无头 Chromium 实例,CPU 与内存消耗较大 |
| 反爬触发机制 | 单日翻页次数超限后触发会话注销或封禁接口访问 | 单 IP 频繁访问直接触发滑块验证码与 IP 临时封禁 |
五、数据清洗落地与长期维护要点
在拿到微信文章的最终真实链接与 HTML 源码后,若要将内容用于知识库构建或排版归档,还需进行关键的清洗处理:
- 替换图片懒加载属性:微信文章内的
<img>标签几乎都不直接携带src,而是写入在data-src中。入库前必须使用脚本遍历所有图片节点,将data-src的值赋予src,否则直接渲染文章时所有图片均会显示为空白或损坏。 - 图片防盗链处理:由于微信图片服务器检测
Referer请求头,在前端展示抓取到的 HTML 时,可以在 HTML 页面的<head>中加入<meta name="referrer" content="no-referrer">,或在服务端下载图片转存至本地或专属对象存储中。 - 去除无用动态注入脚本:微信文章尾部常包含动态点赞动画、推荐阅读、举报模块等容器(例如
#js_toobar3、#js_cmt_area),在解析 DOM 时仅需截取#js_content节点并剥离外层不相关标签,即可获得干净的正文 HTML。 - 法律与合规准则:数据采集应仅用于个人知识归档或学术研究用途,严禁未授权批量抓取他人原创文章进行商业洗稿、抄袭或违规分发;同时必须严格控制抓取频率,不得对目标服务平台造成性能压迫。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















