


Python主流绘图库对比:Matplotlib、Seaborn与Plotly怎么选
深入对比Python三大主流绘图库Matplotlib、Seaborn与Plotly的核心架构、语法范式、交互体验与性能表现,并提供清晰的场景化选型决策路径与协作实践。
很多 Python 开发者在面对数据可视化任务时,常常陷入反复切换工具的困扰:有人抱怨用 Matplotlib 画一张分组柱状图需要十几行代码并手动对齐刻度,也有人困惑为什么 Seaborn 生成的图表很难直接实现鼠标悬停查看数值,还有人尝试把 Plotly 嵌入离线报告时遇到几十兆体积的 HTML 困扰。这种困扰的根源在于,这三大绘图库并非简单的“优缺点替代品”,而是诞生于完全不同的设计哲学、渲染管道与交付目标之中。
一、核心架构差异:从设计哲学看本质区别
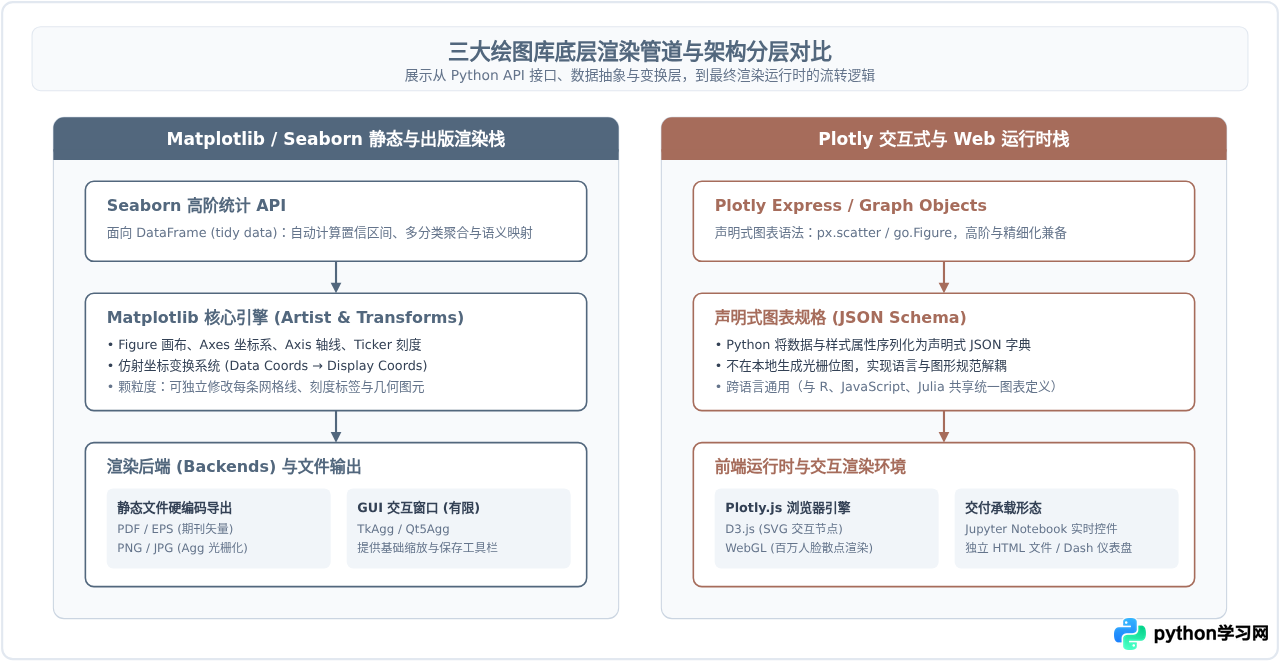
选择合适的可视化库,首先要理解工具背后的抽象层级与渲染逻辑。如果把图表比作建筑,Matplotlib 提供了最基础的砖瓦和绘图笔,Seaborn 是基于这些砖瓦搭建好的精装样板间,而 Plotly 则是在浏览器沙箱中运行的动态交互舞台。
Matplotlib 采用严谨的面向对象(Artist)模型。它的核心由 Figure(画布)、Axes(坐标系坐标轴)、Axis(单个坐标轴)和具体的 Artist(线段、多边形、文本)构成。它的目标是完全掌控屏幕上的每一个像素,底层渲染引擎依赖后端系统(如 Agg 光栅化引擎生成位图,或 PDF/SVG 矢量后端直接生成印刷文件)。这种机制决定了它的绝对精确,但也带来了繁琐的操作心智。
Seaborn 则属于高级统计可视化封装库。它并没有自己的独立绘图引擎,其底层完全基于 Matplotlib。它的核心贡献是直接面向 Pandas DataFrame 进行语义映射:开发者只需要声明哪一列代表 X 轴、哪一列代表 Y 轴、哪一列控制颜色分类(hue)或分面网格(col/row),Seaborn 就会自动完成分组聚合、置信区间估计与图例渲染,并返回标准的 Matplotlib Axes 对象。
Plotly 走了一条完全不同的道路。它的 Python 库(Plotly Express 与 Graph Objects)本质上是一个“声明式规范生成器”。Python 代码不直接负责把图形栅格化成像素,而是将数据和图表配置打包成符合 Plotly.js 规范的 JSON 结构,并交由浏览器内的 JavaScript 运行时环境(基于 D3.js 与 WebGL)实时渲染。这使得它天生具备现代网页的缩放、旋转、悬停提示(tooltip)与图例点击过滤功能。
二、语法范式与实操对比
为了直观感受三者的开发体验差异,我们以一个典型的数据可视化任务为例:基于包含分类信息的数据集,绘制带有分组颜色与趋势分布的多变量散点图,并配置标题与图例。
1. Matplotlib 的实现方式:面向对象的颗粒度控制
在 Matplotlib 中,推荐使用显式创建画布与坐标系的面向对象风格(Object-Oriented API)。面对分类变量,通常需要显式循环分类或使用数值映射,并手动维护图例元素。
import matplotlib.pyplot as plt
import numpy as np

# 构造模拟数据
np.random.seed(42)
x = np.random.randn(100)
y = 2 * x + np.random.randn(100)
categories = np.random.choice(['Category A', 'Category B'], size=100)

# 创建画布与子图
fig, ax = plt.subplots(figsize=(8, 5), dpi=100)

# 手动处理分组绘制以确保图例精准
colors = {'Category A': '#52677D', 'Category B': '#A66C5B'}
for cat, color in colors.items():
    mask = (categories == cat)
    ax.scatter(x[mask], y[mask], c=color, label=cat, alpha=0.8, edgecolors='none', s=45)

# 细粒度装饰坐标轴
ax.set_title("Matplotlib: Precise Control Example", fontsize=14, pad=12)
ax.set_xlabel("Measurement X (Units)", fontsize=11)
ax.set_ylabel("Measurement Y (Units)", fontsize=11)
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)
ax.grid(True, linestyle='--', alpha=0.5)
ax.legend(frameon=True, facecolor='#FFFFFF', edgecolor='none')

plt.tight_layout()
# plt.savefig("output.pdf") # 方便直接导出无损出版物矢量
plt.show()
可以看到,Matplotlib 允许你关闭上边框与右边框(spines)、定制网格虚线样式、精细控制刻度字体与边距。然而,哪怕只是简单的分类着色与图例合并,也需要编写循环或样板代码。
2. Seaborn 的实现方式:声明式统计语法
在 Seaborn 中,同样的任务可以直接通过高级语义参数完成。Seaborn 原生解析 Pandas DataFrame,自动映射色调(hue)、形状(style)并内置统计回归计算。
import seaborn as sns
import pandas as pd
import numpy as np

# 包装为 DataFrame 形式
df = pd.DataFrame({
    'Feature_X': x,
    'Feature_Y': y,
    'Group': categories
})

# 设置全局美学主题
sns.set_theme(style="ticks", palette=["#52677D", "#A66C5B"])

# 单行调用即可完成复杂统计绘图
plt.figure(figsize=(8, 5))
ax = sns.scatterplot(
    data=df,
    x='Feature_X',
    y='Feature_Y',
    hue='Group',
    alpha=0.8,
    s=50
)

ax.set_title("Seaborn: High-Level Statistical API", fontsize=14, pad=12)
sns.despine() # 快速移除顶部和右侧冗余轴线
plt.tight_layout()
plt.show()
Seaborn 仅需 1 行核心函数即可完成映射,并在右侧生成排版得当的图例。更重要的是,如果需要添加回归拟合线或置信带,只需将 scatterplot 替换为 lmplot,无需手动调用统计模型计算拟合斜率与方差。
3. Plotly 的实现方式:开箱即用的 Web 交互
Plotly 提供了 plotly.express(简写为 px),语法风格与 Seaborn 类似,但生成的图表在 Jupyter Notebook 或浏览器中是完全动态的。
import plotly.express as px

# 直接基于 DataFrame 声明图表
fig = px.scatter(
    df,
    x='Feature_X',
    y='Feature_Y',
    color='Group',
    color_discrete_map={'Category A': '#52677D', 'Category B': '#A66C5B'},
    title="Plotly: Interactive Web-Native Chart",
    hover_data={'Feature_X': ':.2f', 'Feature_Y': ':.2f'}
)

# 定制布局样式与边距
fig.update_layout(
    template="simple_white",
    hoverlabel=dict(bgcolor="white", font_size=12),
    legend_title_text="Group"
)

# 在浏览器中交互展示,或导出为独立交互式 HTML
# fig.write_html("interactive_report.html")
fig.show()
使用 Plotly 时,用户可以直接用鼠标在图表上框选区域局部放大、双击还原、点击图例项隐藏/显示某一类别,悬停时会自动弹出带有具体数值的高亮提示框。这种能力在探索复杂高维数据或向非技术人员汇报时极其高效。
三、场景化选型决策路径
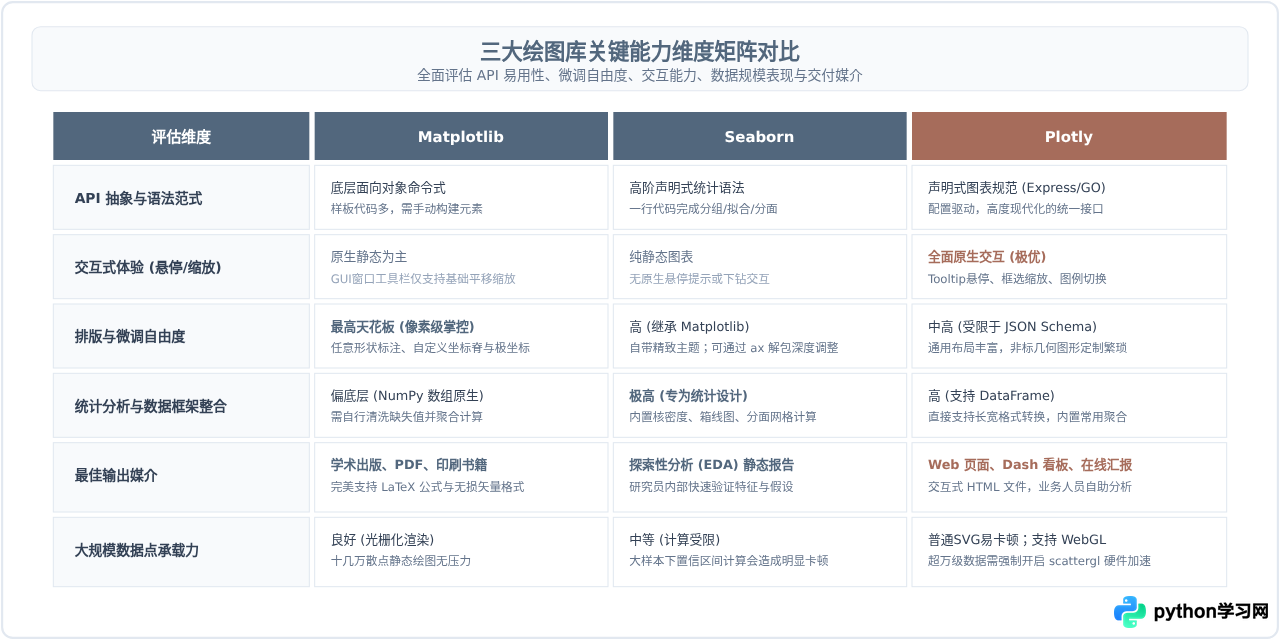
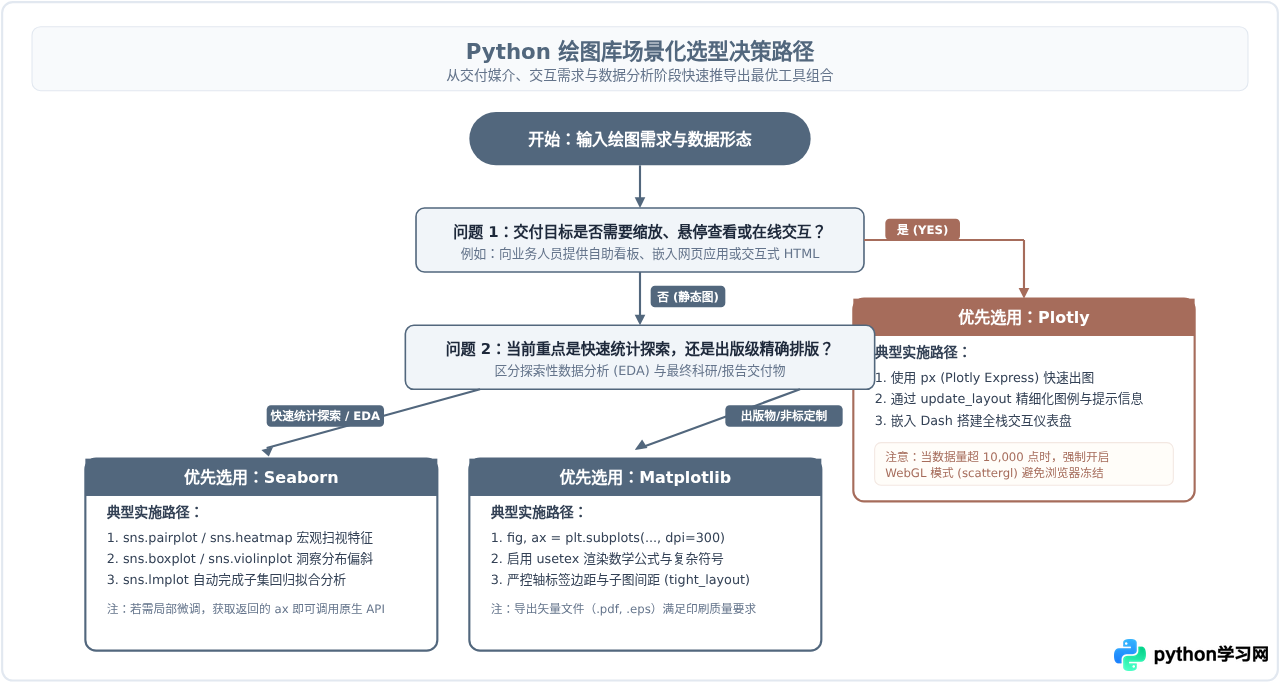
在工程与科研落地中,工具选型切忌脱离实际约束。判断使用哪一个库,应依次回答以下三个核心问题:
- 交付终态是什么? 如果最终成果必须打印成册、提交 LaTeX 论文、导出为 PDF 插入 Word,那么交互能力不仅毫无意义,还会引入额外的静态转换依赖;而如果是向客户演示动态趋势、嵌入企业内部管理后台,静态图表立刻显得捉襟见肘。
- 探索效率与定制成本的平衡点在哪? 探索性分析阶段需要快速尝试数十种变量组合,使用 Matplotlib 会严重拖慢分析节奏;但在图表定稿阶段,Seaborn 固化的排版可能无法满足出版社严苛的刻度内外翻转要求。
- 计算与渲染负荷在哪个环境? Plotly 将计算开销转嫁给客户端浏览器,如果离线 HTML 文件内嵌了 50 万个散点坐标,会导致非技术用户的浏览器直接无响应崩溃。
四、避坑指南与工业级协作实践
明确了选型之后,在实际项目落地时还需要警惕以下三个常见陷阱:
很多新手在发现 Seaborn 没有提供修改某个特殊标签角度的参数时,会误以为 Seaborn 无法实现。实际上,Seaborn 函数(如
sns.barplot)执行后返回的就是标准的 Matplotlib Axes 对象。正确的做法是“高级构图,低级微调”:用 Seaborn 快速完成数据映射,随后直接调用 ax.set_xticklabels(..., rotation=45) 等 Matplotlib 方法调整细节,而不需要从头手写 Matplotlib。
使用
fig.write_html("report.html") 时,默认会将约 3MB 的 plotly.js 完整代码打包内嵌进 HTML 文件(以保证离线可访问)。如果每个子分析都导出一个独立文件,很快会占据数百兆磁盘空间。如果部署环境支持外网访问,可配置 include_plotlyjs='cdn',使 HTML 体积骤降至几千字节;若需在严格离线内网下分发,建议将 plotly.js 部署在内网统一静态资源服务器中。
当数据量超过 50,000 点时,浏览器渲染包含 50,000 个
<circle> 节点的 SVG 会出现严重掉帧。此时在 Plotly 中应避免直接使用默认散点,而应切换为 px.scatter(..., render_mode='webgl'),由 GPU 承担渲染工作;如果不需要交互,直接使用 Matplotlib 光栅化输出为高清 PNG 是更稳定高效的方案。
五、结语与一览表
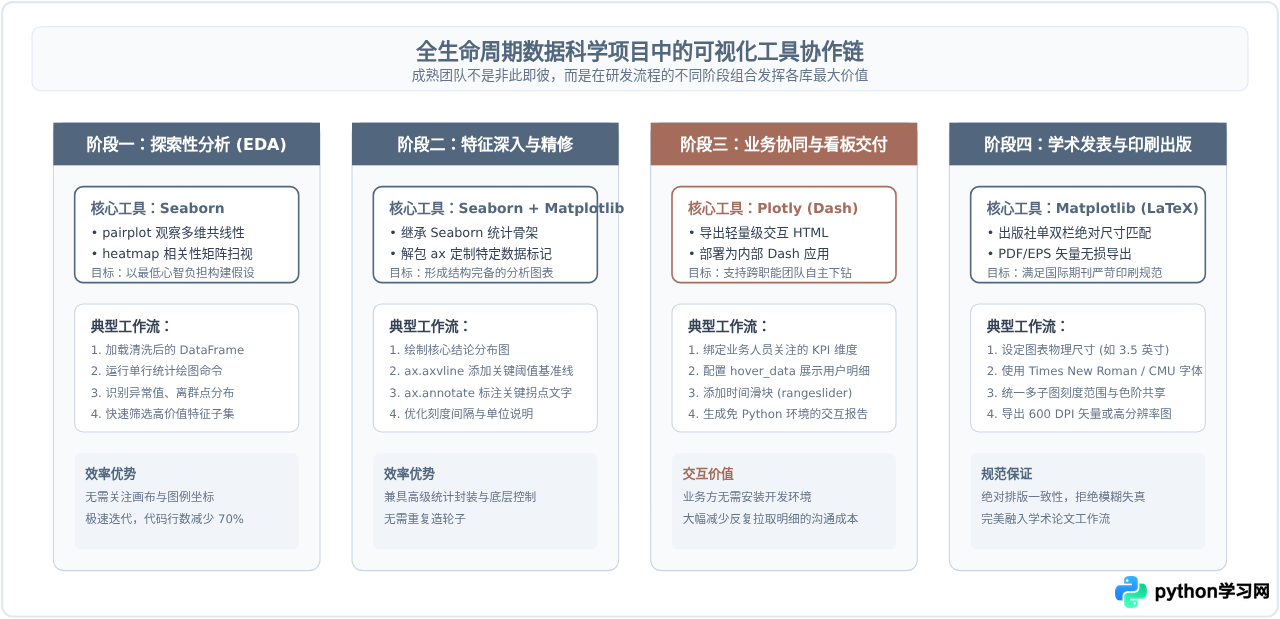
归根结底,Python 可视化生态的强大并不在于存在一个“全能之王”,而在于其分工明确的层次分化:
- 如果你正在开始一个新项目探索未知数据:从
import seaborn as sns开始,用最快的时间验证业务逻辑; - 如果你的图表需要交付给销售、运营或集成到 Web 系统:使用
import plotly.express as px,用零前端成本换来出色的交互体验; - 如果论文审稿人提出了细致的坐标修改意见,或者需要绘制高度非标的多轴组合图:毫不犹豫地回归
import matplotlib.pyplot as plt,调用底层面向对象接口实现彻底的终极掌控。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















