


Python爬楼梯算法:递归与动态规划代码实现
深入解析Python爬楼梯算法的核心原理与代码实现。从朴素递归的重叠子问题分析,到自顶向下的记忆化搜索,再到自底向上的动态规划及其O(1)空间复杂度压缩优化。
假设你正在爬一段共有 n 阶的楼梯,每次只能迈上 1 个台阶或者 2 个台阶。请问爬到楼顶共有多少种不同的走法?这就是经典的“爬楼梯”问题(Climbing Stairs)。虽然题目描述非常生活化,但它不仅是各大编程面试的高频常客,更是透彻理解递归思想、重叠子问题以及动态规划(Dynamic Programming)状态转移模型最理想的切入点。
本文将使用 Python 语言,带领读者从最自然的数学归纳出发,先构建朴素递归模型,观察调用栈中的重复计算;接着引入记忆化搜索消除冗余;最后演进到自底向上的动态规划解法,并完成空间复杂度仅为 O(1) 的滚动变量优化。
一、问题模型推导与状态转移原理
很多初学者在遇到这道题目时,容易陷入枚举具体每一步走向的误区,导致列举过程非常繁琐。实际上,解决这个问题的核心在于倒推最后一步的选择。
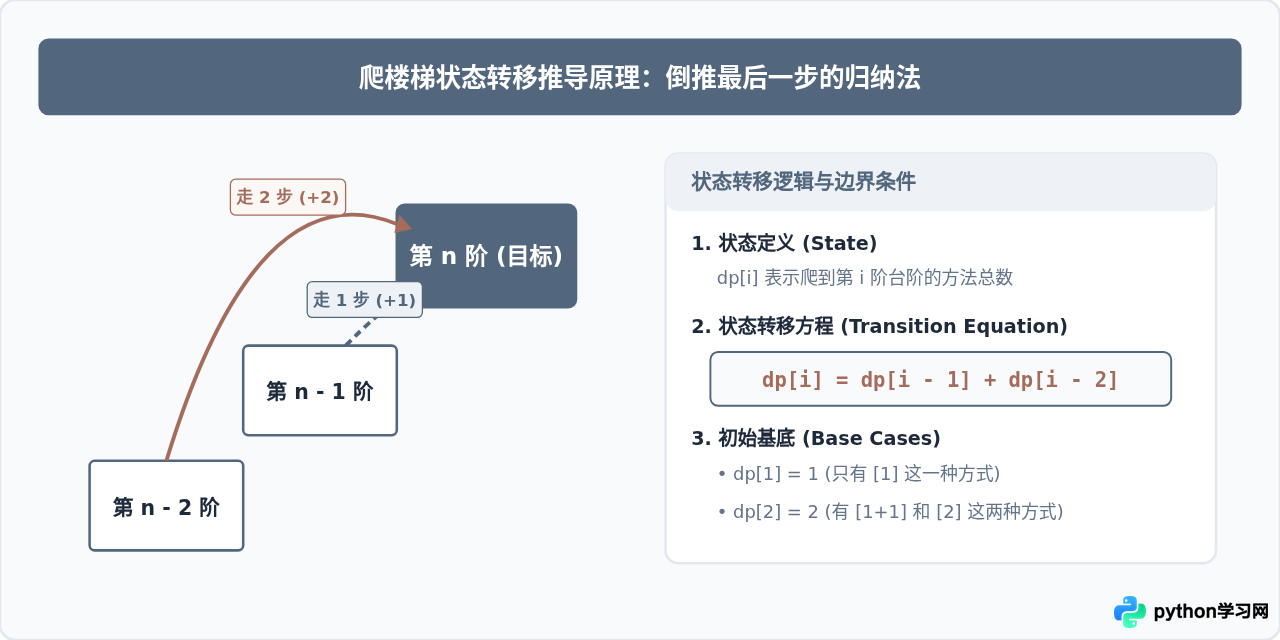
假设我们已经到达了第 n 阶台阶,由于规则限定每次只能迈 1 步或 2 步,那么到达第 n 阶的最后一次动作只可能存在两种情况:
- 从第
n - 1阶迈上 1 步到达第n阶; - 从第
n - 2阶迈上 2 步到达第n阶。
显然,到达第 n - 1 阶的所有可能走法,和到达第 n - 2 阶的所有可能走法之间是互斥且完备的。因此,到达第 n 阶的方法总数 f(n),恰好等于到达第 n - 1 阶的方法数与到达第 n - 2 阶的方法数之和:
f(n) = f(n - 1) + f(n - 2)
再考虑基准条件(Base Cases):当台阶数 n = 1 时,只有 1 种走法(迈 1 步);当台阶数 n = 2 时,有两种走法(走两次 1 步,或直接走一次 2 步)。这就是数学上著名的斐波那契数列模型。
二、解法一:朴素递归(自顶向下)
既然得到了递推关系 f(n) = f(n - 1) + f(n - 2),最直接的编程方式就是利用函数自调用,写出自顶向下的纯递归代码:
def climb_stairs_recursive(n: int) -> int:
    """
    朴素递归实现(存在大量重复计算,仅用于演示原理)
    时间复杂度: O(2^n)
    空间复杂度: O(n) (系统调用栈开销)
    """
    if n <= 0:
        return 0
    if n == 1:
        return 1
    if n == 2:
        return 2
    return climb_stairs_recursive(n - 1) + climb_stairs_recursive(n - 2)

# 测试运行
if __name__ == "__main__":
    n = 5
    print(f"爬 {n} 阶台阶的方法数: {climb_stairs_recursive(n)}")
    # 示例输出: 爬 5 阶台阶的方法数: 8
为什么朴素递归会严重超时?
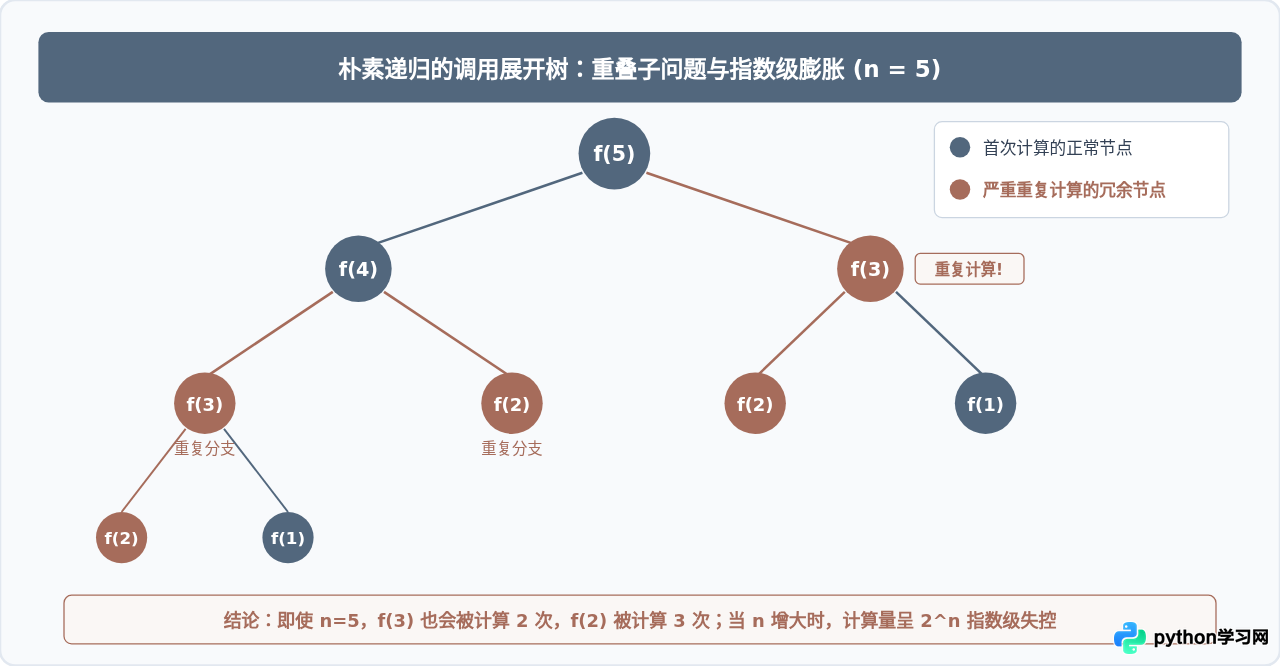
上述代码逻辑完全符合数学公式,但是当输入规模 n > 35 时,程序运行时间将以指数级暴增,甚至直接卡死。原因就在于重叠子问题(Overlapping Subproblems)。
在以 f(5) 为例的递归树中,为了计算 f(5),需要分别计算 f(4) 和 f(3);而在展开 f(4) 时,又会再次调用 f(3)。随着树形深度的增加,相同的子函数被无休止地重复执行。整棵递归树的高度为 n,节点总数达到 2n 级别,其时间复杂度为极为恐怖的 O(2n)。
三、解法二:记忆化搜索(自顶向下 + 备忘录)
既然重复计算是导致性能低下的罪魁祸首,一个显而易见的改进策略就是:每次计算出某个台阶的答案后,把它保存在哈希表或列表中;下次再需要时直接读取,不再重新递归。
这种方法称为“记忆化搜索”(Memoization),它保留了自顶向下的清晰逻辑,同时将每个状态的求解次数严格降为 1 次。
from typing import Dict

def climb_stairs_memo(n: int, memo: Dict[int, int] = None) -> int:
    """
    记忆化搜索(自顶向下递归 + 备忘录缓存)
    时间复杂度: O(n)
    空间复杂度: O(n) (备忘录字典与系统调用栈)
    """
    if memo is None:
        memo = {}

    # 边界条件
    if n <= 0:
        return 0
    if n == 1:
        return 1
    if n == 2:
        return 2

    # 查询备忘录
    if n in memo:
        return memo[n]

    # 计算并缓存
    memo[n] = climb_stairs_memo(n - 1, memo) + climb_stairs_memo(n - 2, memo)
    return memo[n]

# 或者使用 Python 内置的高性能装饰器:
from functools import lru_cache

@lru_cache(maxsize=None)
def climb_stairs_lru(n: int) -> int:
    if n <= 2:
        return max(0, n)
    return climb_stairs_lru(n - 1) + climb_stairs_lru(n - 2)

# 测试执行
if __name__ == "__main__":
    print("记忆化搜索求解 n=40:", climb_stairs_memo(40))
    # 示例输出: 记忆化搜索求解 n=40: 165580141
在 Python 中,通过 @functools.lru_cache 可以在不侵入原有递归结构的情况下自动实现状态缓存。但请注意,递归解法始终受制于 Python 的默认最大递归深度(通常为 1000)。当 n 达到数千时,会触发 RecursionError: maximum recursion depth exceeded。若要彻底摆脱栈溢出风险,必须转向自底向上的迭代方式。
四、解法三:经典动态规划(自底向上数组法)
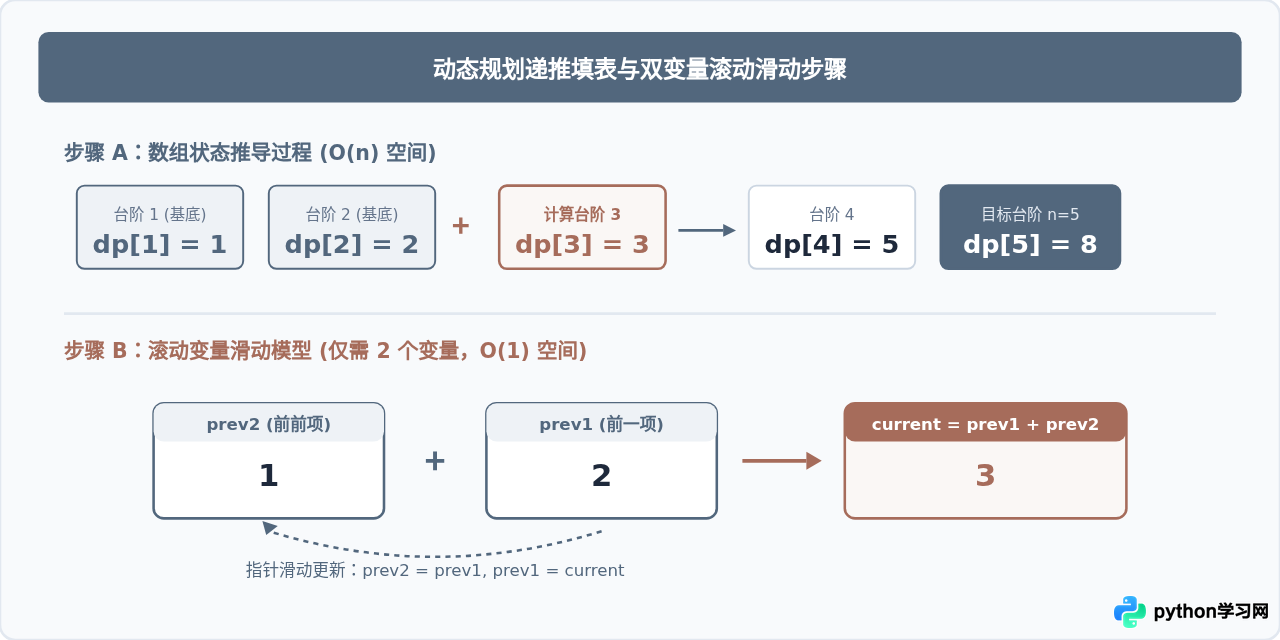
动态规划的核心思想是不再自顶向下发散,而是自底向上(Bottom-Up)逐步推导。我们从已知最小的问题出发:先确定 1 阶和 2 阶的解,再像搭积木一样依次计算 3 阶、4 阶……直到填满至第 n 阶。
算法步骤
- 分配状态数组:创建长度为
n + 1的列表dp,其中dp[i]存放爬到第 i 阶的方法数。 - 设定基准值:
dp[1] = 1,dp[2] = 2。 - 状态转移迭代:从
i = 3循环遍历到n,每一次执行dp[i] = dp[i - 1] + dp[i - 2]。 - 返回最终结果:返回
dp[n]。
def climb_stairs_dp(n: int) -> int:
    """
    经典动态规划数组法
    时间复杂度: O(n)
    空间复杂度: O(n)
    """
    if n <= 0:
        return 0
    if n == 1:
        return 1
    if n == 2:
        return 2

    # 初始化 dp 数组,长度为 n + 1 以方便按台阶序号直接索引
    dp = [0] * (n + 1)
    dp[1] = 1
    dp[2] = 2

    for i in range(3, n + 1):
        dp[i] = dp[i - 1] + dp[i - 2]

    return dp[n]

# 示例验证
if __name__ == "__main__":
    for i in range(1, 6):
        print(f"台阶数: {i}, 走法数: {climb_stairs_dp(i)}")
    # 示例输出:
    # 台阶数: 1, 走法数: 1
    # 台阶数: 2, 走法数: 2
    # 台阶数: 3, 走法数: 3
    # 台阶数: 4, 走法数: 5
    # 台阶数: 5, 走法数: 8
五、解法四:状态压缩优化(空间复杂度降至 O(1))
细心观察动态规划的更新过程,我们会发现一个非常关键的细节:计算当前的 dp[i] 时,仅仅需要紧挨着它的前两个状态 dp[i - 1] 和 dp[i - 2]。更早之前的状态(例如 dp[1]、dp[2])在后续计算中根本不再参与。
这意味着我们完全没有必要维护一个长度为 n + 1 的大数组!只需要声明两个变量来记录“前一步”和“前两步”的值,并在每一步计算后向前“滚动滑动”即可。这就是算法设计中非常著名的状态压缩(State Compression)技巧。
def climb_stairs_optimized(n: int) -> int:
    """
    空间最优的滚动变量解法
    时间复杂度: O(n)
    空间复杂度: O(1) (常数级额外内存空间)
    """
    if n <= 0:
        return 0
    if n == 1:
        return 1
    if n == 2:
        return 2

    # 分别对应到达前前项 (i-2) 与前一项 (i-1) 的走法总数
    prev2 = 1  # 对应 n=1
    prev1 = 2  # 对应 n=2

    for _ in range(3, n + 1):
        current = prev1 + prev2
        # 向前滚动更新状态
        prev2 = prev1
        prev1 = current

    return prev1

# 边界测试与大数值测试
if __name__ == "__main__":
    test_cases = [1, 2, 3, 5, 10, 50]
    for case in test_cases:
        print(f"台阶数 n = {case:2d} -> 走法方案数 = {climb_stairs_optimized(case)}")
    # 示例输出:
    # 台阶数 n =  1 -> 走法方案数 = 1
    # 台阶数 n =  2 -> 走法方案数 = 2
    # 台阶数 n =  3 -> 走法方案数 = 3
    # 台阶数 n =  5 -> 走法方案数 = 8
    # 台阶数 n = 10 -> 走法方案数 = 89
    # 台阶数 n = 50 -> 走法方案数 = 20365011074
六、算法全维度对比与总结
为了让读者更清晰地掌握这四种算法形态的演进脉络,我们将它们的时空开销、核心思想及优缺点汇总如下:
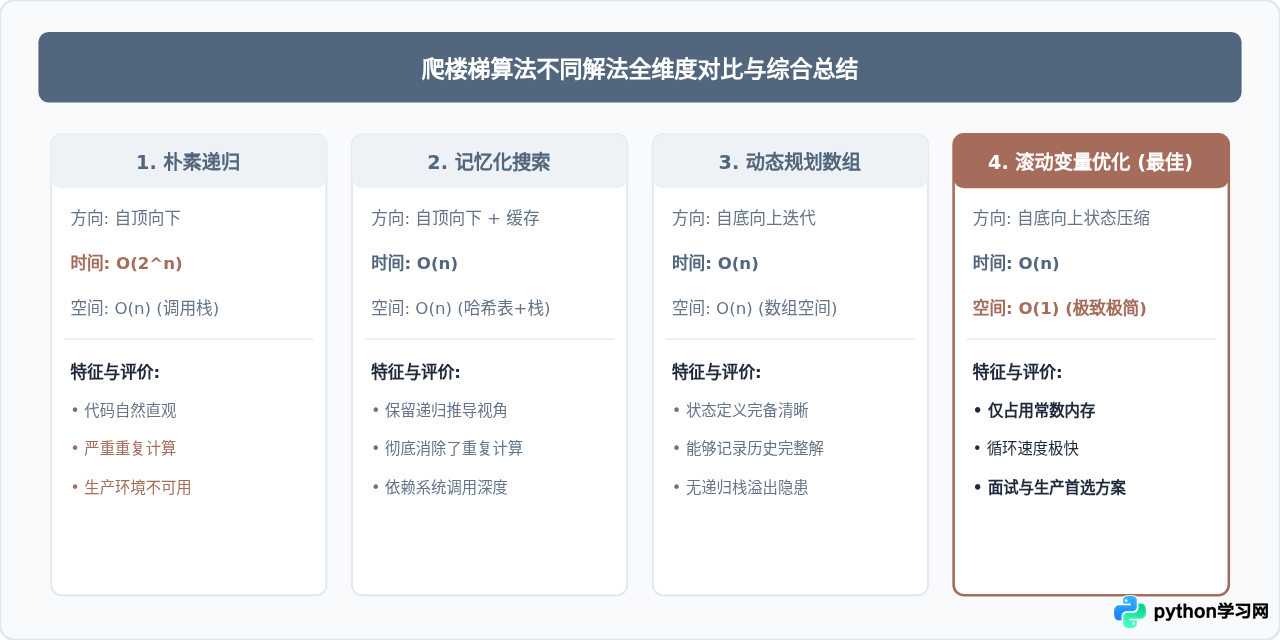
| 解法方案 | 核心思路 | 时间复杂度 | 空间复杂度 | 适用场景及局限 |
|---|---|---|---|---|
| 朴素递归 | 直接自顶向下展开公式 | O(2n) | O(n) | 仅适合教学理解基本原理,n>35 时完全不可用。 |
| 记忆化搜索 | 自顶向下 + 哈希表或数组缓存 | O(n) | O(n) | 适合思维偏向递归推导的场景;受限于语言的最大递归深度。 |
| 动态规划数组 | 自底向上迭代填表 | O(n) | O(n) | 标准解法,容易扩展到更复杂的约束条件或需要还原路径的场景。 |
| 滚动变量优化 | 自底向上 + 仅保留前两个状态 | O(n) | O(1) | 最优解,时空效率极致,是工业界实现与算法面试的标杆答卷。 |
从纯递归到动态规划,再到滚动变量状态压缩,解决爬楼梯算法的这一演进路径,生动地展示了算法优化的经典方法论:识别重复工作、建立状态缓存、转化计算方向、压缩冗余存储。掌握这套思路,未来在遇到“打家劫舍”、“斐波那契数列”、“不同路径”等一系列动态规划问题时,便能游刃有余、融会贯通。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















