


Python常用第三方库有哪些?按数据、Web与自动化分类推荐
系统介绍Python在数据科学、Web开发与自动化运维三大核心领域的常用第三方库,涵盖功能定位、代码示例、架构协作及选型决策指南。
一、第三方库管理与安装标准规范
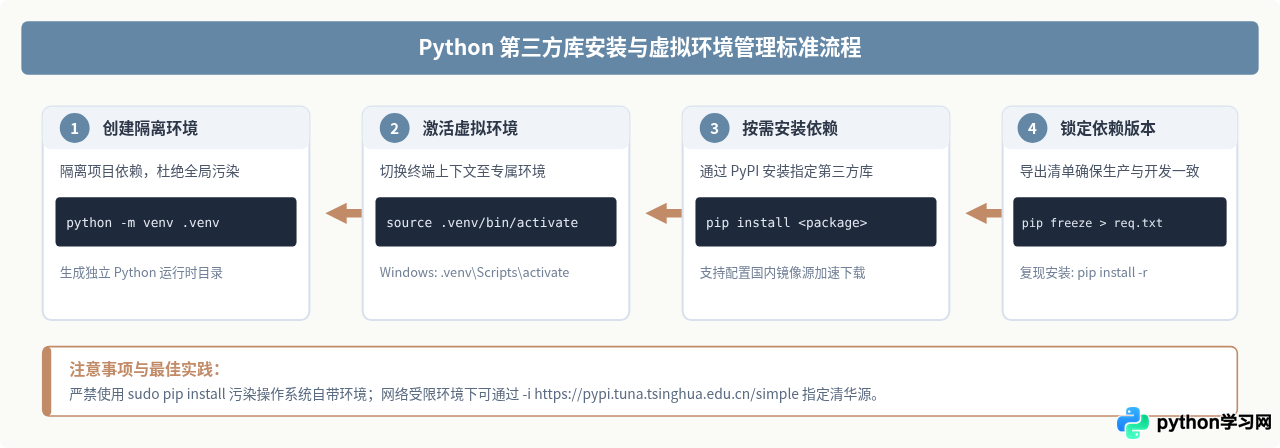
在引入具体第三方库之前,规范的环境管理是避免依赖污染和版本冲突的前提。直接使用全局环境安装库容易因不同项目需求差异导致底层包版本冲突。标准的做法是为每个项目创建独立的虚拟环境,并通过依赖文件固化版本。
二、数据处理与科学计算类常用库
数据领域是 Python 最为繁荣的技术分支。数据工作通常包含数值运算、表格整理、数据可视化及统计建模四个阶段,彼此紧密协同。
1. NumPy:数值计算与多维数组核心基石
NumPy(Numerical Python)是整个 Python 科学计算生态的底层核心。Python 原生列表(list)存储的是对象指针,不仅内存开销大,且无法进行高效的连续向量化计算。NumPy 提供了基于 C 语言实现的 ndarray(N-dimensional Array),通过连续内存存储和底层矢量化指令,大幅提升了多维矩阵与高阶数学运算的性能。
import numpy as np

# 1. 创建连续内存的二维矩阵
matrix = np.array([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]], dtype=np.float64)

# 2. 向量化广播计算(避免显式 for 循环)
scaled_matrix = (matrix * 2.5) + 1.0

# 3. 矩阵转置与均值计算
mean_value = np.mean(scaled_matrix, axis=0)
print("列均值结果:", mean_value)
2. Pandas:结构化数据分析与清洗利器
在实际业务中,数据往往以带列名、行索引的二维表格形态存在(如 CSV、Excel、数据库查询结果)。Pandas 在 NumPy 之上构建了 Series(一维带标签数组)和 DataFrame(二维表格结构),提供了强大的数据过滤、缺失值处理、时间序列分析和分组聚合(GroupBy)功能。
import pandas as pd

# 构建模拟订单明细数据
data = {
    "order_id": [1001, 1002, 1003, 1004],
    "category": ["电子", "家居", "电子", "办公"],
    "amount": [1299.0, 350.5, 4800.0, 120.0],
    "is_paid": [True, True, False, True]
}
df = pd.DataFrame(data)

# 过滤已支付订单,并按品类统计销售总额
paid_df = df[df["is_paid"] == True]
category_summary = paid_df.groupby("category")["amount"].agg(["count", "sum"]).reset_index()
print(category_summary)
3. Matplotlib 与 Seaborn:数据可视化呈现
数据清洗完成后,通常需要图形化呈现规律与分布。Matplotlib 是最底层、控制粒度最细的绘图库,几乎所有图表元素(坐标轴、图例、刻度)均可自由配置;Seaborn 则是建立在 Matplotlib 之上的高级统计绘图库,默认配色更现代,内建箱线图、热力图、小提琴图等复杂统计模型图形。
Matplotlib 与 Seaborn 配合绘图示例import matplotlib.pyplot as plt
import seaborn as sns
# 设置全局中文显示支持
plt.rcParams["font.sans-serif"] = ["PingFang SC", "Microsoft YaHei", "sans-serif"]
plt.rcParams["axes.unicode_minus"] = False
# 使用 Seaborn 绘制散点分布图
tips = sns.load_dataset("tips") if "load_dataset" in dir(sns) else None
fig, ax = plt.subplots(figsize=(8, 4.5))
# 绘制柱状图示例
categories = ["电子", "家居", "办公"]
revenue = [6099.0, 350.5, 120.0]
ax.bar(categories, revenue, color="#6487A5", width=0.5)
ax.set_title("各品类销售营收统计", fontsize=14, pad=12)
ax.set_ylabel("金额 (元)", fontsize=11)
ax.grid(axis="y", linestyle="--", alpha=0.6)
plt.tight_layout()
# plt.savefig("sales_chart.png", dpi=200)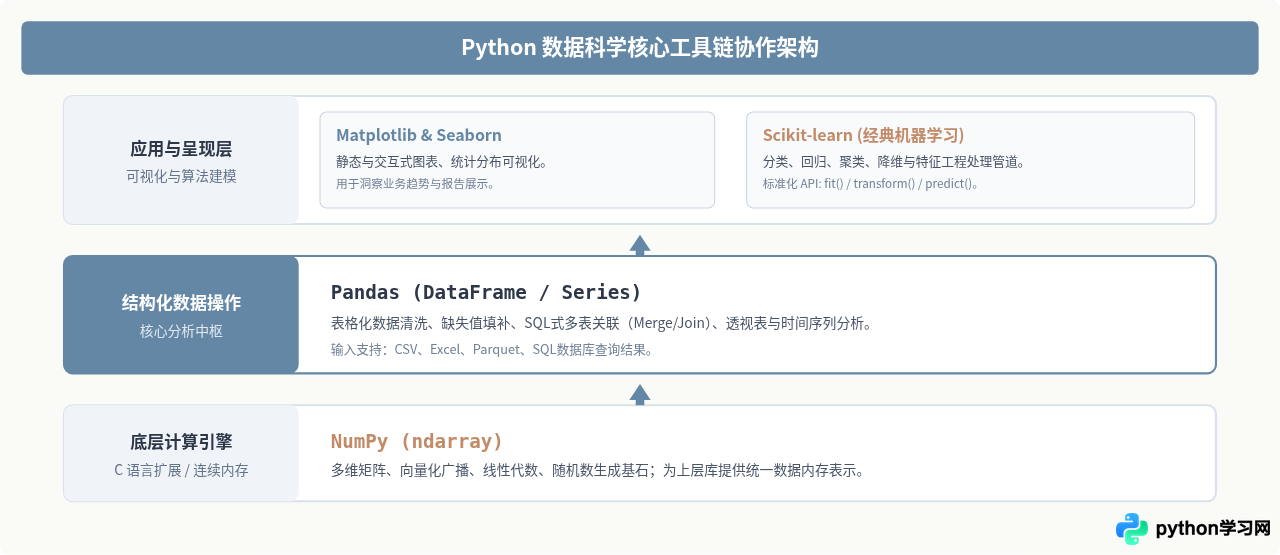
三、Web 开发与 API 构建类常用库
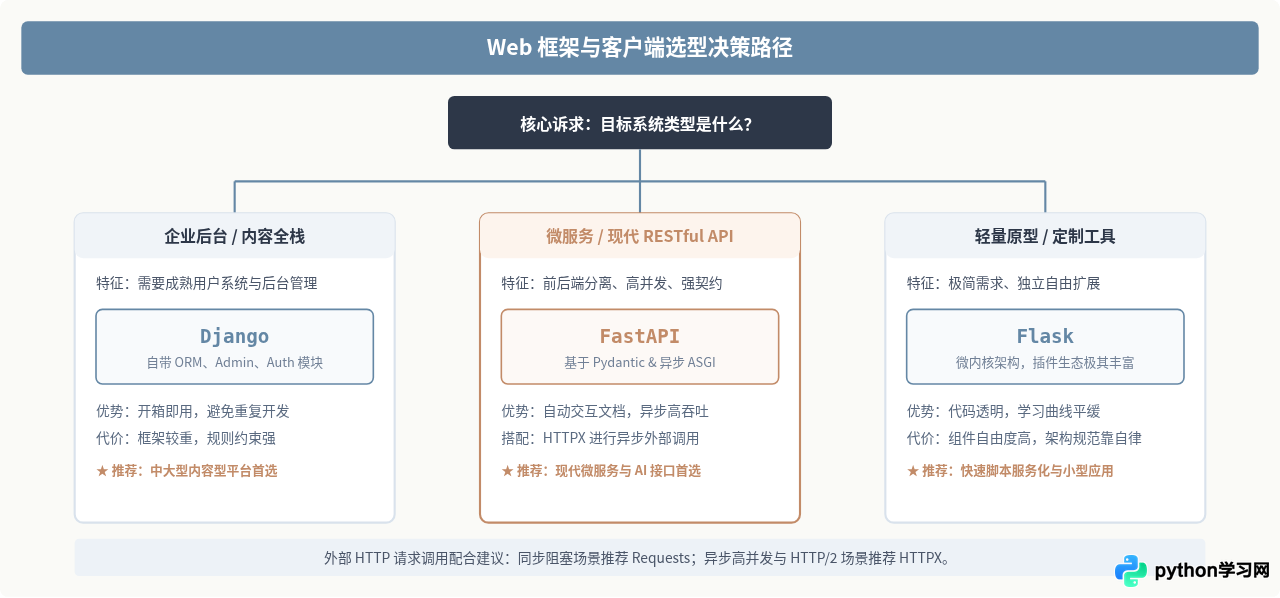
在后端服务、微服务接口与 Web 应用开发中,Python 提供了从“全功能大而全”到“轻量级异步”的完整技术矩阵。
1. Django:“自带电池”的全功能框架
Django 是 Python 生态中资历最深、生态最成熟的全栈框架。它的核心设计哲学是“自带电池(Batteries Included)”,内置了强大的 ORM 对象关系映射系统、自动生成的管理后台(Admin)、用户认证系统、CSRF 安全防护与表单验证机制。
- 适用场景:业务逻辑复杂、需要快速搭建内容管理系统(CMS)、企业内部管理平台、电商后台。
- 核心优势:开箱即用,规范统一,适合团队协同开发,避免前期重复造轮子。
# models.py:定义数据库模型
from django.db import models

class Article(models.Model):
    title = models.CharField(max_length=200, verbose_name="文章标题")
    content = models.TextField(verbose_name="正文")
    created_at = models.DateTimeField(auto_now_add=True)

    def __str__(self):
        return self.title

# views.py:视图逻辑
from django.http import JsonResponse
from .models import Article

def article_list(request):
    articles = list(Article.objects.values("id", "title", "created_at")[:10])
    return JsonResponse({"code": 200, "data": articles})
2. Flask:极简灵活的微框架
与 Django 相反,Flask 保持了极小的内核。它本身仅包含 WSGI 调度(Werkzeug)与模板渲染(Jinja2),不捆绑数据库 ORM 或用户鉴权。开发者可以根据具体项目需要,自由组合 SQLAlchemy、Flask-Login、Marshmallow 等插件。
- 适用场景:轻量级微服务、概念验证(PoC)项目、小型工具网站或对架构组件有高度定制需求的应用。
from flask import Flask, jsonify, request

app = Flask(__name__)

@app.route("/api/ping", methods=["GET"])
def ping():
    client_ip = request.remote_addr
    return jsonify({"status": "ok", "client_ip": client_ip})

if __name__ == "__main__":
    app.run(host="0.0.0.0", port=5000)
3. FastAPI:现代高性能异步 API 框架
FastAPI 是近年来增长最迅速的 Python 框架。它基于 Starlette(异步核心)与 Pydantic(数据验证),完全拥抱 Python 3.6+ 的类型注解(Type Hints)。
- 自动生成文档:运行服务后直接生成符合 OpenAPI 规范的交互式 Swagger UI 文档。
- 原生异步高并发:支持
async def语法,在处理 I/O 密集型接口时性能逼近 NodeJS 与 Go。 - 严格数据校验:请求参数与响应体自动进行类型校验与转换,错误时自动返回标准 422 提示。
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="Task Service API")

class TaskCreate(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务名称")
    priority: int = Field(default=1, ge=1, le=5, description="优先级1-5")

@app.post("/tasks", status_code=201)
async def create_task(task: TaskCreate):
    # Pydantic 已在进入函数前自动完成类型与范围校验
    saved_task_id = 42
    return {"id": saved_task_id, "title": task.title, "priority": task.priority}
4. Requests 与 HTTPX:网络请求客户端
编写爬虫、对接第三方开放平台或微服务通信时必须用到 HTTP 客户端。Requests 拥有极其优雅易用的同步 API,被称为 Python 最人性的库之一;而 HTTPX 则在保持与 Requests 几乎一致的 API 基础上,全面增加了 async/await 异步支持与 HTTP/2 协议支持,是现代异步 Web 系统的标配选择。
四、自动化脚本与运维测试类常用库
利用 Python 替代机械化的重复劳动,是其最接地气、产出最快的使用场景。自动化通常分为办公文档处理、浏览器端动态操作以及服务器任务调度三大方向。
1. openpyxl 与 python-docx:日常办公报表批量化
针对经常需要批量汇总的 Excel 报表与 Word 文档,openpyxl 支持对 .xlsx 文件进行完整的读写、公式填充、单元格样式定制与多工作表合并;而 python-docx 则用于批量套打合同、自动生成固定格式的公文报告。
import openpyxl
from openpyxl.styles import Font, PatternFill, Alignment

# 创建工作簿与工作表
wb = openpyxl.Workbook()
ws = wb.active
ws.title = "月度业绩汇总"

# 写入表头并配置样式
headers = ["工号", "姓名", "考核部门", "实际完成业绩(万元)"]
ws.append(headers)

header_fill = PatternFill(start_color="6487A5", end_color="6487A5", fill_type="solid")
header_font = Font(name="PingFang SC", size=11, bold=True, color="FFFFFF")

for col_num in range(1, len(headers) + 1):
    cell = ws.cell(row=1, column=col_num)
    cell.fill = header_fill
    cell.font = header_font
    cell.alignment = Alignment(horizontal="center")

# 批量追加数据行
rows = [
    [101, "张伟", "华东大区", 88.5],
    [102, "李娜", "华北大区", 102.3],
    [103, "王强", "华南大区", 94.0]
]
for row in rows:
    ws.append(row)

# 写入求和公式
ws.cell(row=5, column=3, value="总计").font = Font(bold=True)
ws.cell(row=5, column=4, value="=SUM(D2:D4)").font = Font(bold=True)

wb.save("sales_report.xlsx")
2. Playwright 与 BeautifulSoup4:网页解析与自动化操作
网络数据获取根据目标网页机制不同分为两类:
- 静态解析(BeautifulSoup4):当网页内容直接通过 HTML 源码返回时,配合
requests获取 HTML 文本,使用 BeautifulSoup 通过 CSS 选择器或标签关系快速定位提取目标字段,运行开销极小。 - 动态交互与现代自动化(Playwright):对于大量依赖前端 Vue/React 异步渲染、需要模拟鼠标点击、滑动滚轮、表单填写的复杂场景,推荐优先选用微软开源的
Playwright(相较传统 Selenium,Playwright 原生支持自动等待元素就绪、提供录制脚本功能,且执行速度与稳定性大幅提升)。
from playwright.sync_api import sync_playwright

def scrape_dynamic_page():
    with sync_playwright() as p:
        # 启动 Chromium 无头浏览器
        browser = p.chromium.launch(headless=True)
        page = browser.new_page()

        # 访问页面并等待网络空闲
        page.goto("https://quotes.toscrape.com/js/")
        page.wait_for_selector(".quote")

        quotes = page.query_selector_all(".quote")
        results = []
        for quote in quotes[:3]:
            text = quote.query_selector(".text").inner_text()
            author = quote.query_selector(".author").inner_text()
            results.append({"author": author, "text": text})

        browser.close()
        return results

# print(scrape_dynamic_page())
3. Celery 与 APScheduler:定时调度与分布式异步队列
在自动化任务从单机脚本走向系统化服务时,任务触发机制至关重要:
- APScheduler:轻量级进程内任务调度器。支持基于 Cron 表达式、固定间隔(Interval)或特定时间点(Date)触发任务,适合单机环境的自动化运维巡检与数据拉取。
- Celery:工业级分布式异步任务队列。结合 Redis 或 RabbitMQ 作为消息代理(Broker),支持任务超时重试、工作节点横向扩容与定时 Beat 调度,是大型生产系统解耦耗时任务的标准方案。
TimeoutError 与网络异常,避免单个请求卡死整个调度进程;对于高频执行的任务,合理配置日志轮转(如使用 loguru 库),防止标准输出占满磁盘空间。
五、综合选型推荐矩阵与总结
为了帮助读者在面对具体需求时能够快速锁定最匹配的技术组合,下表将前述三大分类的十余个代表性第三方库进行了多维对比汇总:
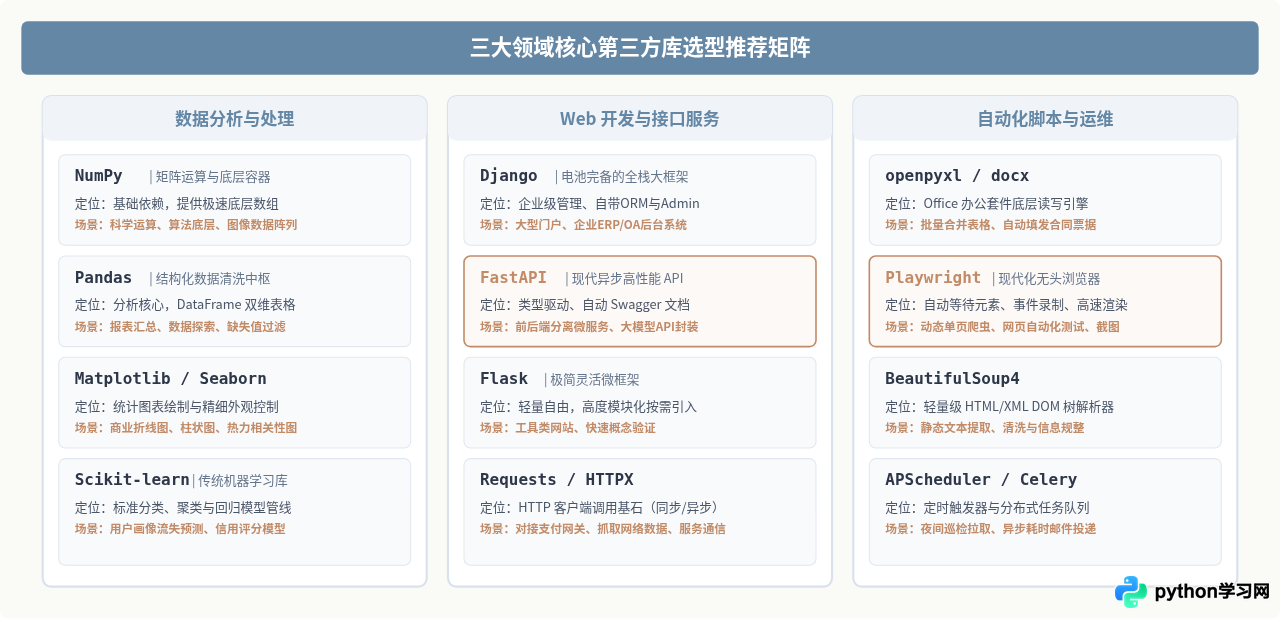
掌握第三方库并不是死记硬背每个库的所有 API,而是清晰理解每个工具的核心定位与适用边界:
- 当面对海量数值与统计数据时,NumPy 筑底,Pandas 清洗,Matplotlib/Seaborn 负责图形化落地;
- 当面临业务服务交付时,快速构建管理后台选 Django,打造高并发接口微服务选 FastAPI,开发轻量定制工具选 Flask;
- 当面对繁琐的人工重复工作时,利用 openpyxl 批量操纵报表,选用 Playwright 搞定动态网页操作,搭配 APScheduler 实现全天候自动值守。
在实际工程中,始终坚持使用虚拟环境隔离每个项目依赖,并通过 requirements.txt 锁定具体版本,能够帮助开发者构建稳定、可复现、高效的 Python 生产力系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















