


Python requests.get()用法指南:发送HTTP请求与处理响应
深入讲解 Python requests.get() 方法的核心用法,包括发送 GET 请求、传递查询参数、配置请求头、设置超时、解析不同格式的响应体以及捕获常见异常。
在 Python 网络数据采集和 API 接口对接中,requests.get() 是最常用且直观的 HTTP 方法。调用该函数会同步发起一个 GET 请求并返回一个包含状态码、响应头与数据体的 Response 对象。理解如何正确传递参数、设定请求头、保护超时以及针对不同数据类型解析响应体,是编写稳定高效网络程序的关键。
一、快速上手与请求生命周期
发起一个最简单的 GET 请求只需传入目标 URL。requests 库会在底层自动处理连接建立、URL 解析与 HTTP 报文拼接。调用返回的并非单纯的字符串,而是一个封装了完整通信结果的 requests.models.Response 实例。
import requests

url = "https://httpbin.org/get"
response = requests.get(url)

print("HTTP状态码:", response.status_code)
print("响应字符集:", response.encoding)
print("请求是否成功:", response.ok)
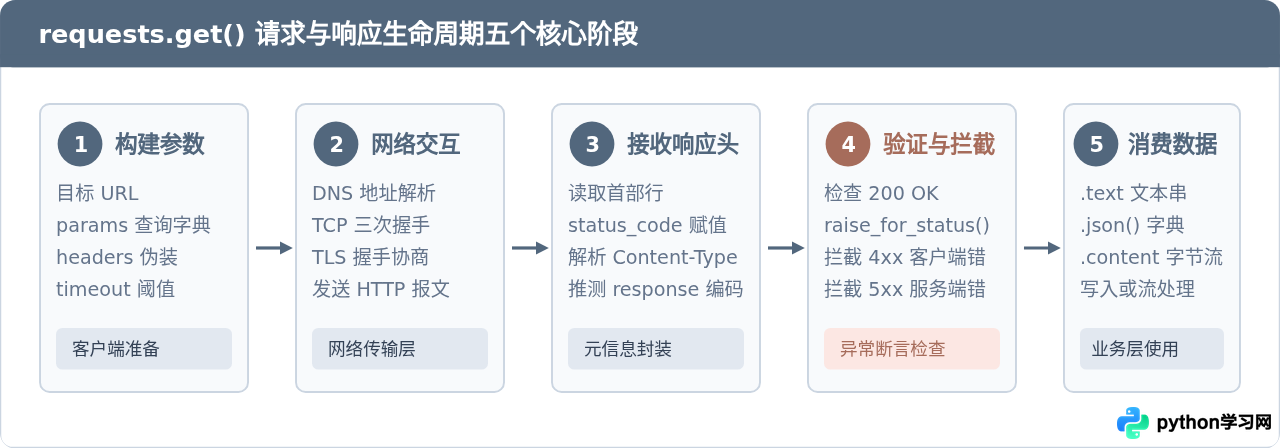
在实际业务中,发送请求与处理响应往往经历五个明确阶段:组装参数、建立网络连接、获取响应头、执行状态验证以及提取具体的数据体。
二、构造请求参数与请求头
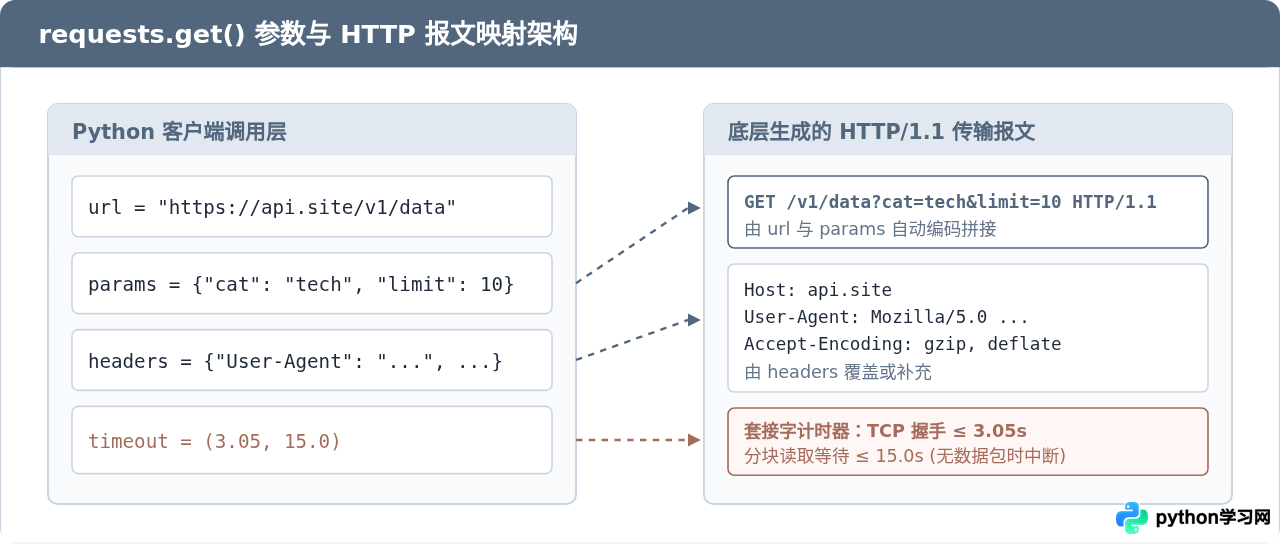
在实际场景中,绝大多数 GET 请求都需要携带查询参数(Query String)或者指定身份凭证与浏览器标识(User-Agent)。手动用字符串连接拼接 URL 不仅繁琐,而且极易因空格、中文、特殊字符等未正确 URL 编码导致请求失效。
1. 使用 params 字典自动编码
requests.get() 提供了 params 参数,支持传入字典、元组列表或字节流。库会自动将其转换为合法的 URL 查询字符串,并处理 URL 编码规则。
import requests

base_url = "https://httpbin.org/get"
query_params = {
    "keyword": "python 教程",
    "page": 2,
    "tag": ["web", "api"]  # 列表类型参数将被解析为多个重复键
}

response = requests.get(base_url, params=query_params)
print("实际请求URL:", response.url)
# 输出: https://httpbin.org/get?keyword=python+%E6%95%99%E7%A8%8B&page=2&tag=web&tag=api
2. 设置 headers 模拟浏览器环境与认证
默认情况下,requests 会携带类似 python-requests/2.x.x 的 User-Agent。许多现代 Web 服务器或反爬虫网关会直接拦截非浏览器发起的请求。通过 headers 字典可以轻松覆盖这些标头。
custom_headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "application/json, text/plain, */*",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
}

response = requests.get("https://httpbin.org/headers", headers=custom_headers)
3. 显式配置 timeout 控制连接与读取时间
生产环境严禁不设超时。如果网络断开、服务器响应缓慢或防火墙丢包,省略 timeout 会导致当前线程或进程无限期挂起阻塞。
timeout 可以是单一浮点数(代表连接与读取的总上限),也可以是一个二元元组 (connect_timeout, read_timeout),分别精细控制 TCP 握手耗时与数据包返回等待上限。
三、解析不同格式的响应体
获取到 Response 对象后,首先应当确认服务器是否正确响应,随后再根据目标接口的数据类型选择恰当的读取属性或方法。
1. 状态判断:status_code 与 raise_for_status()
response.status_code 返回整数状态码(如 200、404、500 等)。除了手动使用 if response.status_code == 200: 判断外,更推荐调用 response.raise_for_status()。该方法在遇到 4xx(客户端错误)或 5xx(服务端错误)时主动抛出 requests.exceptions.HTTPError 异常,让错误处理逻辑更集中。
2. 文本解析:response.text 与编码机制
response.text 返回自动解码后的 Unicode 字符串。requests 会根据响应头 Content-Type 中的 charset 字段推测编码(存放在 response.encoding)。如果返回头未指定编码,requests 可能会默认回退到 ISO-8859-1,导致中文网页显示为乱码。
遇到乱码时,可以在读取 response.text 前显式设定编码,或利用 response.apparent_encoding(基于 chardet/charset_normalizer 库的内容推断结果):
response = requests.get("https://example.com/gbk-page")
# 发现中文乱码时的修正方案:
response.encoding = response.apparent_encoding
print(response.text)
3. 结构化数据:response.json()
当调用 RESTful API 时,接口通常返回 JSON 字符串。response.json() 是 requests 提供的内置反序列化便捷方法,等效于 json.loads(response.text)。
如果接口返回了 HTML 错误页(如 502 错误网关)或空响应,直接调用 response.json() 会触发 json.decoder.JSONDecodeError。因此,必须在 raise_for_status() 通过或明确确认内容类型后调用。
4. 二进制流数据:response.content
对于图片、音频、PDF、视频或压缩包等非文本资源,必须使用 response.content 获取原始 bytes 字节串,避免经过任何字符编码转换造成数据损坏。
# 保存网络图片示例
img_url = "https://httpbin.org/image/png"
resp = requests.get(img_url, timeout=10)
resp.raise_for_status()

with open("downloaded_image.png", "wb") as f:
    f.write(resp.content)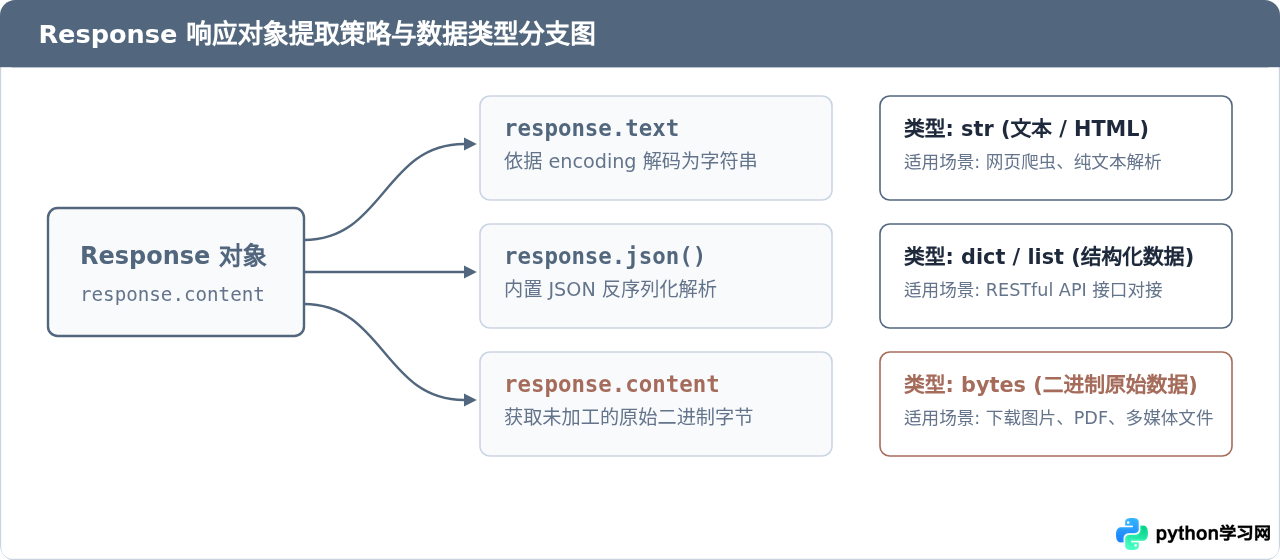
四、生产级异常捕获与容错处理
网络请求天然具备不可靠性。DNS 解析失败、TCP 连接超时、对端强行重置连接、HTTP 500 服务器内部错误都是日常运行中必然遇到的异常情况。
1. requests 异常层次体系
requests 所有自定义异常均派生自 requests.exceptions.RequestException。在编写防御式代码时,应当按照“从具体到通用”的顺序捕获异常:
requests.exceptions.Timeout:连接建立超时或数据读取超时。requests.exceptions.ConnectionError:DNS 寻址失败、拒绝连接或网络中断。requests.exceptions.HTTPError:通过raise_for_status()主动触发的 4xx/5xx 状态异常。requests.exceptions.RequestException:顶级基类,用于最后兜底捕获所有未预料到的库内异常。
2. 健壮的标准请求处理模板
下面给出了工业级脚本中标准的 requests.get() 封装模式,结合了超时控制、状态码检查与分级异常捕获:
import requests
from requests.exceptions import Timeout, ConnectionError, HTTPError, RequestException

def fetch_api_data(target_url, params=None):
    headers = {
        "User-Agent": "MyDataCollector/1.0",
        "Accept": "application/json"
    }
    try:
        # connect 超时 3 秒,read 超时 10 秒
        response = requests.get(target_url, params=params, headers=headers, timeout=(3.05, 10))

        # 遇到 4xx / 5xx 抛出 HTTPError
        response.raise_for_status()

        return response.json()

    except Timeout:
        print(f"请求超时: 目标地址 {target_url} 响应时间超过阈值。")
    except ConnectionError:
        print(f"连接失败: 无法与目标服务器建立连接,请检查网络或DNS配置。")
    except HTTPError as err:
        print(f"HTTP错误响应: 状态码 {err.response.status_code},响应内容: {err.response.text[:100]}")
    except RequestException as err:
        print(f"未知的 Requests 异常: {err}")
    except ValueError:
        print("JSON解析异常: 响应并非合法的 JSON 格式。")

    return None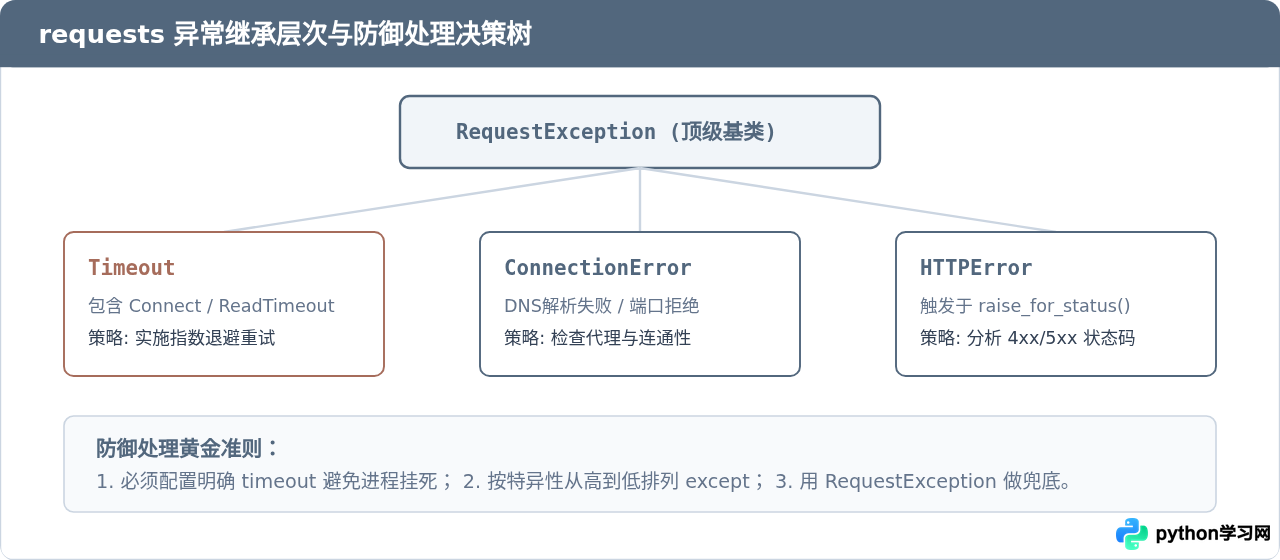
五、核心要点总结与性能进阶
掌握 requests.get() 不仅仅是学会调用一个函数,而是掌握 HTTP 通信的关键控制点。下表总结了最常见的使用场景与对应推荐方案:
| 业务场景 | 推荐调用方式 | 关键注意事项 |
|---|---|---|
| 获取 HTML 网页 | requests.get(url, headers=..., timeout=10).text |
若有中文乱码,检查 response.encoding 并按需覆盖。 |
| 对接 RESTful JSON 接口 | requests.get(url, params=..., timeout=5).json() |
先调用 raise_for_status(),避免解析错误 HTML 页导致崩盘。 |
| 下载图片/文档/大文件 | requests.get(url, stream=True, timeout=15) |
读取 response.content 或使用 iter_content() 逐块写入磁盘。 |
| 高频循环请求同一主机 | 升级为 requests.Session() |
复用底层 TCP 连接池,大幅降低 TLS 握手开销。 |
如果在脚本中需要向同一个域名连续发送数十次甚至上百次 GET 请求,应当创建 session = requests.Session() 并调用 session.get()。这不仅能跨请求持久化 Cookie,更能重用底层的 TCP 套接字连接(HTTP Keep-Alive),在网络延迟较高的环境下可获得成倍的性能提升。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















