


Python中read、readline和readlines读取txt的区别
深入解析Python中read()、readline()与readlines()读取文本文件的核心区别,包括返回值类型、内存占用机制、文件指针移动过程及大文件最佳实践。
read()、readline() 和 readlines() 三个方法。虽然它们都用于提取文本,但核心区别集中在三个维度:返回值的数据类型(单一字符串、单行字符串还是字符串列表)、文件指针的步进方式,以及内存资源的占用规律。正确理解这三者的机制,是避免程序内存溢出并编写高鲁棒性文件操作代码的基础。
一、核心特性速览与对比清单
在深入每个方法的运行细节前,可以通过下表快速掌握三者及扩展迭代方式的核心差异与适用界限:
| 方法名称 | 返回值类型 | 单次读取规模 | 内存消耗特征 | 典型适用场景 |
|---|---|---|---|---|
read([size]) |
str |
全部内容(或指定字节/字符) | 高(一次性全部装载进内存) | 小型配置文件、需要做全文正则替换或分词 |
readline([size]) |
str |
单行内容(含行末换行符) | 极低(内存中仅保留一行数据) | 逐行排查解析、读取前几行文件头、定制循环 |
readlines([hint]) |
list[str] |
全部行(以行为元素构建列表) | 极高(包含完整文本及列表对象开销) | 中小型文件、需要根据行号索引逆序或随机访问 |
for line in f |
生成器迭代出的 str |
单行惰性流式产出 | 极低(Python 推荐的工业级标准) | 任何规模(尤其是几百MB至数十GB)的文本逐行遍历 |
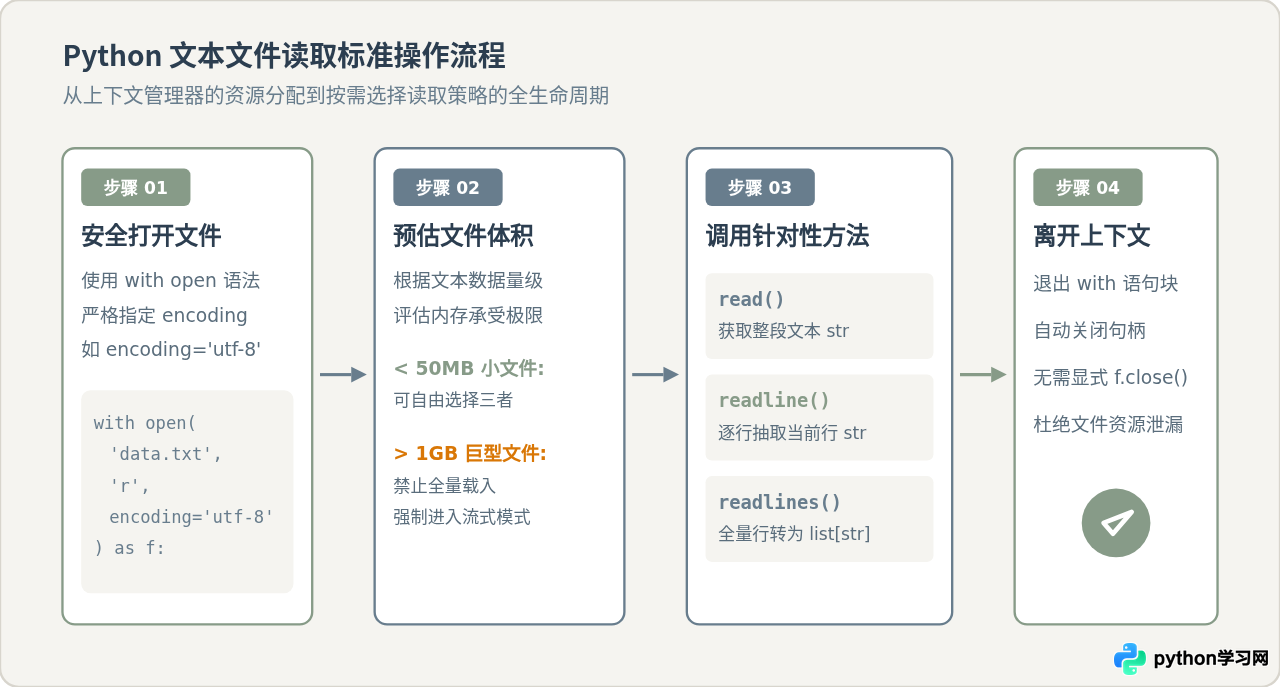
二、三种读取方法的语法细节与行为拆解
1. read([size]):一次性读取全部内容
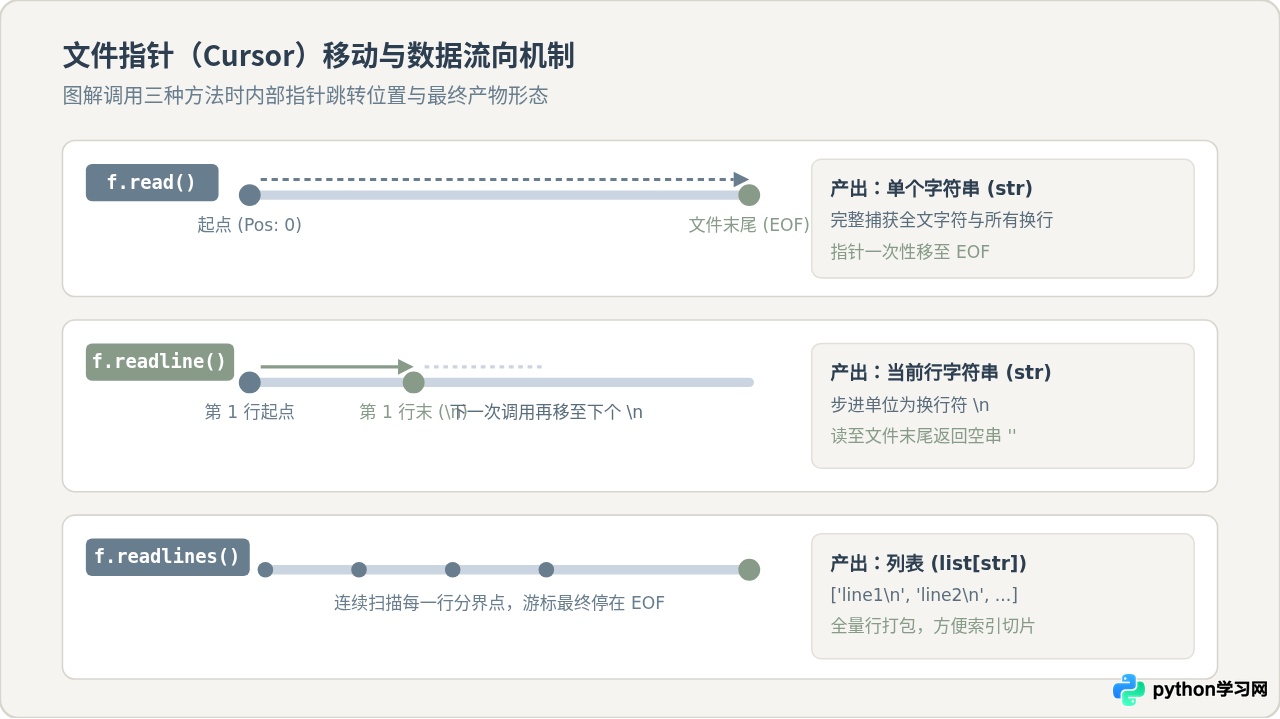
read() 方法是直观的文本提取方式。在不传参数或参数为负数时,它会从当前文件指针所在位置一直读取到文件末尾(EOF),并将所有读到的内容拼装为一个独立的字符串(str)返回。
# 示例:使用 read() 读取整个文件
with open('sample.txt', 'r', encoding='utf-8') as f:
    content = f.read()
    print(type(content))  # <class 'str'>
    print(content)
read() 还接受一个可选的整型参数 size。在文本模式('r')下,size 表示最多读取的字符数(不是字节数);在二进制模式('rb')下,size 则代表字节数。当文件很大但我们只需要探测前若干字符时,read(size) 非常实用。
# 仅读取前 20 个字符
with open('sample.txt', 'r', encoding='utf-8') as f:
    header = f.read(20)
    print(f"前20个字符为: {header}")
2. readline([size]):细粒度推进单行游标
readline() 每次只读取文本的一行,其读取终点以遇到换行符 \n(或文件末尾 EOF)为准。返回结果是包含行末换行符在内的单个字符串。
特别需要关注该方法的结束标志:当读到文件末尾时,readline() 会返回一个空字符串 ''。如果遇到文本中的空行,它返回的是带有换行符的字符串 '\n'。因此,在通过循环读取时,判断退出的依据必须是 line == '',而不能简单写 if not line:(这会导致在读到文本空行时提前跳出循环)。
# 示例:通过 readline() 精确遍历单行
with open('sample.txt', 'r', encoding='utf-8') as f:
    while True:
        line = f.readline()
        if line == '':  # 读到 EOF,真正结束
            break
        print(line.rstrip('\r\n'))  # 去除末尾换行符打印
3. readlines([hint]):将全文行映射为列表
readlines() 内部会从当前文件指针开始扫过整个文件,将每一行作为一个独立的字符串元素存入一个 Python 列表中,最终返回 list[str]。列表中每个元素末尾都完整保留对应的 \n 字符。
# 示例:使用 readlines() 获取行列表
with open('sample.txt', 'r', encoding='utf-8') as f:
    lines = f.readlines()
    print(type(lines))        # <class 'list'>
    print(f"总行数: {len(lines)}")
    # 利用列表特性获取前5行并清洗换行符
    first_five = [line.strip() for line in lines[:5]]
readlines() 的优势在于保留了行序列表,可以直接使用切片(如 lines[-10:] 取末尾10行)或通过索引随机访问某一行。但其代价是将全量数据及列表外壳一次性打包进内存。
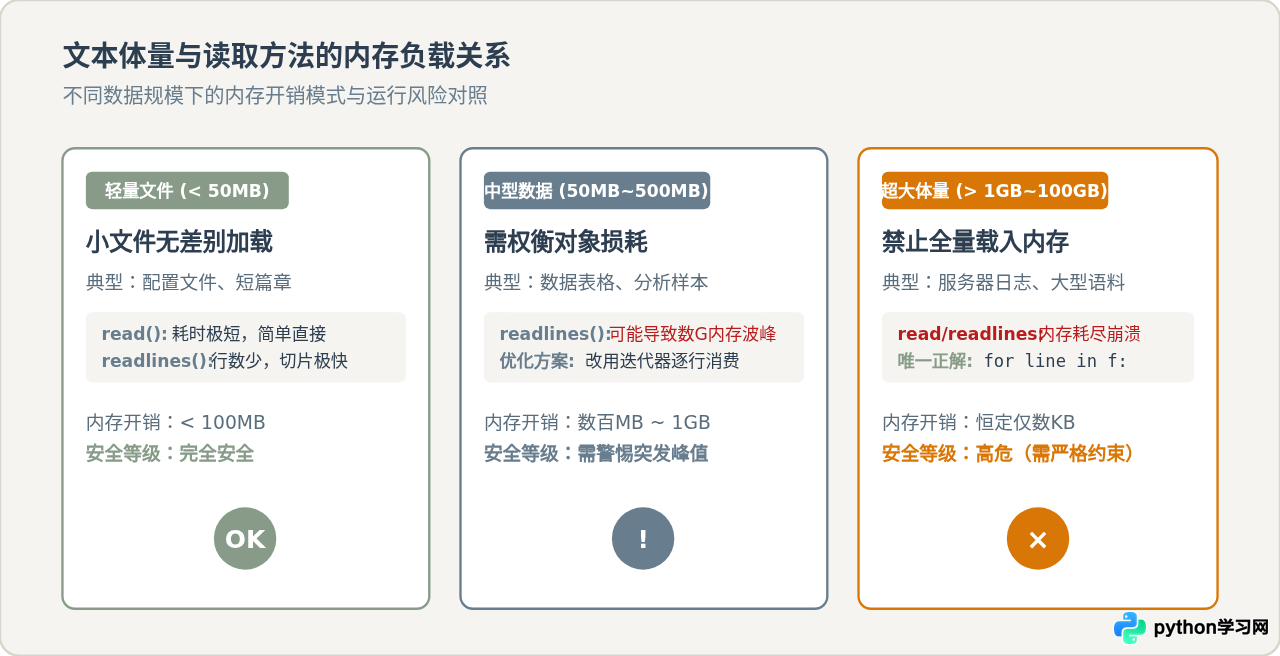
三、深层机制探究:内存暴涨的原因与数据规模分界
为什么在处理几百兆或数个吉字节(GB)的日志文件时,严禁使用 read() 或 readlines()?原因深植于 Python 的对象内存模型:
read()的内存倍增效应:调用read()时,Python 必须向操作系统一次性申请连续的内存空间来承载整个文件。当进行后续处理(例如基于split()切分或进行字符串解码)时,会在内存中额外产生新对象,导致内存占用瞬间达到文件本身大小的 2 到 3 倍。readlines()的指针与对象开销:一个包含 1000 万行的小型文本,其磁盘大小可能仅有 200MB。但在使用readlines()时,Python 会为这 1000 万行创建 1000 万个独立的PyUnicodeObject对象,以及一个包含 1000 万个指针地址的巨型list数组。在 64 位系统下,仅这些对象的元数据与指针开销就会耗尽数个 GB 的内存,极易触发操作系统的 OOM Killer(内存溢出终止)。
四、现代 Python 工程的黄金准则:文件迭代器
在早期的 Python 代码中,很多人习惯通过 for line in f.readlines(): 来逐行处理文本。然而在现代 Python 规范中,这种写法被视为典型的反模式(Anti-Pattern)。
因为 Python 的文件对象 f 本身就是一个实现了迭代协议的可迭代对象(Iterable)。直接编写 for line in f: 即可触发底层系统级的缓存读取机制:
# 工业级推荐:直接迭代文件对象
with open('huge_access.log', 'r', encoding='utf-8') as f:
    for line in f:
        # 每次只在内存中解构当前行
        if 'ERROR' in line:
            print(line.rstrip())
这种写法的内存占用是恒定的(仅相当于当前单行的长度),哪怕面对 50GB 的海量文本,程序所占内存也始终保持在数 KB 到数 MB 级别,同时消除了构建超大列表所耗费的 CPU 时钟周期。
五、高频踩坑点与排查要点
1. 换行符的清洗方式:三个方法返回的字符串末尾都会保留原汁原味的 \n(Windows 下可能是 \r\n)。如果使用 line.strip(),会连同字符串开头的缩进空格和制表符一并剔除;如果仅仅希望去除末尾换行而保留行首缩进,务必使用 line.rstrip('\r\n')。
2. 游标耗尽导致二次读取为空:文件指针是单向推进的。如果在同一次 with 上下文中执行了 data = f.read(),随后又调用 lines = f.readlines(),此时 lines 将永远是空列表 []。如果确实需要重复扫描,必须显式调用 f.seek(0) 将游标拨回文件起始处。
3. 显式指定字符编码:在不同操作系统上,open() 的默认编码可能不同(Windows 默认通常是 GBK,Linux/macOS 默认是 UTF-8)。读取 .txt 时若不显式指定 encoding='utf-8',极易引发 UnicodeDecodeError。
六、总结
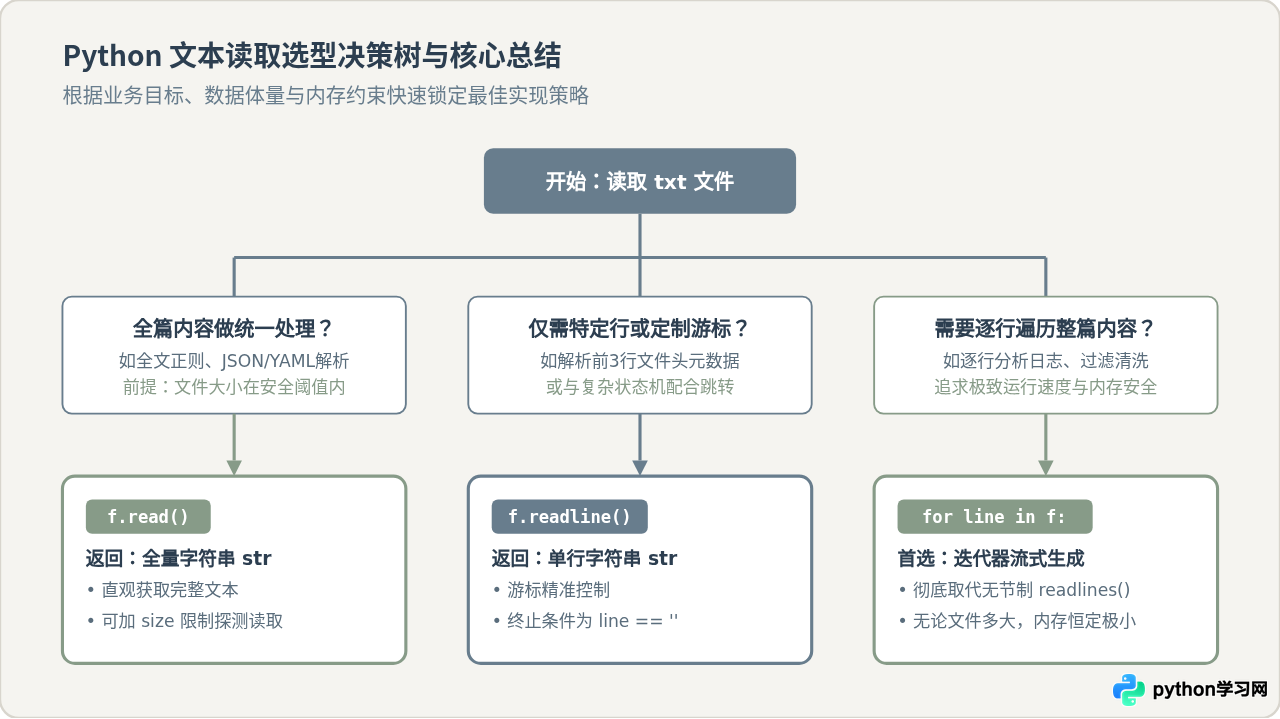
掌握 read()、readline() 与 readlines() 的区别,本质上是掌握数据承载结构与计算机物理资源(内存与磁盘I/O)之间的平衡:
若需要对小文件进行全文字符串操作,选用 read() 干净利落;若需要定制控制行游标(如单独解析表头),选用 readline() 精准受控;若明确需要在内存中依据索引多次切片小文件,可以使用 readlines();而当面对日常开发中绝大多数逐行数据处理任务时,直接使用 for line in f 是兼顾代码优雅性与工业级性能的终极方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















