


为什么Python集合的成员检查速度比列表快
深入解析Python中集合(set)成员检查速度远快于列表(list)的核心机制,从底层数据结构、哈希表实现、时间复杂度对比到实际代码测试与使用注意事项全面展开。
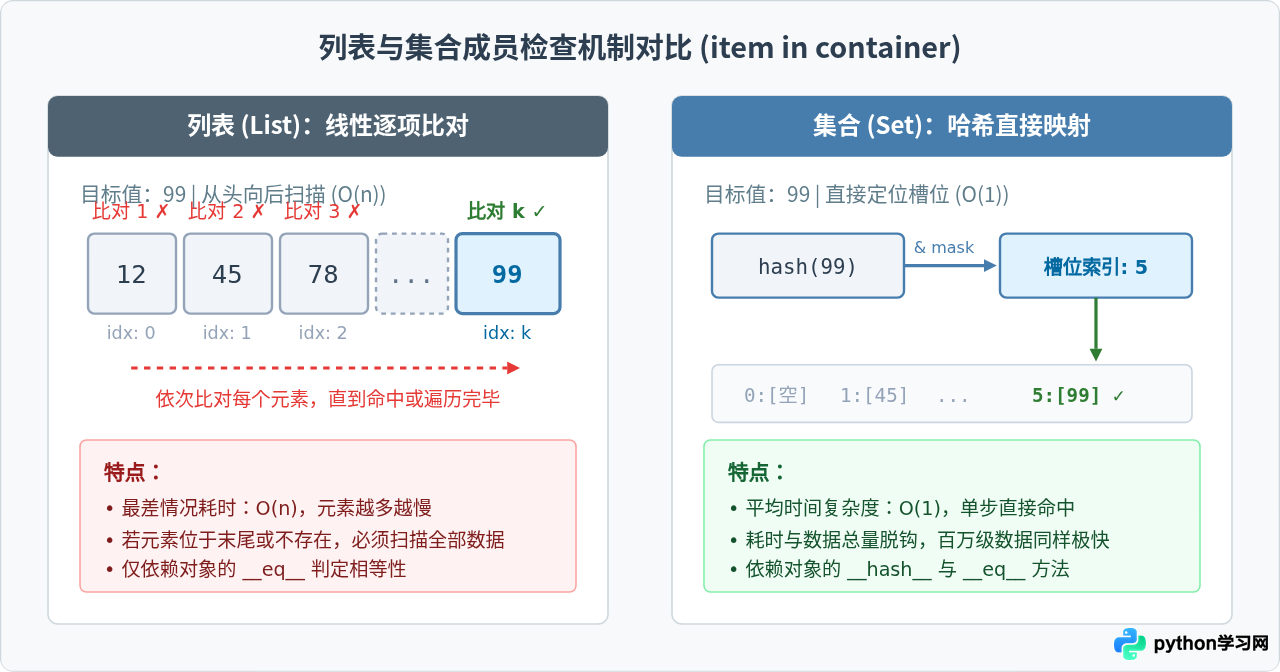
in 关键字执行成员检查时,集合(set)的平均时间复杂度为 O(1),而列表(list)的时间复杂度为 O(n)。两者速度产生巨大差距的根源在于底层数据结构:集合基于哈希表实现,通过计算哈希值直接定位存储位置;列表底层是连续内存数组,成员检查必须从头到尾逐个比对元素。
底层存储结构的根本差异
要理解两者的速度差异,必须先看它们在内存中如何组织数据。Python 的列表和集合在 CPython 底层对应完全不同的 C 语言结构体。
列表在 CPython 中是由 PyListObject 表示的动态数组。列表中的元素按照插入顺序保存在一段连续的指针数组中。当你在列表中检查某个元素是否存在时,Python 没有额外的索引信息,只能从索引 0 开始,按顺序逐一比较每个元素与目标值是否相等,直到找到目标或检查完整个数组。如果列表中有 1,000,000 个元素且目标值在末尾或不存在,Python 就必须执行 1,000,000 次比较操作。
与此相对,集合在 CPython 中是由 PySetObject 表示的散列表(哈希表)。集合不维护元素的线性顺序,而是根据元素的哈希值把元素分散到不同的哈希槽(buckets)中。检查元素时,Python 直接计算该元素的哈希值,通过数学运算映射到槽位下标,然后直接前往该槽位读取并验证。这一过程的耗时基本不随集合中元素总量的增加而改变。
集合查找内部机制与推导步骤
当执行表达式 x in s 时,集合并不会“遍历”自身,而是执行一套精确的数学计算和内存地址跳转流程。以下是 Python 解释器内部执行集合成员检查的标准步骤:
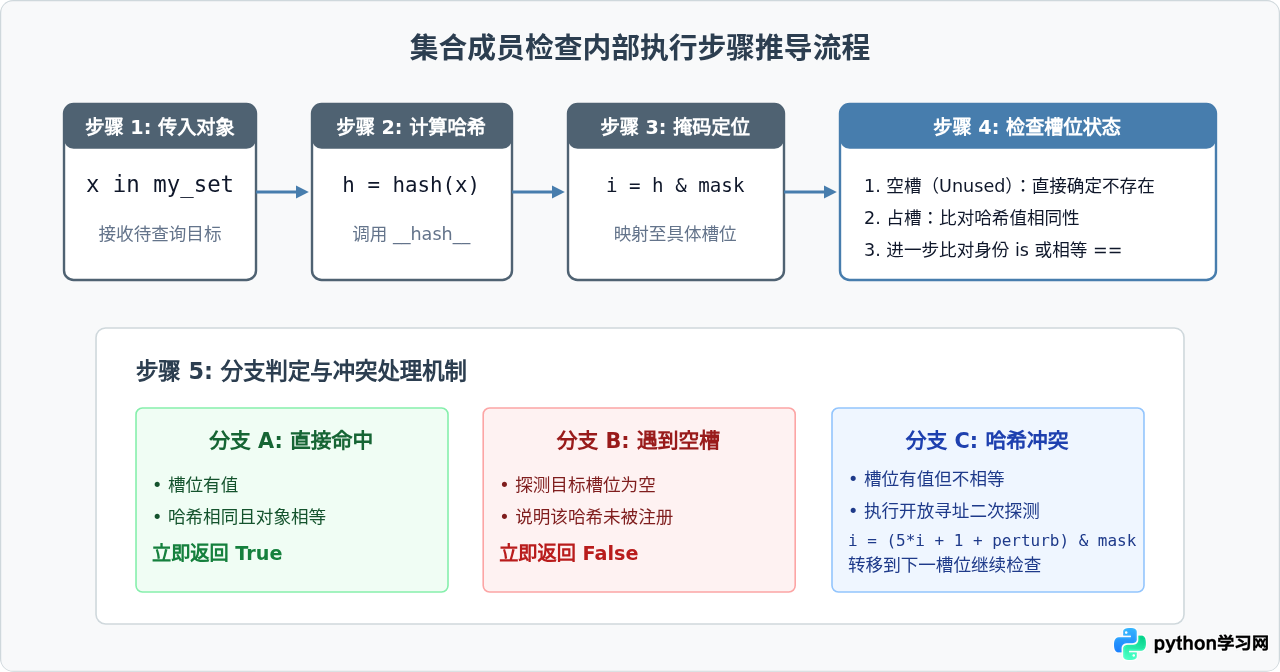
从以上步骤可以看出:
- 快速短路:在极高概率下,目标哈希槽要么正好存放着目标元素(单次直接返回
True),要么是一个空槽(单次直接返回False)。只有在极罕见发生哈希碰撞时,才会进行有限步的二次探测。 - 双重校验保障正确性:为了防止不同对象偶发哈希碰撞导致误判,Python 在槽位匹配时,首先比对 64 位整数哈希值;如果哈希值相同,再比对引用标识(
a is b);若引用不同,最后调用a == b。这种设计兼顾了安全与极限速度。
实际性能基准测试对比
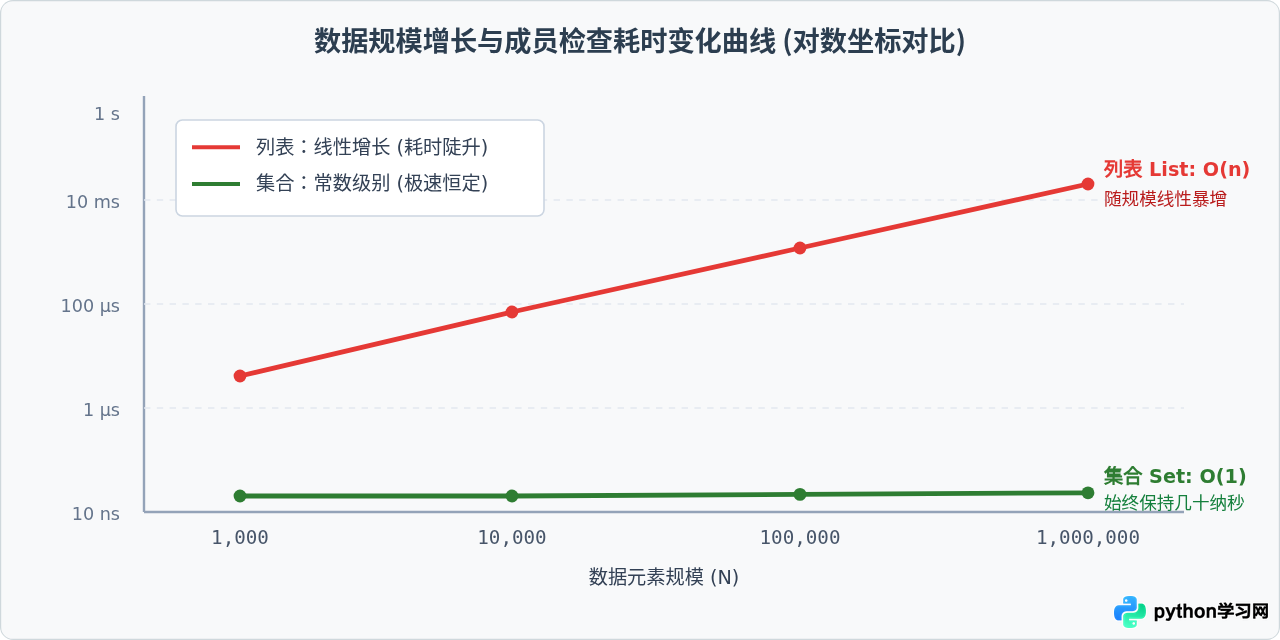
为了直观展现两者在不同数据规模下的速度差距,我们可以使用标准库的 timeit 模块在相同的环境下执行成员检查基准测试。以下是测试代码与实测数据的量化对比:
import timeit

# 分别准备不同规模的数据集
sizes = [1_000, 10_000, 100_000, 1_000_000]

for size in sizes:
    test_list = list(range(size))
    test_set = set(range(size))

    # 查询一个不存在的元素(最坏情况),测量执行10,000次的总耗时
    target = -1

    list_time = timeit.timeit(lambda: target in test_list, number=1000)
    set_time = timeit.timeit(lambda: target in test_set, number=1000)

    print(f"数据量: {size:>9} | 列表: {list_time*1000:>8.3f} ms | 集合: {set_time*1000:>8.3f} ms | 速度倍数: {list_time/set_time:>6.0f}x")
| 数据规模 (N) | 列表单次检查耗时 (典型值) | 集合单次检查耗时 (典型值) | 性能倍率差异 | 算法复杂度 |
|---|---|---|---|---|
| 1,000 | 约 12.5 微秒 (µs) | 约 45 纳秒 (ns) | 集合快约 270 倍 | O(n) vs O(1) |
| 10,000 | 约 128 微秒 (µs) | 约 46 纳秒 (ns) | 集合快约 2,700 倍 | O(n) vs O(1) |
| 100,000 | 约 1.35 毫秒 (ms) | 约 48 纳秒 (ns) | 集合快约 28,000 倍 | O(n) vs O(1) |
| 1,000,000 | 约 14.2 毫秒 (ms) | 约 50 纳秒 (ns) | 集合快约 280,000 倍 | O(n) vs O(1) |
使用集合的代价与限制条件
虽然集合在成员检查方面具有压倒性的性能优势,但这并不意味着可以在所有场景下无脑替代列表。采用哈希表结构带来了两个不可忽视的前置约束与资源代价:
1. 元素必须是“可哈希”对象(Hashable)
集合的定位依赖对象的 __hash__ 方法。在 Python 中,只有不可变对象(如整数、浮点数、字符串、元组、frozenset 等)才默认实现了哈希方法。可变容器(如列表、字典、普通集合)是不可哈希的。如果你试图把列表放入集合中进行检查,Python 会立即抛出异常:
# 错误示例:列表不可哈希
invalid_set = {[1, 2], [3, 4]}
# 抛出: TypeError: unhashable type: 'list'

# 正确做法:转换为不可变的元组 (tuple)
valid_set = {(1, 2), (3, 4)}
print((1, 2) in valid_set)  # 正常运行,输出 True
2. 内存占用开销更高(空间换时间)
为了保证哈希表的高效运作并降低哈希冲突概率,集合底层必须保留充足的空闲槽位。CPython 会将集合的装载因子(Load Factor)维持在较低水平。当元素占满约三分之二时,集合就会触发自动扩容。这意味着存储相同数量的元素,集合通常比紧凑连续的列表消耗 2 至 4 倍的内存空间。
in 检查的业务逻辑中,集合的性能优势才会显现出量级差距。
工程实践中的技术选型指南
在日常开发与算法优化中,可以根据以下技术决策路径选择合适的数据结构:
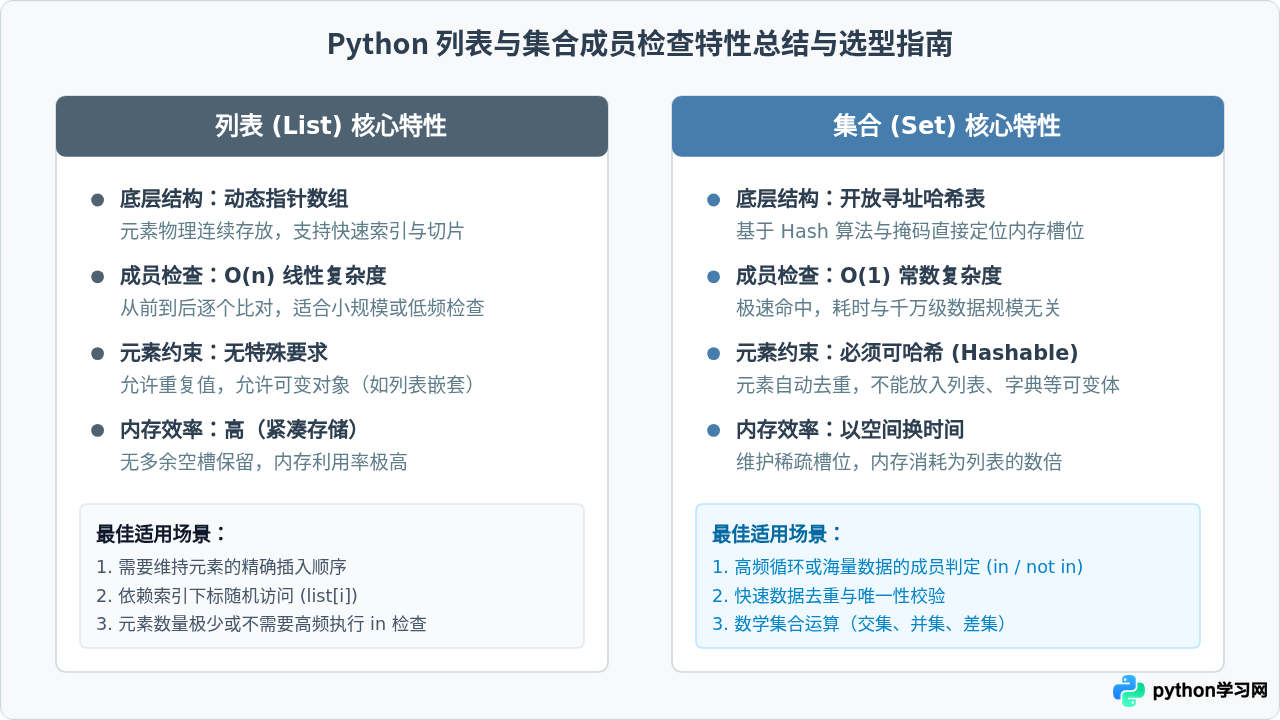
总结
Python 集合的成员检查之所以远快于列表,归根结底是由底层算法结构决定的:
- 算法本质不同:列表检查是 O(n) 线性扫描,随着数据增长耗时成倍放大;集合检查是 O(1) 哈希定位,耗时保持在常数级别。
- 寻址路径不同:列表必须从下标 0 开始依次调取对象做等值比较;集合通过
hash(x) & mask在纳秒级别直接命中内存槽位。 - 权衡之道:在需要高频检查成员关系的大数据量场景中,预先将列表转换为集合(
set(data_list))是常见且极其高效的代码性能优化手段。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















