



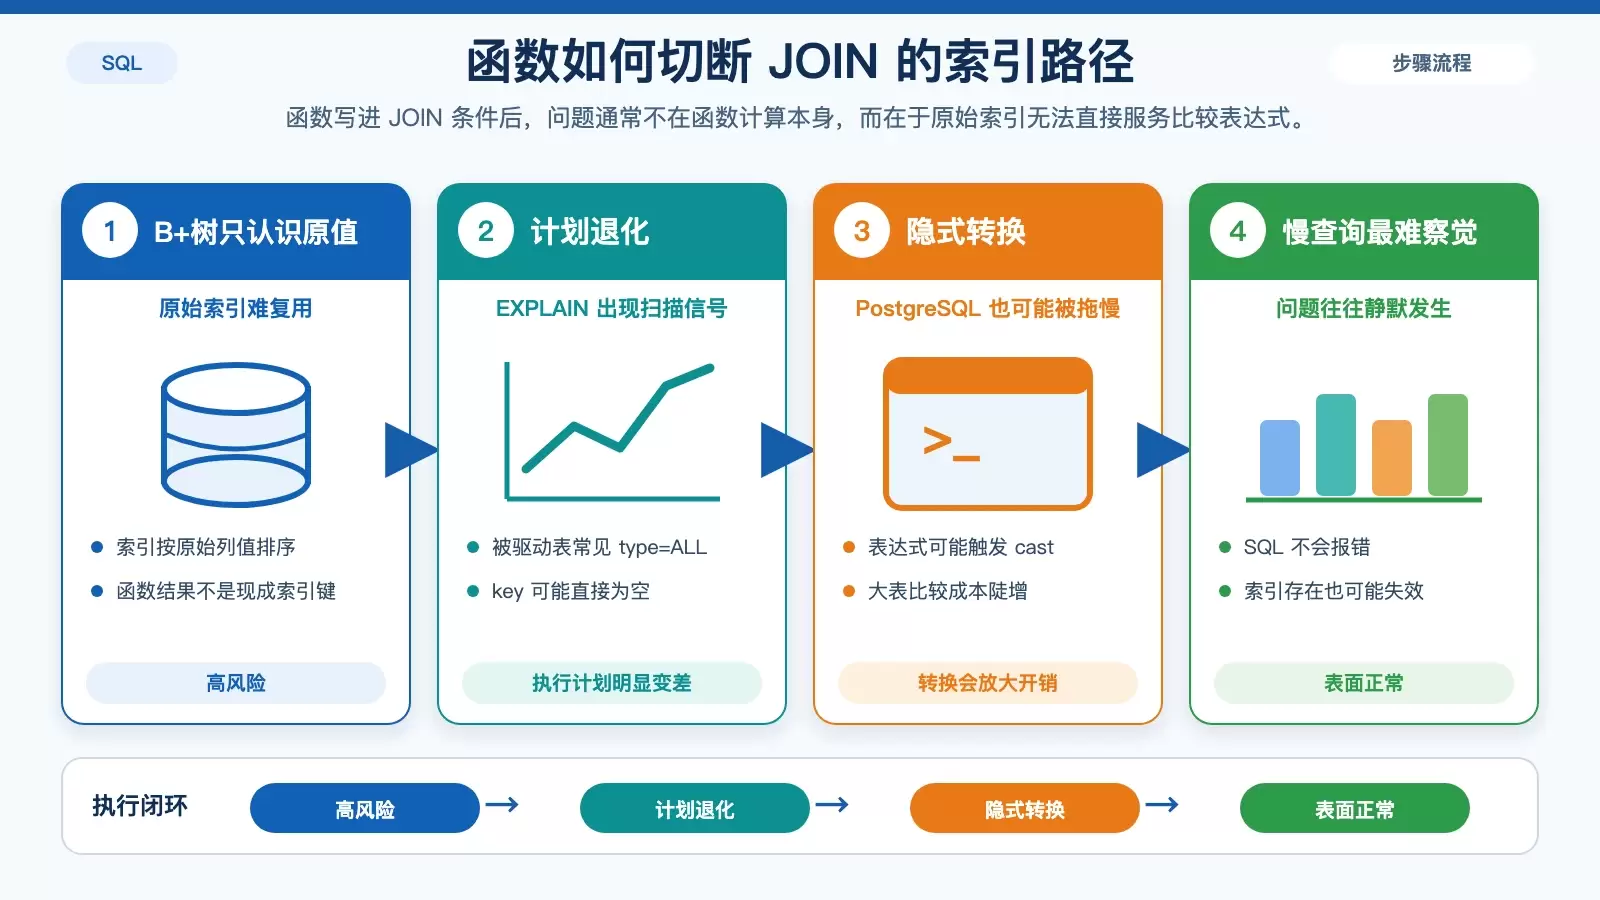
很多 JOIN 变慢,并不是因为函数本身耗时夸张,而是函数把原本可用的索引路径切断了。像 UPPER()、LOWER()、DATE() 这类写法一旦出现在 ON 条件里,数据库往往只能退回到更粗暴的扫描或逐行比较。判断这类问题,重点不是 SQL 看起来是否“简洁”,而是去看 EXPLAIN 里被驱动表的 type、key 有没有明显退化;理解这一点后,也就能更稳地在函数索引、字段标准化和范围查询之间做取舍。
JOIN 条件里为什么一用函数就容易失去索引
在 ON 子句中对字段做函数处理,是最常见也最隐蔽的性能陷阱之一。例如:
UPPER(a.name) = UPPER(b.name)
DATE(a.created_at) = DATE(b.date)
这类写法的问题,不在于函数一定“算得慢”,而在于优化器很难把函数结果和原有索引的 B+ 树有序结构对应起来。索引存储的是原始列值,而不是运行时临时算出来的结果;一旦列被包进函数,优化器通常就无法确认还能否沿着已有索引高效定位。
结果就是,本来可以靠索引快速匹配的 JOIN,可能直接退化成全表扫描或大范围扫描。实际排查时,常见现象包括:
- 执行计划里被驱动表的
type变成ALL,key为空; - 即使两边字段类型、字符集、索引都一致,仍然不走索引;
- 在 PostgreSQL 中,还可能因为隐式转换,把整张大表 cast 成
text后再比较,原本 500 万行订单表约 80ms 的查询,可能涨到 6.2s。
所以,JOIN 里套函数最麻烦的后果,往往不是多做几次计算,而是数据库放弃了本来最有效的访问路径。
字符集或排序规则不一致时,硬加 COLLATE 为什么通常更慢
有些慢查询并不是因为业务上真的要做大小写转换,而是两张表字段的字符集或 COLLATION 不一致。此时有人会在 ON 条件里直接补上 COLLATE,例如:
t1.name COLLATE utf8mb4_0900_as_cs = t2.name COLLATE utf8mb4_0900_as_cs这看起来像是把两边规则“临时统一”了,但对执行性能帮助很有限,很多情况下反而更慢。
原因主要有三点:
- MySQL 优化器会在生成执行计划前先做语义推导,只要字段原始
COLLATION不一致,就很可能不愿意走索引; - 这种写法通常命不中已有索引,效果接近于每行都实时做一次 collation 转换,CPU 开销明显增加;
- 它只是把定义不一致的问题推迟到运行时处理,没有真正修复表结构。
更稳妥的做法,是直接统一字段定义,用 ALTER TABLE MODIFY 一次性修正,并且同时指定 CHARACTER SET 和 COLLATE。这样优化器看到的就是一致的原始列定义,而不是运行时临时转换的表达式。
既要保留函数语义又想要性能,只有两条靠谱路径
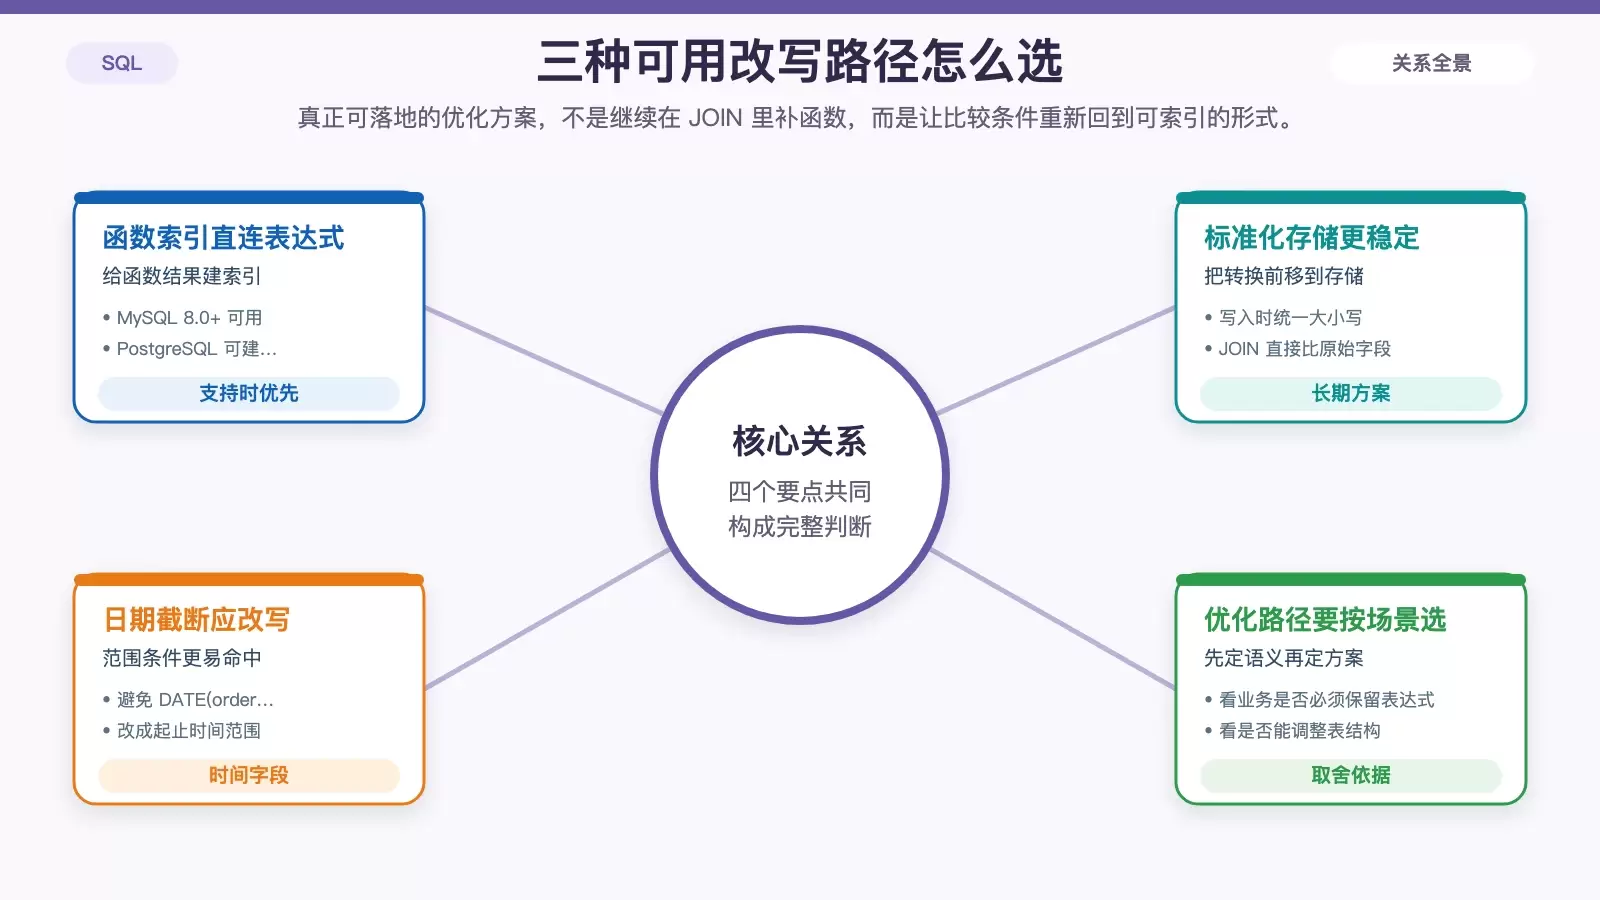
如果业务确实要求大小写不敏感匹配、日期截断匹配,靠在 JOIN 条件里临时包一层函数,并不是长期方案。真正可用的路径,通常只有下面两类。
方案一:建立函数索引
如果数据库支持函数索引,这是最直接的做法。比如 MySQL 8.0+ 和 PostgreSQL,就可以把函数结果本身建立索引:
CREATE INDEX idx_users_name_lower ON users ((LOWER(name)))之后在 JOIN 中保留相同表达式:
LOWER(a.name) = LOWER(b.name)这样优化器面对的就不再是“无索引的函数结果”,而是已经索引化的表达式。
方案二:提前标准化存储
如果业务模型允许,提前把数据存成统一格式,通常比运行时处理更稳。典型例子是用户注册时就把 name 存成小写,后续 JOIN 直接比较原始字段,不再临时调用 LOWER() 或 UPPER()。
这种方式的好处很明确:没有运行时转换开销,也不会让已有索引失效。对于高频 JOIN,这往往比查询阶段“补函数”更适合长期维护。
时间字段不要用 DATE() 截断,改写成范围条件更合适
时间条件是另一个高发区。很多人会写出下面这种语句:
DATE(order_time) = '2026-07-20'问题和前面一样:order_time 被函数包住以后,原本建在该列上的索引很可能失效。
更合适的写法是把“某一天”改成明确的时间范围:
order_time >= '2026-07-20' AND order_time < '2026-07-21'这样数据库可以直接利用 order_time 上的索引做范围扫描,通常比对整列逐行执行 DATE() 要高效得多。这个原则不只适用于筛选条件,在涉及时间字段的 JOIN 或关联过滤时同样成立。
排查这类慢 JOIN,先看 EXPLAIN 的两个位置
真正拖慢查询的,往往不是函数本身的那点计算量,而是索引路径消失后,数据库只能用更低效的方式做匹配。排查时优先看 EXPLAIN:
- 被驱动表的
type是否退化到ALL; key是否为空,或者没有命中预期索引。
这比单纯盯着 SQL 写法是否“优雅”更有判断价值。因为这类问题最麻烦的地方就在于:SQL 不会报错,索引明明也建了,查询却只是悄悄变慢。只要 ON 里把列包进函数,那个索引就很可能已经形同虚设。















