实战案例:用Python正则表达式清洗杂乱文本数据
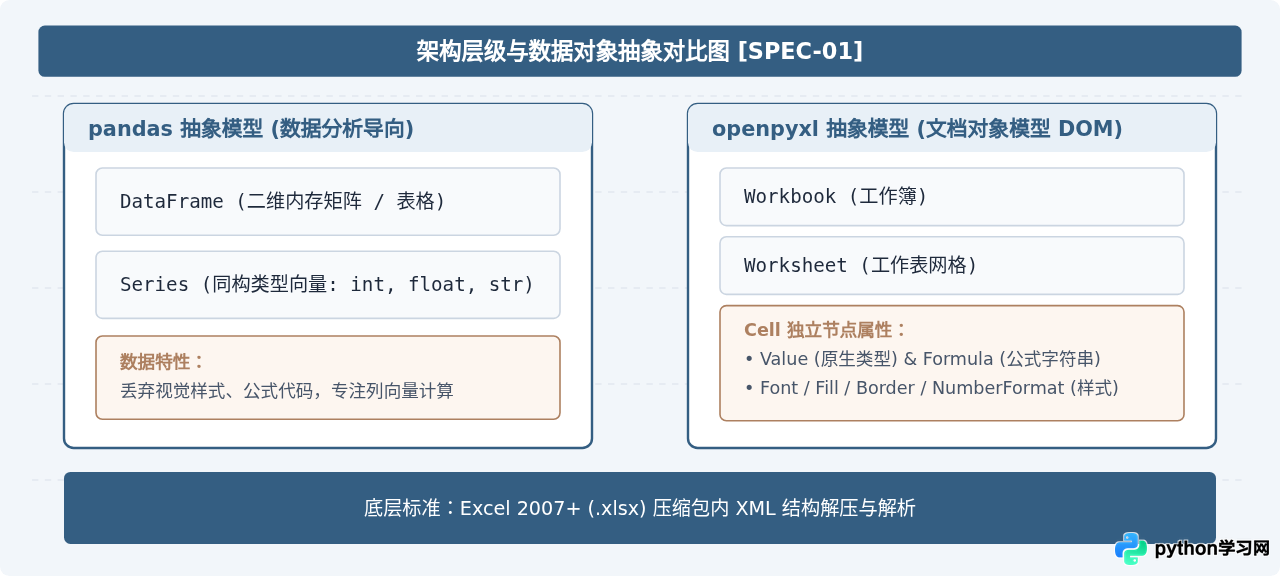
实战案例:用Python正则表达式清洗杂乱文本数据。详细演示如何使用Python内置re模块剥离HTML标签、归一化连续空白、剔除异常符号、提取关键信息并完成格式脱敏。



实战案例:用Python正则表达式清洗杂乱文本数据。详细演示如何使用Python内置re模块剥离HTML标签、归一化连续空白、剔除异常符号、提取关键信息并完成格式脱敏。
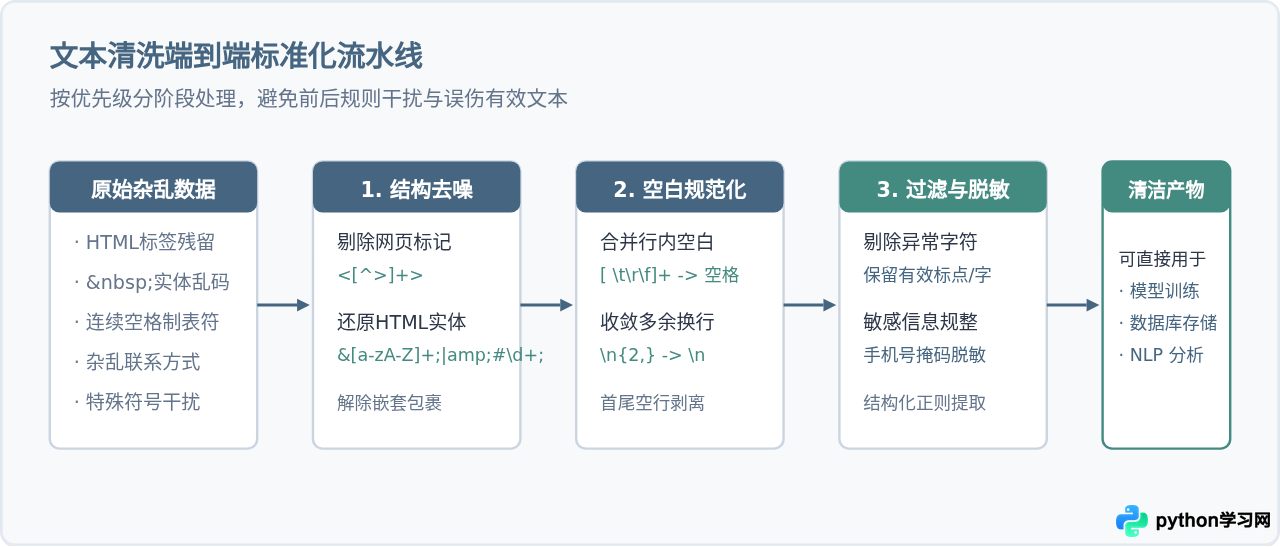
深入对比Python中pandas与openpyxl读取Excel文件的核心差异、底层实现、性能表现与适用场景,提供代码示例与清晰的工程选型决策路径。
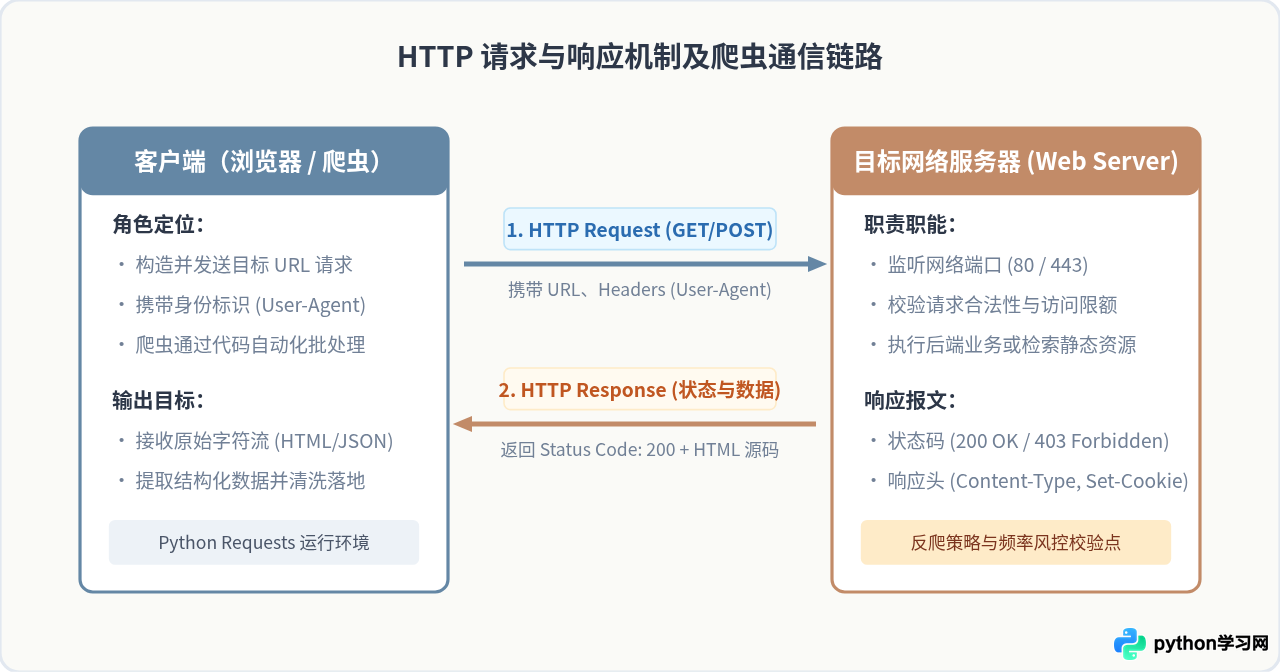
面向初学者的Python数据抓取教程,系统解析HTTP请求响应机制,提供从环境安装、DOM解析到完整代码落地的全流程说明与避坑指南。
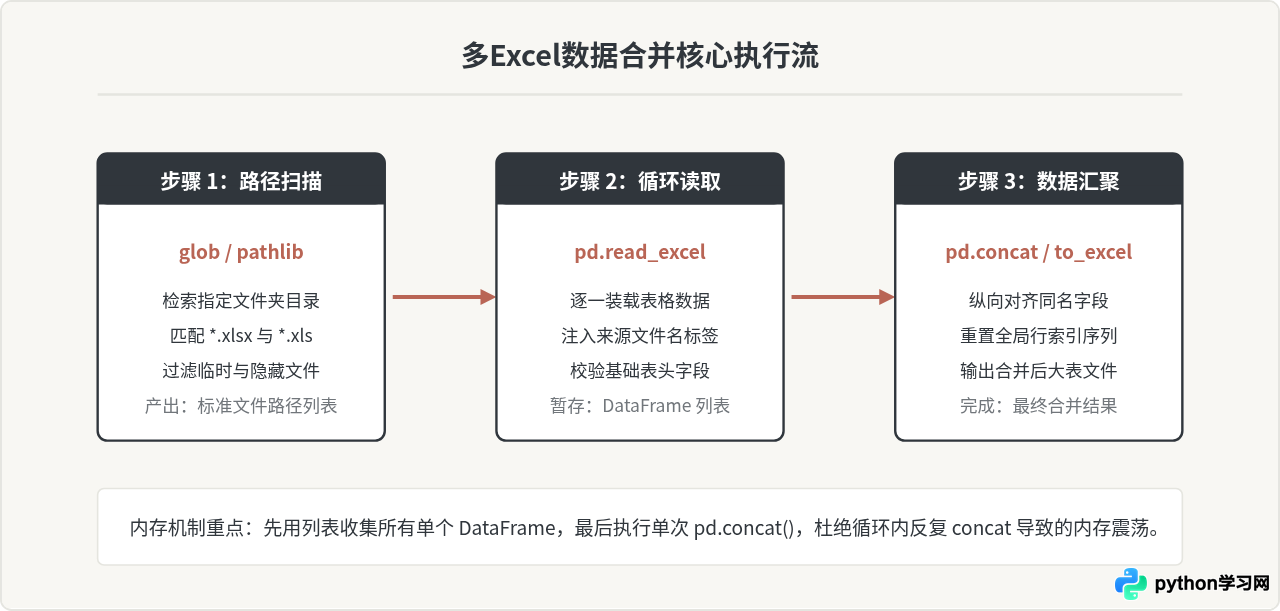
本文详细介绍使用Python批量读取指定文件夹内多个Excel文件并合并为一个完整数据集的完整实现方案,涵盖核心流程、关键代码、格式异常排查与进阶优化技巧。
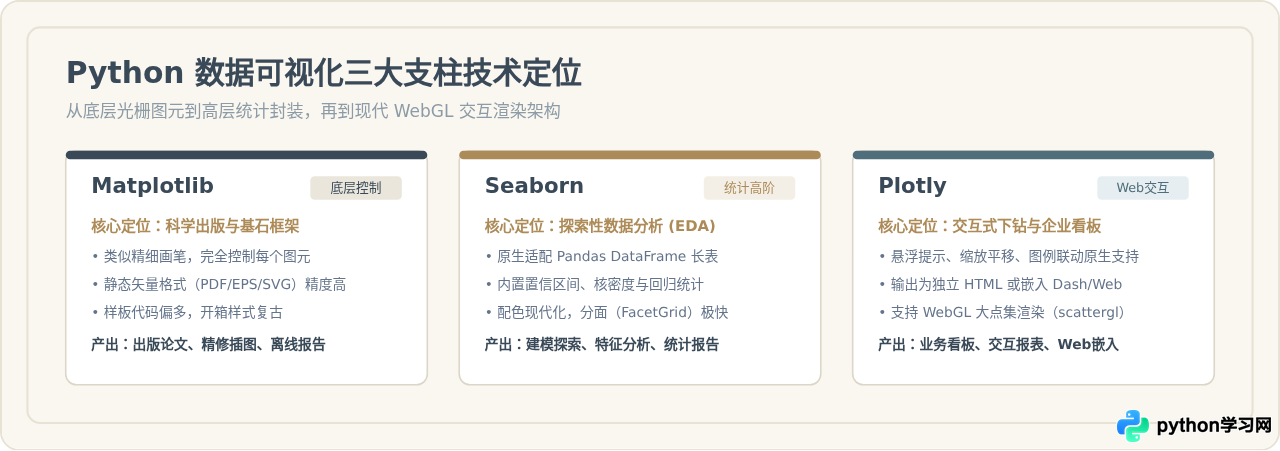
深入对比 Python 主流数据可视化库 Matplotlib、Seaborn 与 Plotly 的设计哲学、代码样板、交互能力、性能表现与适用场景,提供系统化的选型决策指南。
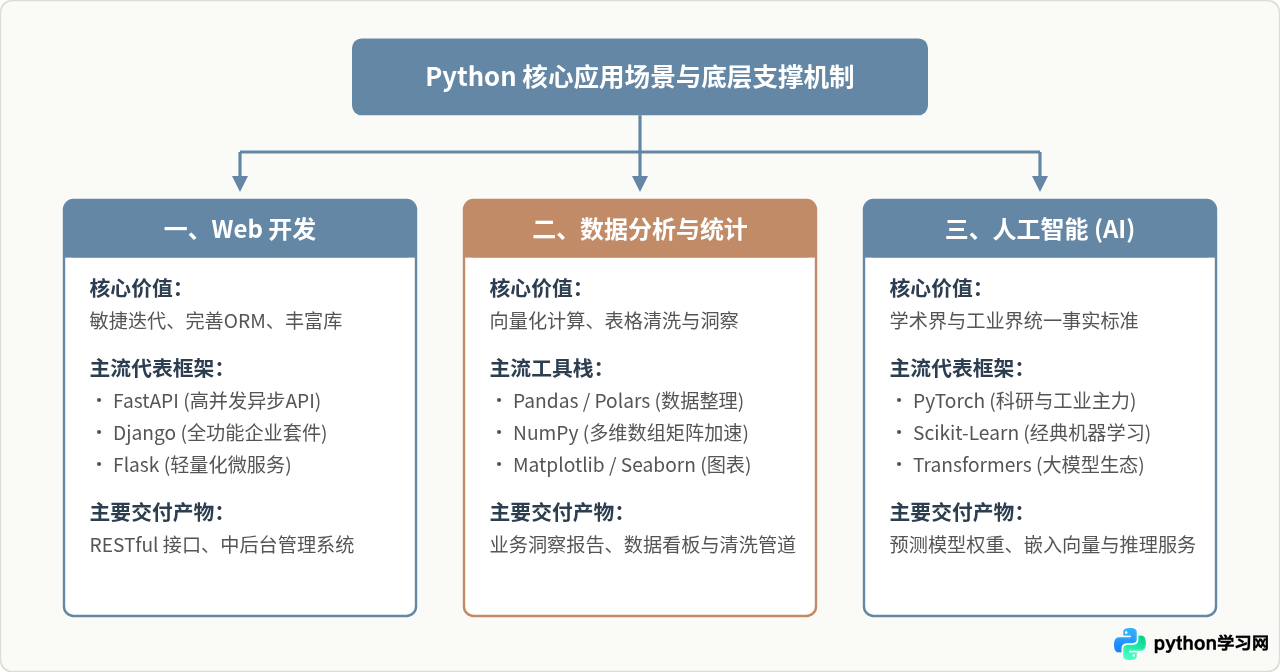
深入解析Python在Web开发、数据分析与人工智能三大核心领域的实际应用场景、技术生态、典型工作流与技术选型建议。
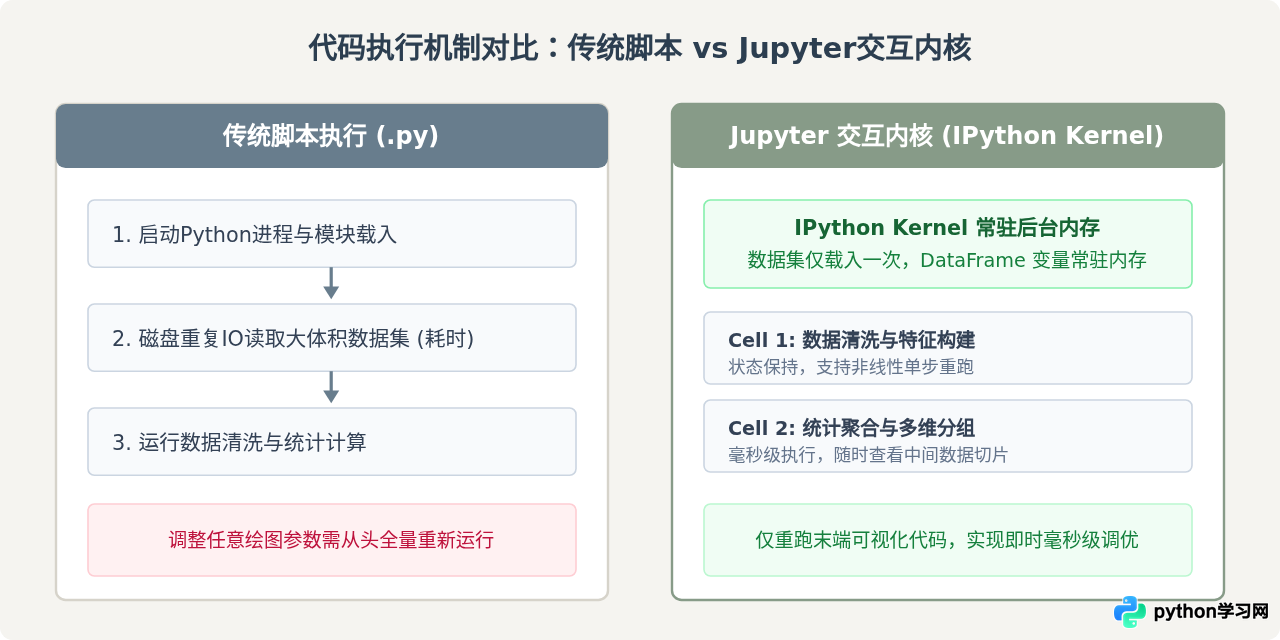
深入解析数据分析师为何普遍选择Jupyter作为Python主力编程工具,从交互式分块执行、内存驻留机制到工作流对比与工程边界,提供详尽分析。
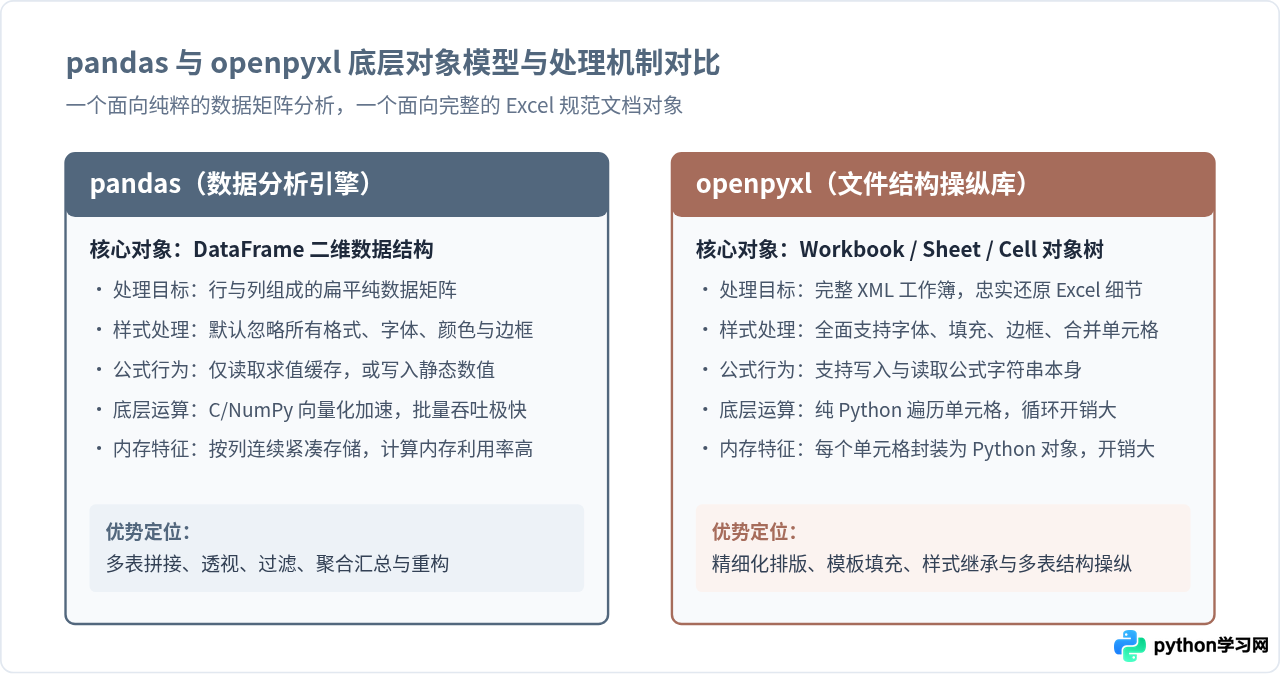
深入对比Python处理Excel汇总时pandas与openpyxl的核心差异、底层原理与适用场景,提供多表批量合并、模板回填与协同流水线的完整实现与选型指南。
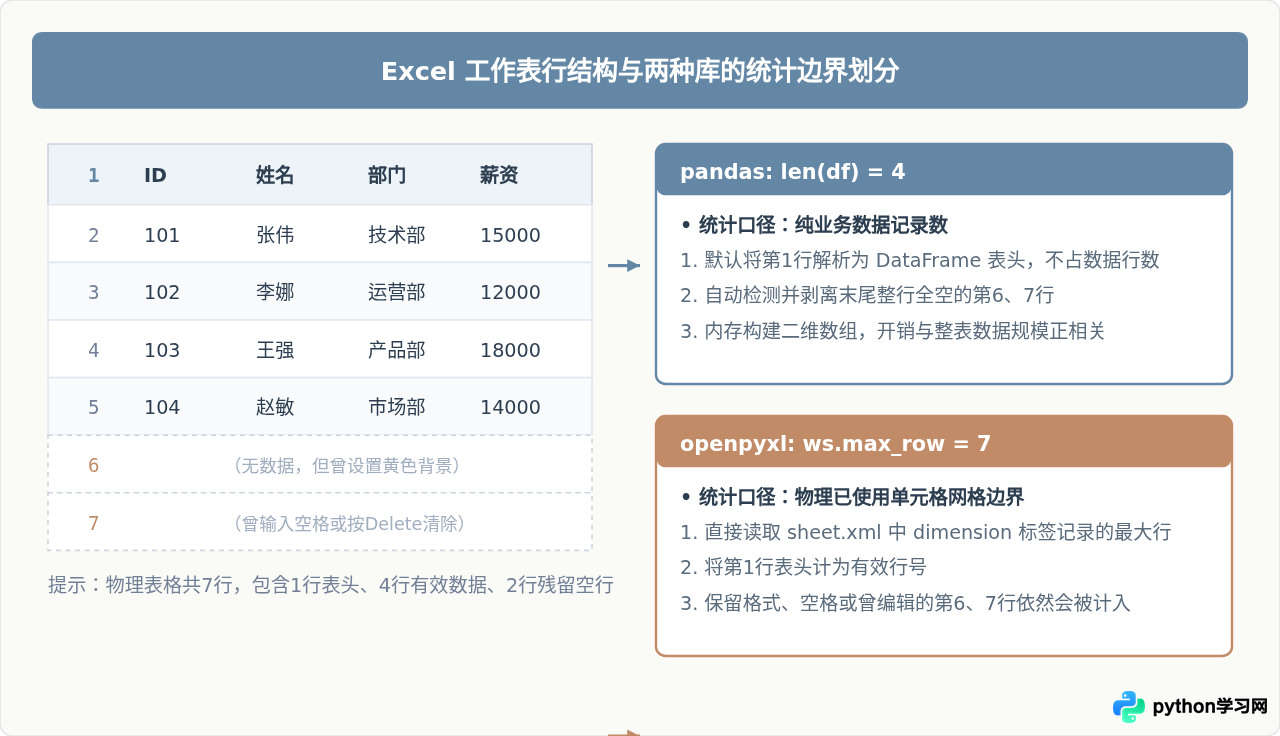
深入对比Python中使用pandas与openpyxl获取Excel工作表行数的底层机制、统计口径区别、空行与格式干扰陷阱以及内存性能差异,提供场景化选择指南与避坑建议。
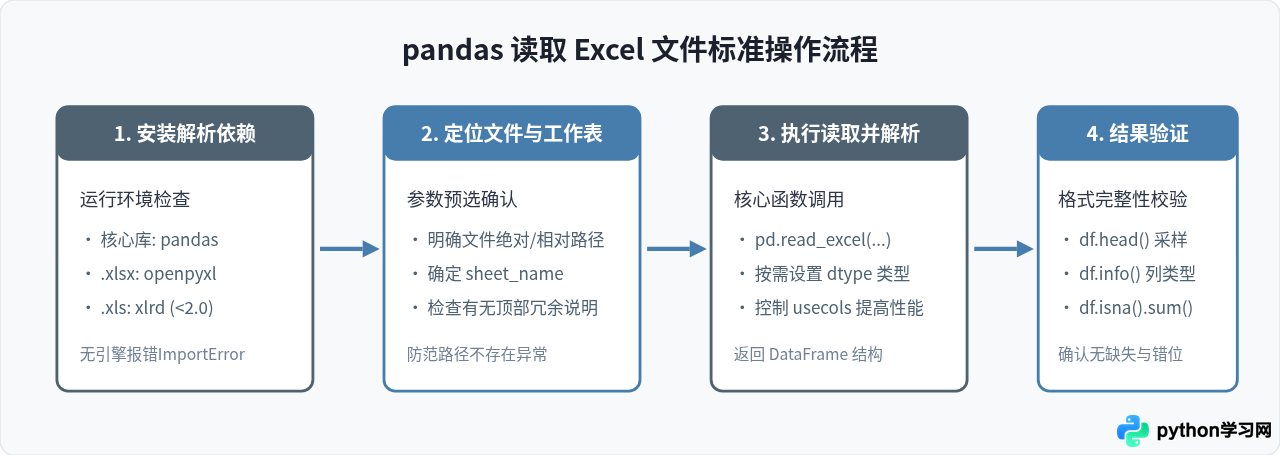
系统讲解使用Python的pandas库读取Excel文件的基础语法、核心依赖与关键参数用法,涵盖多工作表提取、表头指定、列筛选、类型约束与空值处理等实用场景。
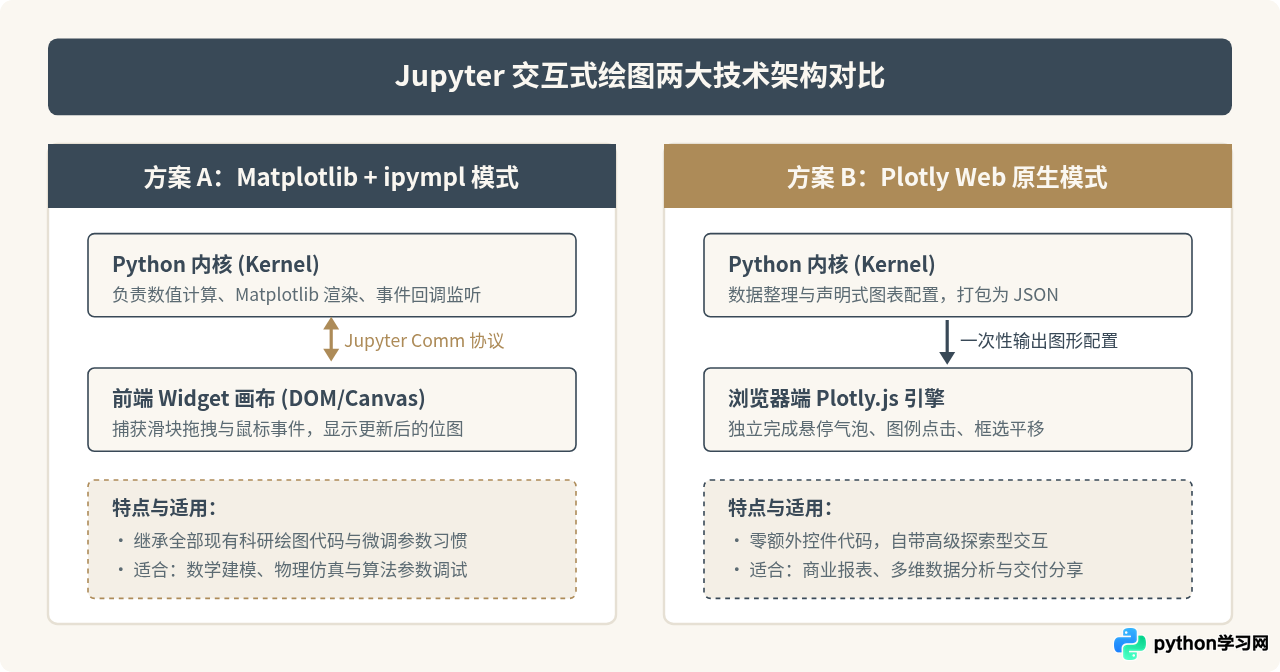
详细介绍在Jupyter Notebook中如何使用Python实现即时交互式绘图。涵盖ipympl窗口式交互与Plotly声明式Web图表两种主流方案的安装配置、代码示例、控件绑定及常见问题排查。
针对Python初学者详细梳理Web后端、数据分析、自动化测试运维与人工智能等应用领域的真实就业门槛,提供清晰客观的方向选择法则与学习路径。