


怎么解读Python t检验和卡方检验输出的p值与统计量
详细讲解在Python中使用scipy.stats进行独立样本t检验和卡方独立性检验时,如何准确解读输出的统计量、p值、自由度与期望频数,并辨析常见统计误区与业务落地决策。
在 Python 中使用 scipy.stats 库执行假设检验时,终端输出的核心结果通常包含两个不可或缺的关键数值:统计量(Statistic)与 p值(p-value)。很多初学者在拿到类似 statistic=2.45, pvalue=0.016 的结果后,往往只草率地比对 p 值是否小于 0.05,却忽略了统计量的正负方向、自由度(df)以及实际效应量。本文将直接拆解独立样本 t 检验与卡方独立性检验的输出结构,讲清每个指标背后的数学含义、几何直觉与实际业务判断步骤,帮助你建立完整而严谨的解读框架。
一、解读 Python 独立样本 t 检验输出
独立样本 t 检验主要用于评估两组相互独立的连续数值型样本的均值是否存在显著差异(例如 A/B 测试中新旧版本的人均使用时长、两组不同工艺生产的零件尺寸)。在 Python 中,最常用的函数是 scipy.stats.ttest_ind。
1. 完整代码调用与输出结构
下面是一个标准的双样本比较示例。在实际场景中,除非有明确证据表明两组方差严格相等,否则强烈建议设置 equal_var=False,以采用更稳健的 Welch t 检验:
import numpy as np
from scipy import stats

# 构造示例数据:对照组与实验组的人均使用时长(分钟)
group_control = [14.2, 15.1, 13.8, 16.0, 14.9, 15.5, 14.3, 13.9, 15.0, 14.7]
group_experiment = [16.8, 17.5, 15.9, 18.2, 16.5, 17.1, 16.9, 17.8, 16.3, 17.4]

# 执行独立样本 t 检验(Welch's t-test)
res = stats.ttest_ind(group_experiment, group_control, equal_var=False)

print(res)
# 终端输出示例:
# TtestResult(statistic=5.4162, pvalue=4.498e-05, df=17.89)
该输出对象 TtestResult 封装了三个关键字段:
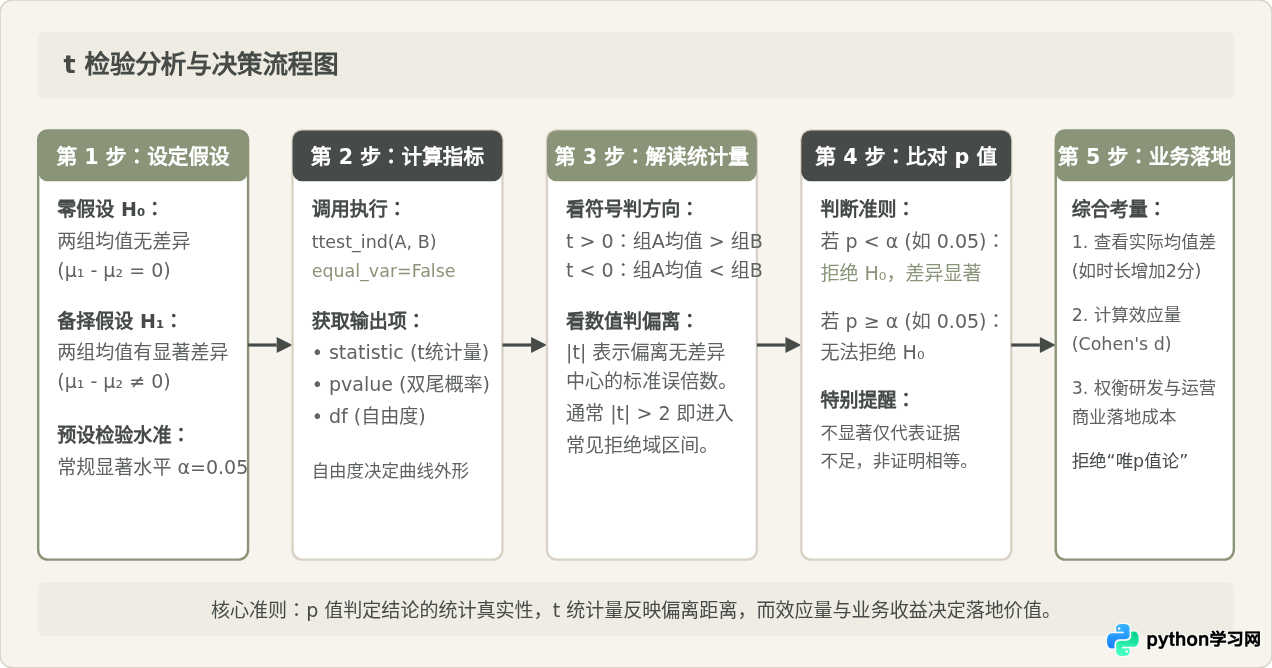
statistic(t 统计量):数值为5.4162。它衡量的是两组样本均值的差异距离“零假设(两组均值无差异)”有多少个标准误的尺度。pvalue(p 值):数值为4.498e-05(即约 0.000045)。它表示在零假设为真的前提下,仅凭抽样随机波动出现当前或更极端差异的概率。df(自由度):数值为17.89。由于采用了方差不齐校正,自由度并非简单的整数加减,它决定了 t 分布曲线的具体胖瘦形态。
2. t 统计量的符号与绝对值含义
很多分析人员容易忽略 t 统计量的符号。t 值的正负完全取决于输入参数的次序(group_a - group_b):
- 符号代表差异方向:若传入顺序为
stats.ttest_ind(A, B),当statistic > 0时,说明组 A 的均值高于组 B;反之若statistic < 0,则组 A 的均值低于组 B。 - 绝对值代表偏离程度:$|t|$ 越大,说明两组均值的分离程度相较于样本内的离散程度越大。当 $|t| = 0$ 时,两组样本均值完全相等。
3. t 统计量与 p 值的几何映射关系
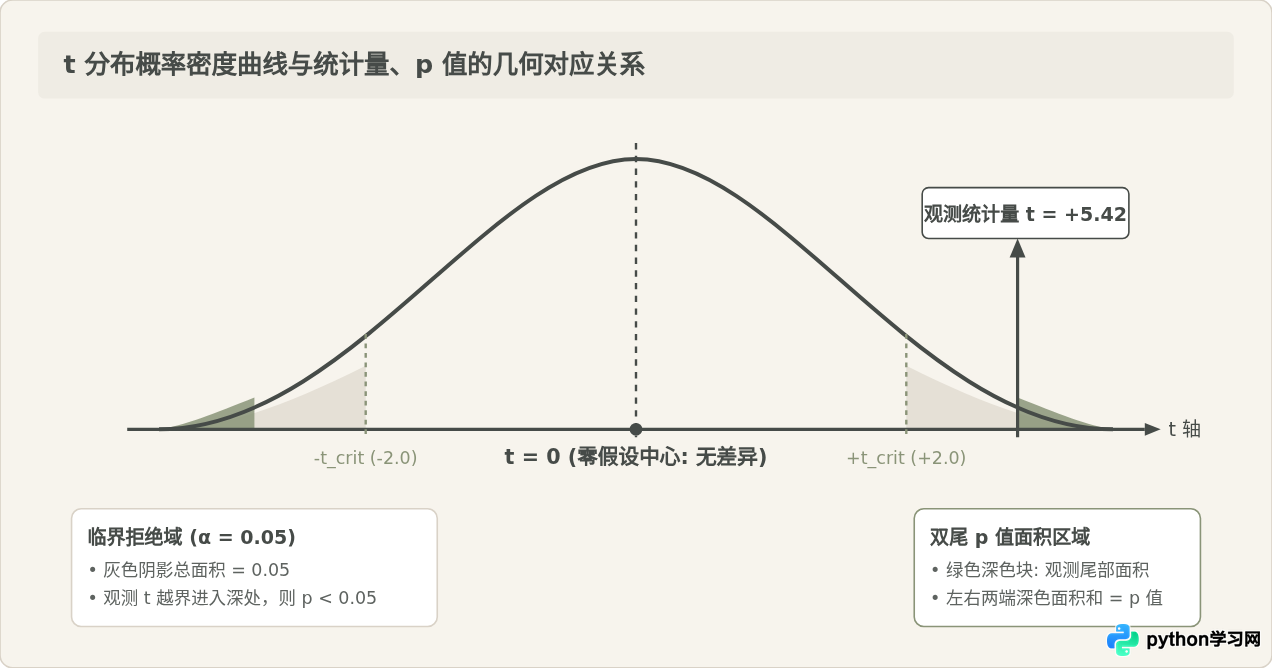
为了直观理解统计量与 p 值的关系,可以将 t 分布视为一条以 0 为对称中心的钟形曲线:
- 原点 0:代表零假设成立时的理论预期(两组无差异)。
- 横坐标刻度:就是 Python 计算出的
statistic。当样本计算出的 t 值为+5.4162时,它位于横轴极右侧深处。 - 双尾阴影面积:就是
pvalue。它等于横轴上从+5.4162往右侧无穷延伸的面积,加上从-5.4162往左侧无穷延伸的面积之和。因为点已经远离中心,两侧尾部极薄,算出来的面积(p 值)自然只有0.000045。
二、解读 Python 卡方检验输出
当我们要分析两个分类变量(Categorical Variables)之间是否存在关联或相对独立时,应采用卡方独立性检验(Chi-Square Test of Independence)。例如评估不同推广渠道(渠道 A vs 渠道 B)的用户转化状态(已转化 vs 未转化)。在 Python 中,核心工具是 scipy.stats.chi2_contingency。
1. 完整代码调用与输出字段拆解
卡方检验的输入数据是一个二维列联表(Contingency Table),表示各分类组合的实际观察频数:
import numpy as np
from scipy import stats

# 构建 2x2 列联表
#                 留存用户    流失用户
# 渠道 A (新渠道)    180        120      (合计 300)
# 渠道 B (旧渠道)    140        160      (合计 300)
# (合计)            320        280      (总计 600)
observed_table = np.array([
    [180, 120],
    [140, 160]
])

# 执行卡方独立性检验
res = stats.chi2_contingency(observed_table)

print(f"卡方统计量 (statistic): {res.statistic:.4f}")
print(f"p值 (pvalue): {res.pvalue:.4e}")
print(f"自由度 (dof): {res.dof}")
print(f"理论期望频数 (expected_freq):\n{res.expected_freq}")

# 终端输出示例:
# 卡方统计量 (statistic): 10.4571
# p值 (pvalue): 1.2218e-03
# 自由度 (dof): 1
# 理论期望频数 (expected_freq):
# [[160. 140.]
#  [160. 140.]]
卡方检验输出了四个独立参数,每个参数的实际业务含义如下:
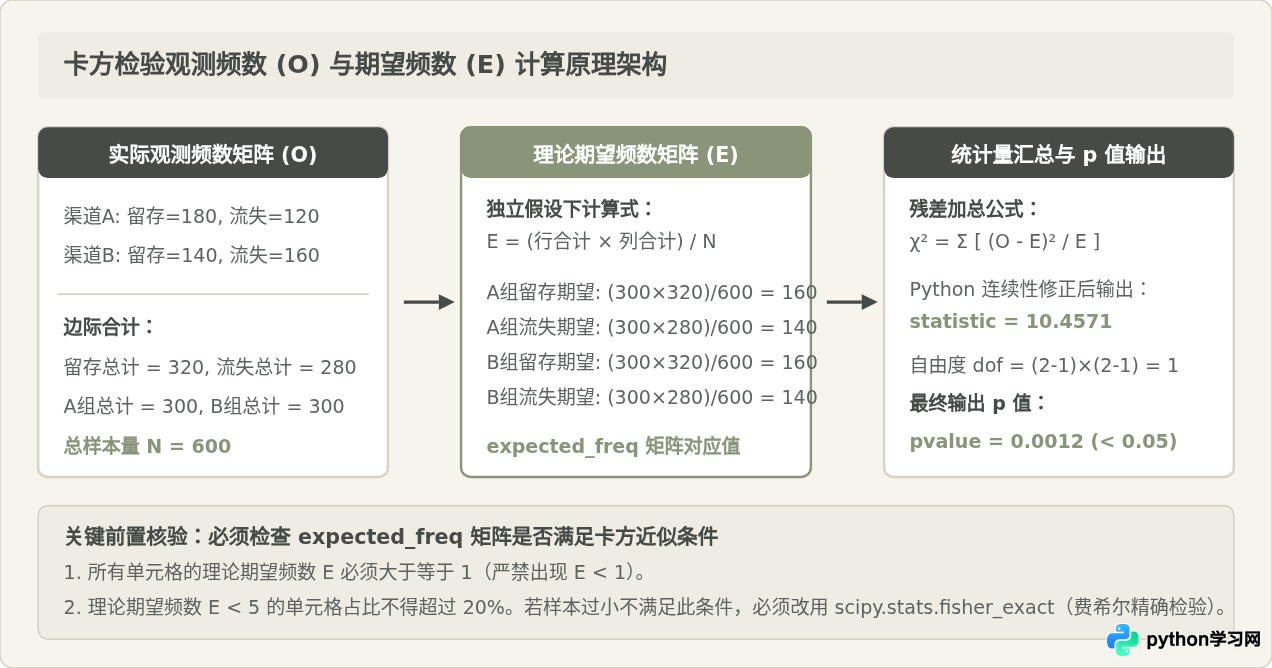
statistic(卡方统计量 $\chi^2$):数值为10.4571。与 t 统计量不同,卡方值由平方累加得到,恒为非负数($\chi^2 \ge 0$)。它衡量的是实际观察频数矩阵 $O$ 与理论期望频数矩阵 $E$ 的综合相对偏差。若两变量完全独立,$O$ 与 $E$ 完全吻合,$\chi^2 = 0$;偏离越剧烈,$\chi^2$ 越大。pvalue(p 值):数值约为0.0012。表示若“渠道与留存完全无关(相互独立)”成立,仅靠随机抽样偶然产生当前这么大频数偏差的概率只有千分之 1.2。因 $p < 0.05$,拒绝独立假设,认为渠道与留存率显著关联。dof(自由度):数值为1。二维列联表的自由度由公式 $dof = (行数 - 1) \times (列数 - 1)$ 确定。对于 $2 \times 2$ 表格,$(2-1)\times(2-1) = 1$。自由度决定了卡方分布的临界值标准。expected_freq(理论期望频数矩阵):如果两个变量完全无关,按照各自边际分布比例推导出来的理想频数分布。例如渠道 A 留存期望频数为 $(300 \times 320) / 600 = 160$。
三、容易混淆的三大常见认知误区辨析
在日常数据分析和算法评估中,围绕 p 值和统计量存在很多流传极广但并不严谨的说法。理解这些说法的合理边界与局限,是正确解读结果的关键。
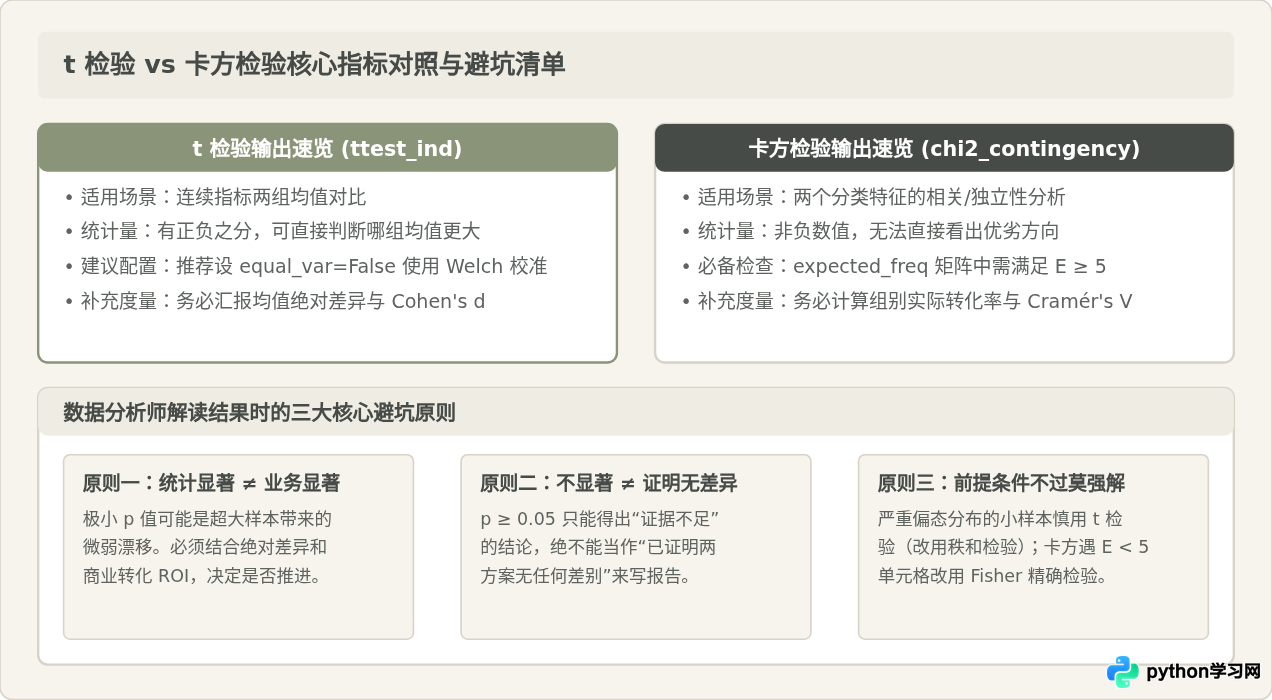
事实辨析:这个说法看似直观,但混淆了“统计显著性”与“实际业务效果”。p 值的本质是对“抽样误差”的度量,它对样本量极其敏感。在百万级用户的大数据场景下,即使两个版本的转化率仅差 0.01%(几乎没有业务价值),计算出的 p 值也可能小于 0.000001。因此,p 值只证明差异是不是偶然产生的,不能证明差异的大小。评估策略效果必须查看均值绝对差或计算效应量(如连续变量的 Cohen's d、分类变量的 Cramér's V)。
事实辨析:这是典型的“接受原假设”误区。在统计学逻辑中,假设检验采用反证法:$p \ge 0.05$ 的准确结论是“在当前样本量和数据波动下,没有足够的证据拒绝零假设”。这很可能是因为样本量太小(检验效能不足)导致微小差异未被捕捉,绝不代表原假设被证实为真。不能把“未发现差异”直接写成“已证明无差别”。
事实辨析:卡方统计量是由 $(O-E)^2/E$ 累加而成,数值恒为正数,完全不包含方向信息。若想知道渠道 A 和渠道 B 究竟哪一个留存率更高,不能只盯住 chi2_contingency 的统计量,必须回头直接计算各自的样本比率(例如渠道 A 留存率 $180/300 = 60\%$,渠道 B 留存率 $140/300 = 46.7\%$)。
四、两类检验核心指标与避坑速查表
为了便于在实际开发与分析中快速对照,下表与总结图汇总了 t 检验与卡方检验的核心指标对比与实操避坑建议:
| 比较维度 | 独立样本 t 检验 (ttest_ind) | 卡方独立性检验 (chi2_contingency) |
|---|---|---|
| 输入数据特征 | 自变量为 2 个离散组别,因变量为连续数值型数据 | 两个变量均为离散分类变量(二维交叉列联表) |
| 统计量名称与符号 | statistic (t 值),可正可负,符号直接反映高低方向 |
statistic (卡方值 $\chi^2$),恒为非负数,无方向性 |
| 统计量物理含义 | 组间均值差是组内标准误差的多少倍 | 观测频数偏离独立理论期望频数的加权平方偏差总和 |
| 自由度 (df / dof) | 由样本量与方差齐性决定,定义 t 分布曲线胖瘦 | $(行数 - 1) \times (列数 - 1)$,定义卡方分布形态 |
| p 值的判断准则 | $p < 0.05$ 拒绝无差异假设;$p \ge 0.05$ 证据不足以拒绝 | $p < 0.05$ 拒绝独立假设(关联显著);$p \ge 0.05$ 证据不足 |
| 必须配套报告的指标 | 两组样本量、样本均值差、置信区间、Cohen's d 效应量 | 各组实际比例、期望频数表 (expected_freq)、Cramér's V |
五、结语与完整解读步骤总结
解读 Python 输出的假设检验结果,推荐遵循以下标准化步骤:
- 确认检验方法与参数设置:检查自变量与因变量类型是否匹配,确认 t 检验是否配置了 Welch 校正(
equal_var=False),核查卡方检验的expected_freq是否满足期望频数要求。 - 依据 p 值判断统计显著性:将
pvalue与预设的阈值 $\alpha$(通常为 0.05)比对。若 $p < \alpha$,拒绝原假设;若 $p \ge \alpha$,判定为证据不足,不可轻易妄断两组完全相等。 - 依据统计量明晰偏离与方向:通过 t 统计量的正负号判断均值高低方向,通过卡方统计量的大小感知与独立假设的偏离幅度。
- 结合业务实际评估效应量:脱离业务场景与样本量的“唯 p 值论”无法指导实际生产。计算具体的均值增减绝对值、转化率百分比差距与效应量指标,最终输出具备商业解释力和统计信度的决策建议。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















