


PyTorch还是TensorFlow?Python神经网络开发框架选择对比
深入对比PyTorch与TensorFlow在计算图范式、API设计哲学、模型训练调试、工业部署生态及社区支持等层面的核心差异,提供清晰可落地的选型决策指南。
一、计算图范式与执行机制的底层差异
在决定使用哪个框架之前,必须理解两者在处理“计算图”这一核心概念时的根本分歧。深度学习模型的本质是有向无环图(DAG),但在构建图的时间点和执行方式上,两者选择了不同的路径。
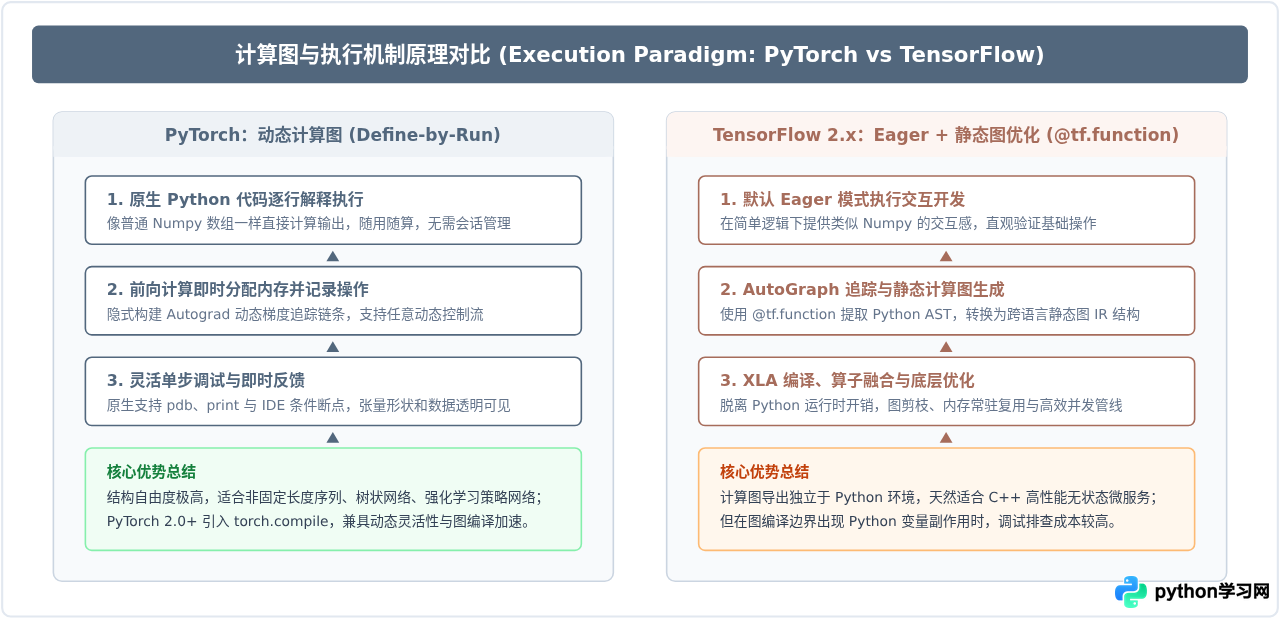
PyTorch 诞生之初就确立了“运行即定义”(Define-by-Run)的动态图哲学。每一行代码在前向传播时被实时解释执行,同时在内存中动态构建梯度回溯路径。开发者可以直接使用 Python 的标准 if 分支、for 循环和原生数据结构,甚至可以随时插入 print() 或直接调用 pdb.set_trace() 进行断点单步调试。这种体验与编写常规 Python 程序毫无二致。
与之相对,早期的 TensorFlow 1.x 采用严格的“先定义后运行”(Define-and-Run)静态图机制。虽然在 TensorFlow 2.x 中引入了默认的 Eager Execution(即时执行),大幅改善了交互体验,但其高性能生产与图优化的核心机制仍依赖于 @tf.function。该装饰器通过 AutoGraph 静态分析 Python 语法,将其追踪编译为低级计算图并交给底层 C++ 引擎运行。这使得 TensorFlow 在多分支控制流和即时调试时,仍然需要处理 Eager 模式与静态图追踪之间的上下文差异。
二、API 风格与模型开发全流程对比
在日常代码编写中,两个框架的设计语言体现了不同的工程审美:PyTorch 强调“控制权的显式交给开发者”,而 TensorFlow(以 Keras 为核心)则倾向于“高抽象封装与开箱即用”。
1. 模型构建方式
PyTorch 几乎全部遵循继承 torch.nn.Module 的方式,显式声明网络层并在 forward 方法中编写数据流。逻辑透明,没有任何隐式规则:
import torch
import torch.nn as nn

class MLPClassifier(nn.Module):
    def __init__(self, in_features, hidden_dim, out_classes):
        super().__init__()
        self.fc1 = nn.Linear(in_features, hidden_dim)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_dim, out_classes)

    def forward(self, x):
        # 自由插入 print(x.shape) 进行检查
        x = self.relu(self.fc1(x))
        return self.fc2(x)
TensorFlow 在 2.x 时代将 Keras 作为首选高层 API,提供了三种构建方式:Sequential 线性堆叠、Functional API 函数式连接、以及 Subclassing(类子类化)。对于标准的前馈结构,函数式 API 可以在几行内搞定输入输出绑定:
import tensorflow as tf
from tensorflow.keras import layers, Model

inputs = layers.Input(shape=(32,))
x = layers.Dense(64, activation='relu')(inputs)
outputs = layers.Dense(10)(x)
model = Model(inputs=inputs, outputs=outputs)
2. 训练循环控制
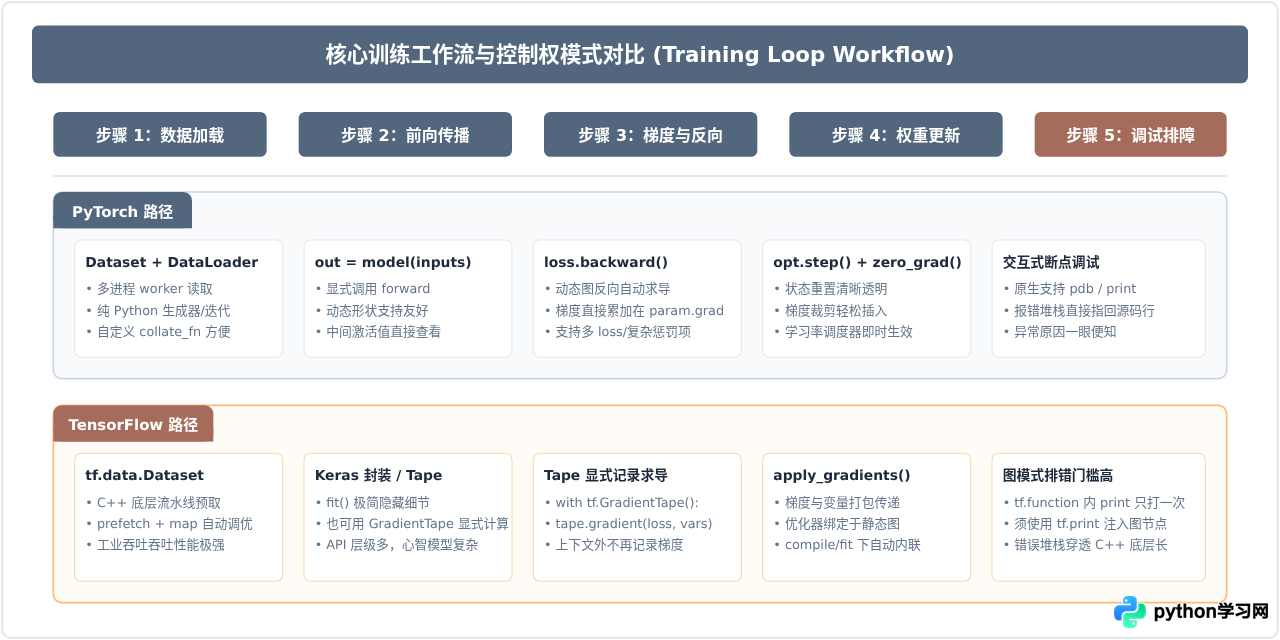
训练循环最能体现两个框架的风格差异。PyTorch 强制开发者显式管理每一步状态转换:清空历史梯度、前向传播、计算损失、反向求导、更新参数。这一套经典的五部曲让新手对深度学习的数值迭代机制有极其深刻的掌控感。
TensorFlow 则提供了两条路径:如果你追求极简,使用 model.compile() 和 model.fit(),内置了早停、学习率衰减、TensorBoard 监控等工业级回调函数;如果你需要像 PyTorch 一样精细控制,可以使用 tf.GradientTape 手动监听变量求导。
三、生产部署与工程落地的生态决战
很多初学者在入门阶段只关注训练代码怎么写,但在企业商业化场景中,“模型能不能稳定、低延迟地部署到目标环境”才是决定框架生死存亡的关键标准。正是在这里,TensorFlow 展现了其耕耘多年的工业化护城河。
1. TensorFlow 的工业闭环
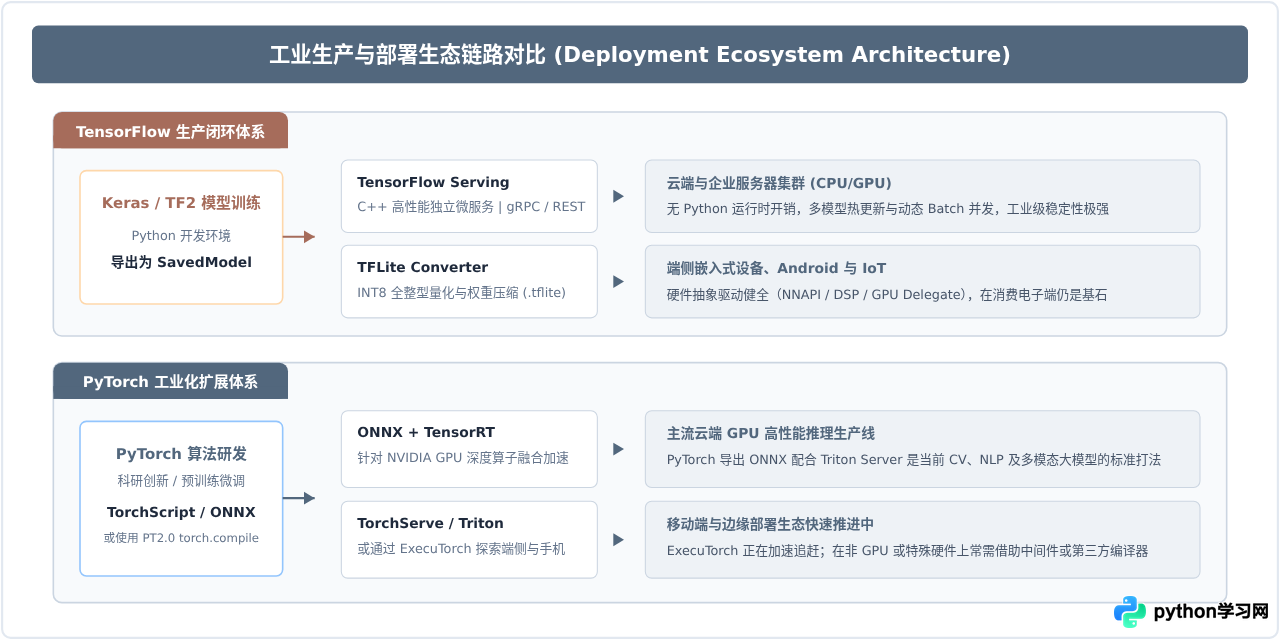
TensorFlow 在设计之初就是为了 Google 的大规模工业搜索、推荐和移动系统服务的。它的模型导出产物是 SavedModel 目录结构,内部包含了完整的网络拓扑结构(Protocol Buffers)、变量权重和计算签名(SignatureDef)。这意味着:
- 完全脱离 Python 环境:在服务器端,可以直接通过 C++ 编写的 TensorFlow Serving 加载运行,通过 gRPC 或 REST 协议对外提供毫秒级微服务,享受极高的 QPS 和并发批处理优化。
- 移动与边缘端的压倒性优势:TensorFlow Lite (TFLite) 是业界最成熟的端侧推理引擎之一。它对量化(8位整型 INT8 / Float16)、芯片硬件抽象层(NNAPI、GPU Delegate、Hexagon DSP)的支持极其完善,安装包体积轻量到几百 KB,至今仍是海量 Android 设备与 IoT 芯片的首选。
- Web 前端:TensorFlow.js 允许模型直接在浏览器或 Node.js 环境中基于 WebGL / WebGPU 运行,为纯前端 AI 交互提供了极高完成度的工具链。
2. PyTorch 的工业化追赶与演进
PyTorch 曾长期被批评为“研究利器、部署难题”。为了打破这一困局,社区和 Meta 投入了巨大精力构建落地管道:
- 中间格式标准:PyTorch 对 ONNX (Open Neural Network Exchange) 提供了原生的一流支持。在大多数工业级 GPU 推理场景中,标准做法是将 PyTorch 模型导出为 ONNX,再交由 NVIDIA TensorRT 进行层融合与量化加速,最后通过 Triton Inference Server 托管。这套方案已经成为现代工业界处理高负载 GPU 推理的主流选择。
- 移动端演进:从早期的 PyTorch Mobile 到现代专门针对嵌入式与边缘设备的 ExecuTorch,PyTorch 正在快速补齐微控制器与移动终端的拼图,但客观来说,其在长尾低功耗芯片生态上的成熟度较 TFLite 仍有一定追赶空间。
四、社区格局、大模型生态与全方位能力矩阵
如果说 2016-2018 年是两大阵营旗鼓相当的拉锯期,那么从 2020 年至今,学术界与前沿开源社区的天平已经发生了不可逆转的倾斜。
统计主流国际顶级 AI 会议(CVPR、ICCV、NeurIPS、ICLR、ACL 等)可以发现,超过 80% 甚至 90% 的录用论文开源代码均基于 PyTorch 实现。前沿研究人员需要极快地尝试奇思妙想、随时魔改注意力机制、拆解并重构张量运算,PyTorch 纯粹的 Pythonic 体验让它成为了事实上的“学术通用语言”。
更关键的转折点在大语言模型(LLM)与生成式 AI 时代:无论是 Hugging Face 的 transformers、diffusers,还是用于大模型分布式训练与推理的 DeepSpeed、Megatron-LM、vLLM,几乎全是以 PyTorch 作为首发或唯一核心底层。如果你想第一时间运行最新的开源大模型权重(如 Llama 系列、Mistral 等),PyTorch 是唯一的顺畅选择。
| 对比维度 | PyTorch | TensorFlow (2.x / Keras) |
|---|---|---|
| 核心执行范式 | 原生动态图(Define-by-Run),直观透明 | Eager 交互 + @tf.function 静态追踪优化 |
| 调试与排错体验 | 极佳。支持原生 pdb、print,报错直指代码行 | 中等。静态图模式下穿透底层 C++ 堆栈较深 |
| 学术界与前沿论文 | 压倒性统治地位(90%+ 顶会论文首发代码) | 份额较低,学术研究复现较少 |
| 开源大模型与 LLM 生态 | 绝对主流(HuggingFace、vLLM、DeepSpeed) | 生态支持滞后,第三方社区适配成本高 |
| 端侧与移动端推理 (TFLite) | ExecuTorch 发展中,依赖 ONNX/第三方引擎 | 极度成熟,轻量且硬件抽象层极其健全 |
| C++ 无 Python 服务集群 | 需转 TorchScript/ONNX 接入 Triton 服务 | TensorFlow Serving 原生全链路无缝支撑 |
| 学习曲线 | 符合 Python 直觉,低心智负担,利于理解原理 | Keras 入门容易,但深入图编译机制后心智负担上升 |
五、清晰可行的选型决策指南
面对具体项目的技术选型,不需要非黑即白的站队思维。结合团队的人员构成、目标交付环境和业务生命周期,可以通过以下决策导图迅速定位合适的技术栈:
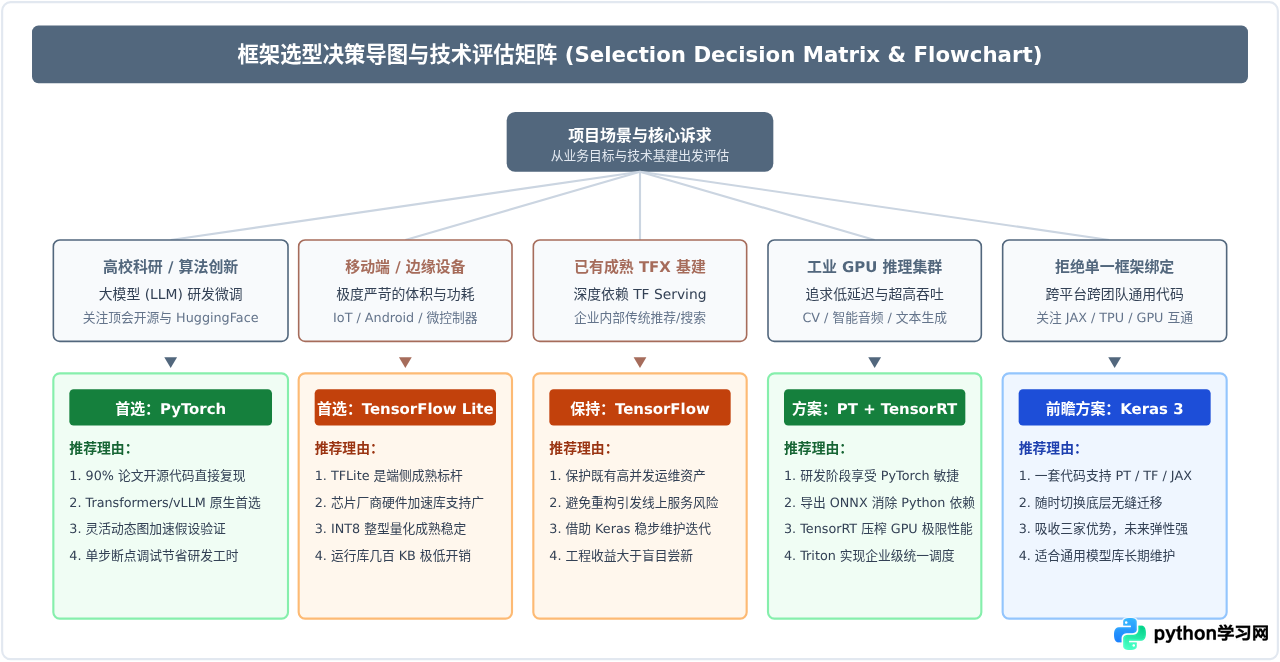
六、开发者常见误区与平滑演进建议
误区 1:“TensorFlow 已经彻底被淘汰了?” 事实并非如此。在消费电子、工业质检、医疗设备边缘盒子等领域,TFLite 仍然拥有庞大的装机量。同时,很多大型互联网公司的广告点击率(CTR)预估系统依然建立在高度定制的 TensorFlow 分布式参数服务器(PS)之上,重构成本极大。盲目推翻既有稳定架构往往并不明智。
误区 2:“PyTorch 只能做实验,上不了生产?” 这已经是过时的老观念。随着 ONNX Runtime、NVIDIA TensorRT 以及 PyTorch 2.0 引入的 torch.compile,PyTorch 已经打通了从科研到万亿级参数工业推理的完整链路。现在的业界主流模式正是“PyTorch 负责敏捷研发创新,ONNX/TensorRT 负责底层压测交付”。
如果你是一名刚刚踏入深度学习领域的初学者,或者正在规划一个全新的算法项目,直接从 PyTorch 起步是目前阻力最小、收获最直接的路线。它不仅能帮助你更直观地理解反向传播、张量流转和梯度下降的真实物理过程,也能让你无缝衔接当下繁荣的 Hugging Face 与开源大模型生态。
而当你未来面临移动端轻量级推理、或进入一家拥有深厚 TensorFlow 资产积累的企业时,掌握其核心的 Eager 模式与计算图转换逻辑,依然能让你在工程落地中游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















