


Python集合(set)是什么:无序且唯一的元素容器
深入解析Python内置集合(set)的核心特征与运作原理,讲解无序性、唯一性、底层哈希机制、常用操作及数学集合运算,提供实用的代码示例与避坑指南。
在 Python 编程中,集合(set)是一种内置的基础数据容器。与保留插入顺序且允许重复的列表(list)不同,集合的核心定义是“无序且元素唯一”。简而言之,集合内的所有元素绝不会出现重复,并且元素之间不存在前后的物理次序。本文将从集合的本质特性、底层哈希原理、标准操作流程、核心代数运算以及常见使用边界五个维度,系统拆解这一关键容器。
一、认识集合:无序与唯一的具体表现
要理解集合,最直观的方式是观察它的初始化和输出结果。在 Python 中,集合使用一对花括号 { } 包裹元素,或者通过内置工厂函数 set() 转换可迭代对象创建。
# 示例 1:自动去重特性
raw_data = [1, 2, 2, 3, 3, 3, 4]
unique_set = set(raw_data)
print(unique_set)
# 示例输出:{1, 2, 3, 4}

# 示例 2:无序性表现
char_set = {'p', 'y', 't', 'h', 'o', 'n'}
print(char_set)
# 示例输出可能是 {'y', 'o', 'h', 'p', 'n', 't'},无法依赖其先后位置
从上面的示例可以得出两个关键结论:
- 唯一性(Uniqueness):传入包含三个
3和两个2的列表时,生成的集合只保留单一副本,多余的重复值会被静默过滤。 - 无序性(Unorderedness):打印集合时,元素的排列顺序既不反映写入顺序,也不保证升序或降序排列,每次环境变动或哈希种子变化都可能导致元素展示顺序不同。因此,集合不支持任何索引访问与切片操作,编写
unique_set[0]将直接触发TypeError: 'set' object is not subscriptable。
二、为什么无序且唯一:底层哈希表机制与可哈希要求
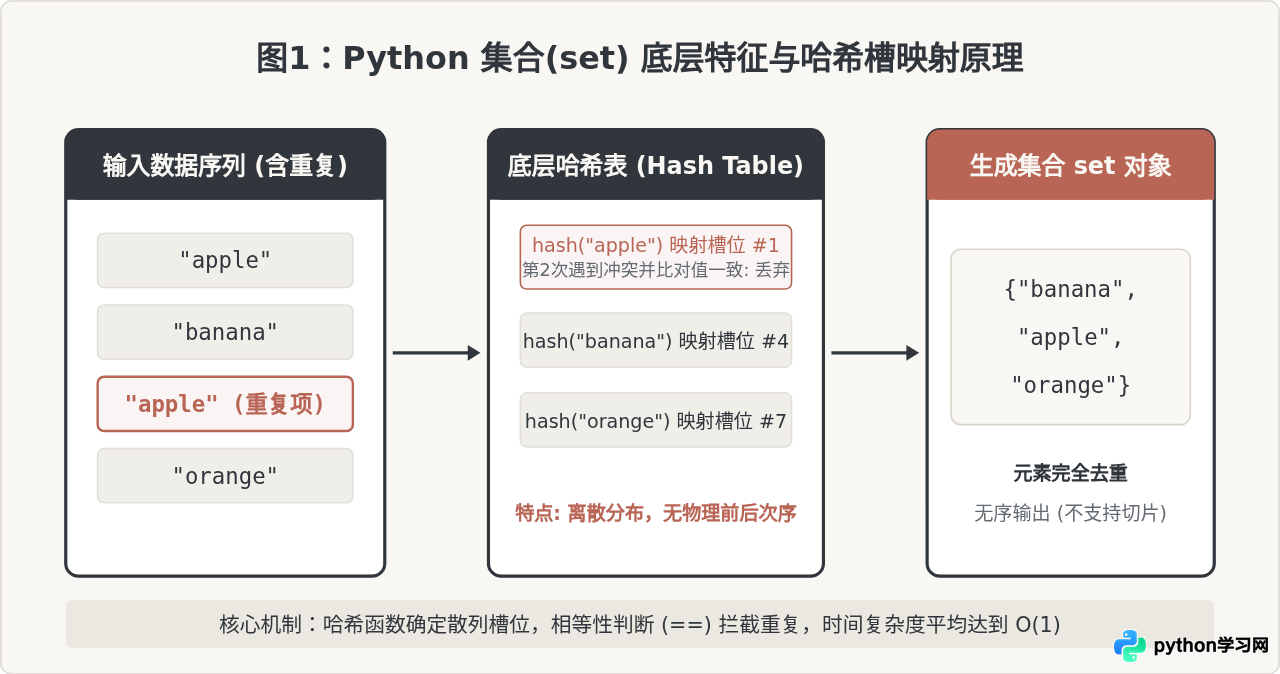
集合之所以具备无序和唯一的特性,根本原因在于其底层实现与字典(dict)的键完全一致,均基于散列表(Hash Table)结构。
当向集合添加一个元素时,Python 运行时会执行以下三步逻辑:
- 计算哈希值:调用内置函数
hash(item)获取该对象的哈希整数。 - 定位哈希槽:将哈希值映射为内存表中的槽位索引。由于哈希函数的散列特性,不同的数据会被随机分散在不同的物理槽位中,这直接决定了集合的“无序性”。
- 判重拦截:如果目标槽位已有数据,Python 会进一步使用
==判断两对象是否相等。如果相等,则认定元素已存在,放弃写入;若不相等,则按冲突解决机制寻址新槽位。这直接保障了集合的“唯一性”。
只有不可变类型(如
int、float、str、tuple、frozenset)才拥有固定的哈希值。诸如 list、dict 以及 set 本身等可变对象均不可哈希,若尝试将其作为集合元素,将立即引发 TypeError: unhashable type: 'list'。
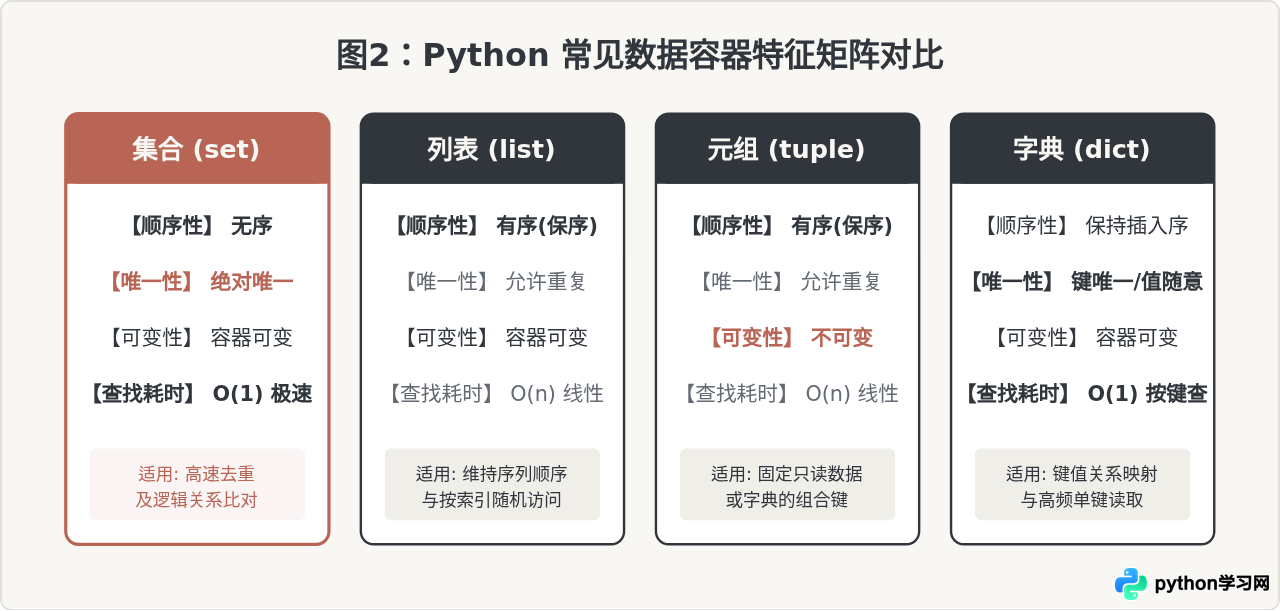
为了明确集合与其他内置容器的差异,我们可以通过下表建立清晰的对比认知:
| 容器类型 | 是否有序 | 允许重复 | 可变性 | 成员检查时间复杂度 | 核心设计用途 |
|---|---|---|---|---|---|
| set (集合) | 无序 | 否 (强制唯一) | 可变 (元素须可哈希) | O(1) | 去重、成员判定、集合代数运算 |
| list (列表) | 有序 | 是 | 可变 | O(n) | 保持顺序存储、随机索引访问 |
| tuple (元组) | 有序 | 是 | 不可变 | O(n) | 不可变数据传递、字典键 |
| dict (字典) | 键有序 (3.7+) | 键唯一 / 值可重复 | 可变 | O(1) (通过键) | 映射关联、快速键值查询 |
三、集合的标准操作与元素管理工作流
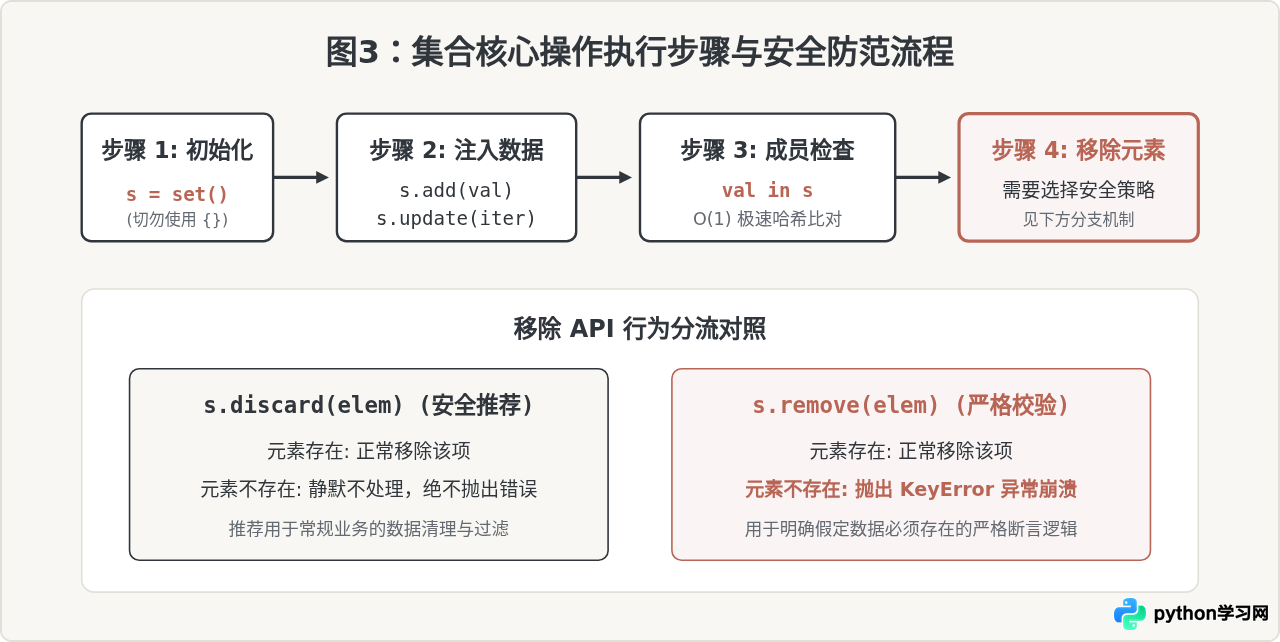
在日常开发中,对集合的管理通常包含创建、添加、判定、安全删除和遍历五个基础步骤。
1. 正确创建集合(避开空集合陷阱)
创建非空集合可以直接使用字面量语法 {1, 2, 3}。但如果需要创建一个空集合,必须使用 set(),而绝对不能使用 {}。因为在 Python 的语法规则中,{} 默认表示空字典(dict)。
empty_dict = {}
print(type(empty_dict))  # 示例输出: <class 'dict'>

empty_set = set()
print(type(empty_set))   # 示例输出: <class 'set'>
2. 元素的添加与更新
add(elem):向集合追加单个元素。如果元素已存在,操作不产生任何副作用。update(iterable):批量合并可迭代对象(如列表、元组或其它集合)中的元素。
3. 元素的删除与安全防护
remove(elem):移除指定元素。注意:若元素不存在,会直接抛出KeyError异常。discard(elem):安全移除指定元素。若元素不存在,静默忽略而不报错。在不确定元素是否在集合中时,推荐优先使用discard。pop():随机弹出一个元素并将其返回。若集合为空,则抛出KeyError。
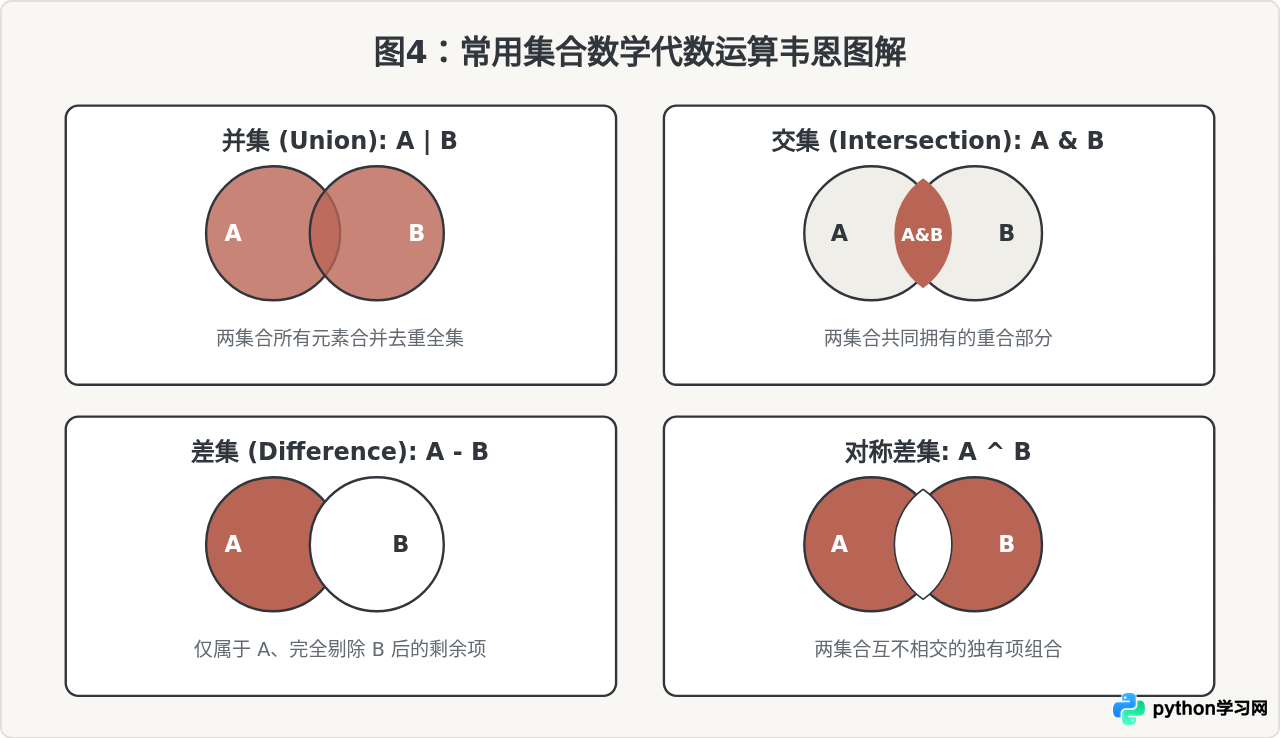
四、数学集合代数运算:交、并、差与对称差
除了简单的数据去重,集合最强大的能力在于原生支持数学上的集合代数运算。在处理权限对比、标签交集、离线数据差量计算时,利用集合运算可以用单行代码代替复杂繁琐的多重嵌套循环。
set_a = {1, 2, 3, 4}
set_b = {3, 4, 5, 6}

# 1. 并集 (Union):两集合全部去重元素
print(set_a | set_b)           # {1, 2, 3, 4, 5, 6}
print(set_a.union(set_b))

# 2. 交集 (Intersection):两集合共同拥有的元素
print(set_a & set_b)           # {3, 4}
print(set_a.intersection(set_b))

# 3. 差集 (Difference):属于 A 但不属于 B 的元素
print(set_a - set_b)           # {1, 2}
print(set_a.difference(set_b))

# 4. 对称差集 (Symmetric Difference):非公共元素 (A独有 + B独有)
print(set_a ^ set_b)           # {1, 2, 5, 6}
print(set_a.symmetric_difference(set_b))使用运算符(如
&、|、-)时,两边操作数必须都是集合类型;而使用方法调用(如 set_a.intersection(data))时,参数可以是列表、元组等任意可迭代对象,方法会在内部自动完成适配。
五、不可变集合与高频使用边界
在掌握集合的基本功能后,有两处工程实践中的关键考量需要注意:
1. 不可变集合 frozenset 的使用场景
标准 set 是可变的,因此它本身不可哈希,无法作为字典的键,也无法作为其他集合的元素。如果业务上确实需要将集合作为字典键(例如图论中的无序顶点对),可以使用内置的 frozenset:
# 创建不可变集合
frozen_key = frozenset([1, 2, 3])

# 可以安全地作为字典键
lookup_table = {frozen_key: "group_alpha"}
print(lookup_table[frozen_key])  # 示例输出: group_alpha
2. 性能考量:何时应该把列表转为集合?
如果程序需要频繁执行 if item in container: 进行成员包含性检测,将拥有成千上万个元素的 list 预先转为 set 会带来数百甚至数千倍的性能飞跃。列表的成员查询需要逐个遍历(时间复杂度 $O(n)$),而集合的哈希查询在平均情况下只需单次计算即可定位(时间复杂度 $O(1)$)。
结语
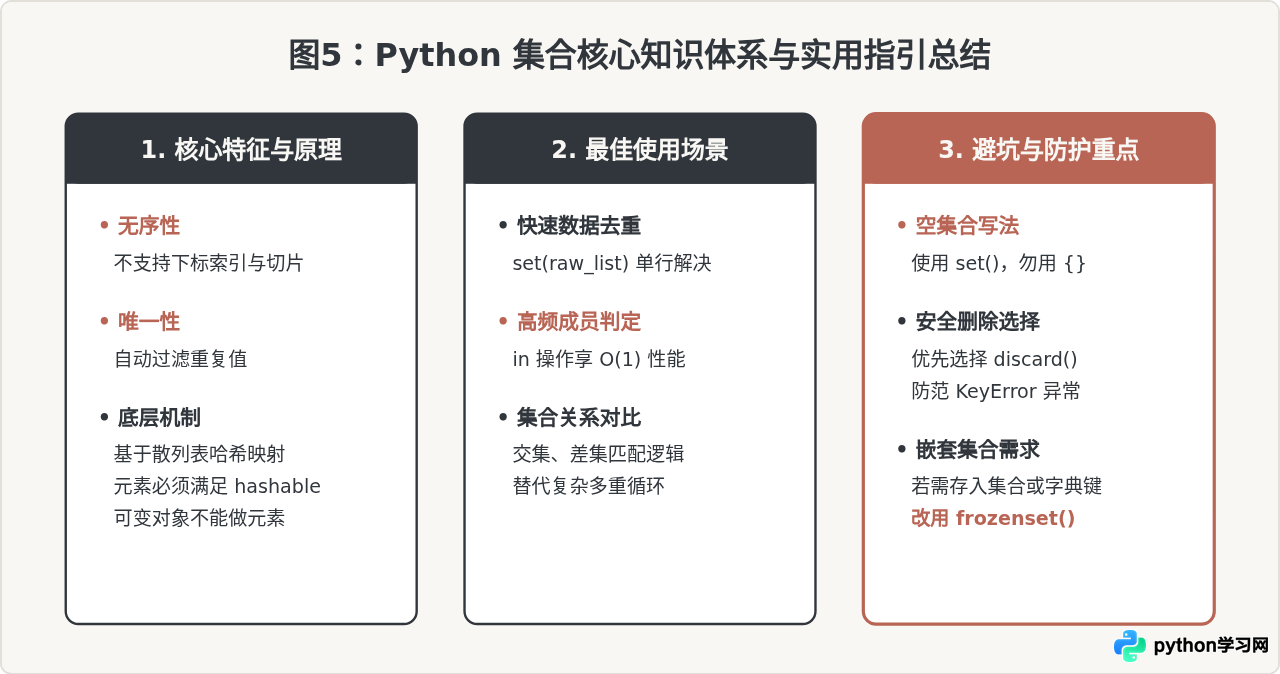
Python 集合(set)以其“无序且唯一”的特性,精准地解决了序列去重与高频成员检查的核心痛点。理解其基于哈希表的运作机制,不仅能帮助开发者编写出性能更优的代码,还能避免诸如把不可哈希对象塞入集合或误用空花括号等典型错误。在面对涉及关系比对、标签交集或去重任务时,合理利用集合及其代数运算,是编写优雅 Pythonic 代码的重要实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















