Python Gensim Word2Vec 中文语料处理实战:从分词到模型训练
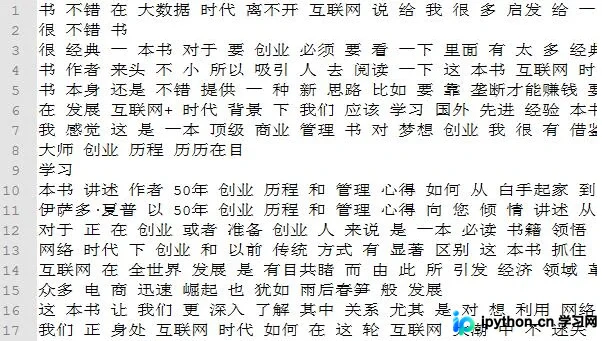
本文详解如何利用Python Gensim库中的Word2Vec模型处理中文语料。内容涵盖语料收集、中文分词工具选择(如结巴、LTP)、模型训练参数设置及相似度计算。通过亚马逊书评数据示例,展示如何计算词语关联度、查找相关词及识别异常词,并提供完整的代码实现与结果分析。
10-13
6




本文详解如何利用Python Gensim库中的Word2Vec模型处理中文语料。内容涵盖语料收集、中文分词工具选择(如结巴、LTP)、模型训练参数设置及相似度计算。通过亚马逊书评数据示例,展示如何计算词语关联度、查找相关词及识别异常词,并提供完整的代码实现与结果分析。
本文介绍Python中过滤字母、数字及特殊符号的多种实现方式,涵盖filter内置方法、正则表达式re模块及isnumeric等字符串处理技巧,适用于中文分词前的数据清洗场景。
本文详解如何利用Python的aiml库搭建基于AIML协议的聊天机器人。内容涵盖库安装、语料库加载、自定义AIML文件编写、会话管理与断言机制,以及Brain加速加载技巧。针对中文AI应用难点,分析了规则库匮乏与分词问题,并提供了jieba分词及开源项目等解决方案,帮助开发者快速构建智能对话系统。
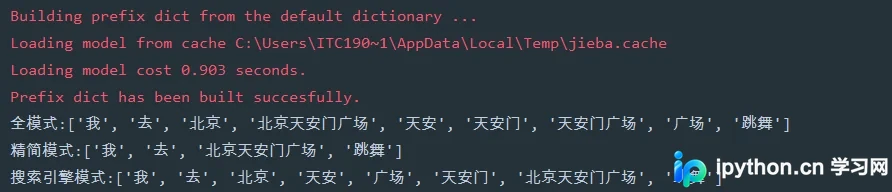
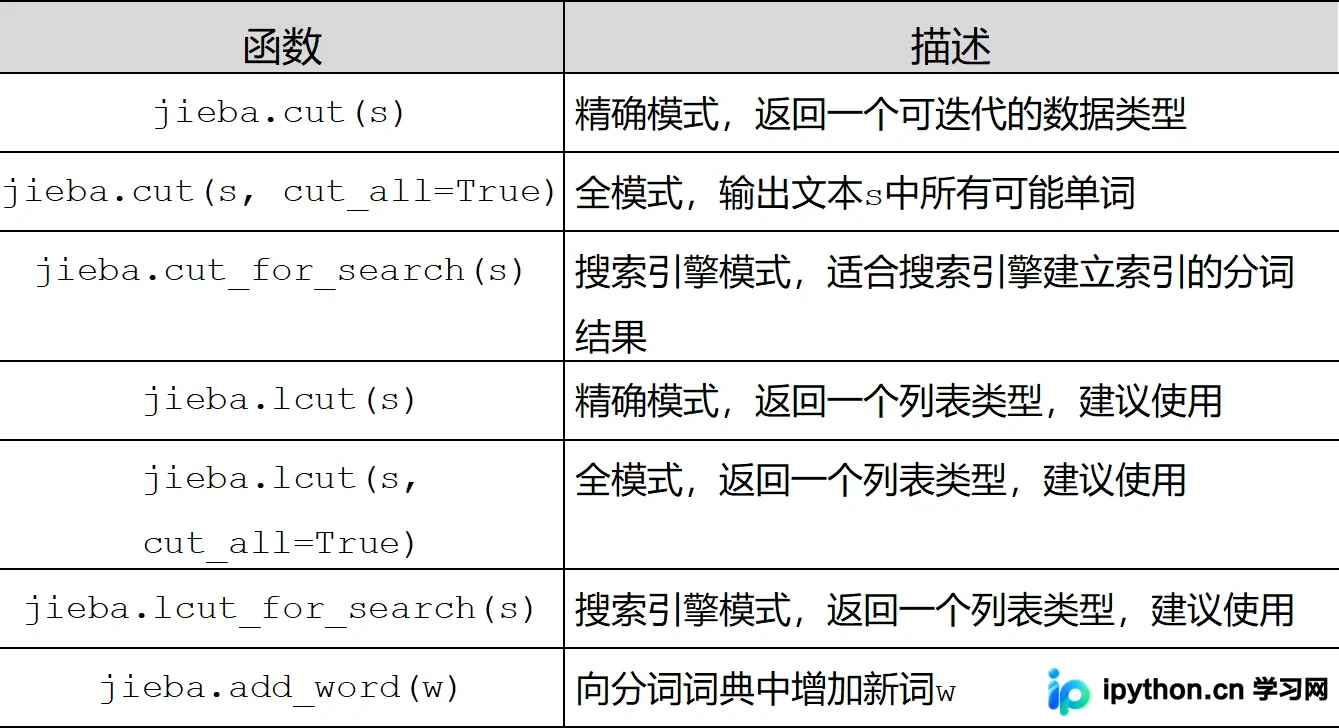
本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。
本文深入解析Python jieba库的三种分词模式(全模式、精简模式、搜索引擎模式),详解如何添加自定义词典以控制词语切分,并探讨基于隐马尔可夫模型(HMM)和Viterbi算法处理未登录词的底层原理。通过代码示例展示jieba在实际应用中的灵活配置与参数调整方法。
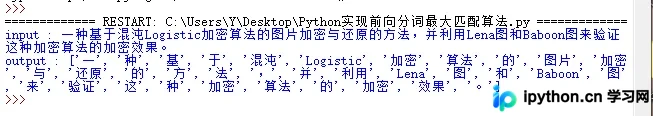
本文详细介绍基于词表的中文分词方法,重点讲解前向最大匹配算法的原理与Python实现。通过定义最大词长、递归匹配字典及主循环处理,演示如何对包含英文、数字及特定术语的中文句子进行有效分词,并提供完整代码供参考。
本文详细介绍Python中优秀的中文分词第三方库jieba。解析其基于中文词库的分词原理,对比精确模式、全模式和搜索引擎模式三种分词方式的区别。通过统计《三国演义》人物出场次数的完整代码示例,展示jieba在实际文本处理中的应用,帮助开发者掌握分词技巧与数据处理流程。
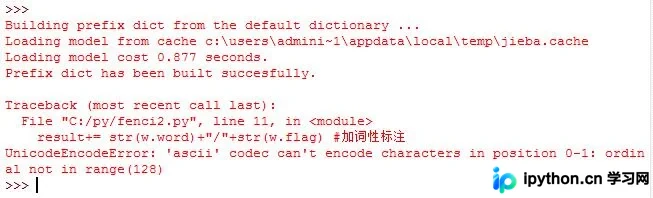
本文详细介绍Python中使用结巴分词库进行中文文本分词及词性标注的完整流程。通过读取文本文件、调用pseg.cut进行分词,并将结果保存至新文件。针对Python 2.7环境下常见的编码报错问题,提供了添加sys.setdefaultencoding("utf-8")的解决方案,附带完整代码示例及运行结果分析,帮助开发者快速掌握该工具的实际应用。
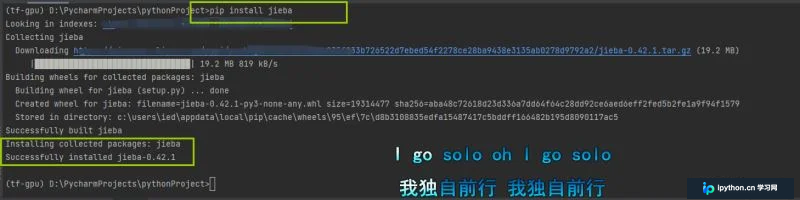
本文详细解析Python jieba模块的安装配置与核心用法,涵盖精确/全/搜索引擎三种分词模式、自定义词典加载、TF-IDF与TextRank关键词抽取、词性标注及词位置获取等实战操作。提供完整代码示例与性能对比,指导开发者针对NLP场景优化文本处理流程。
SnowNLP 是一款专注于中文文本处理的 Python 第三方库,提供分词、词性标注、情感评分、繁简转换、关键词抽取与自动摘要等功能。本文详解安装流程与核心 API 调用方法,附带完整代码与结果对照,助力快速搭建基础文本分析管线。
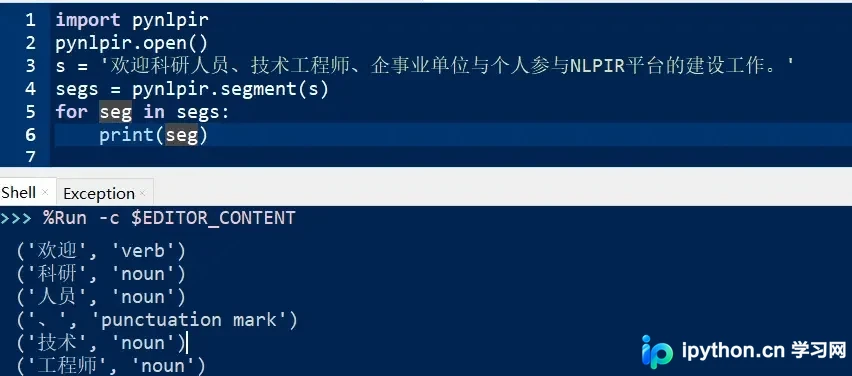
本文介绍如何在Python环境中安装与配置pynlpir模块,演示基础单句分词及按行读取、标注后批量处理本地TXT文件的完整流程。通过参数调整保留原始段落换行结构,导出含词性信息的分析结果,并补充自定义词典导入、跨平台路径处理等高频注意事项。
本文详解Python jieba库的中文分词原理,介绍基于词库与动态规划的算法机制。重点解析精确模式、全模式及搜索引擎模式的区别与适用场景,并通过jieba.lcut等常用函数展示代码实操,涵盖安装、自定义新词及不同模式下的分词效果对比。