Python大规模字符串模糊匹配的性能优化策略
针对Python在处理数十万至数千万级文本时字符串模糊匹配计算耗时过长的问题,系统解析从底层C扩展加速、多级漏斗过滤、N-gram稀疏矩阵索引到局部敏感哈希(MinHash LSH)的完整性能调优与工程落地策略。
10-23
34




针对Python在处理数十万至数千万级文本时字符串模糊匹配计算耗时过长的问题,系统解析从底层C扩展加速、多级漏斗过滤、N-gram稀疏矩阵索引到局部敏感哈希(MinHash LSH)的完整性能调优与工程落地策略。
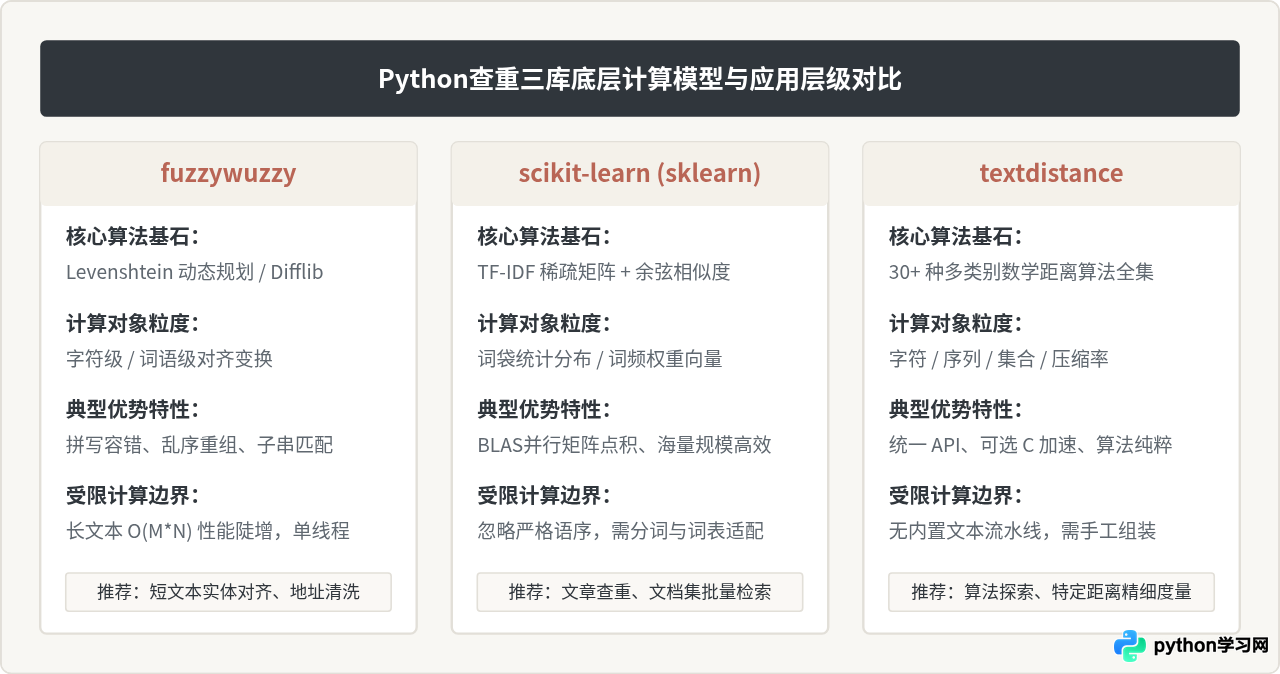
深入对比评测Python主流文本查重与相似度计算库:fuzzywuzzy、scikit-learn与textdistance。从算法原理、代码示例、计算开销到实际工程选型,帮助开发者针对短文本对齐、长文档查重与海量数据比对做出合理技术决策。
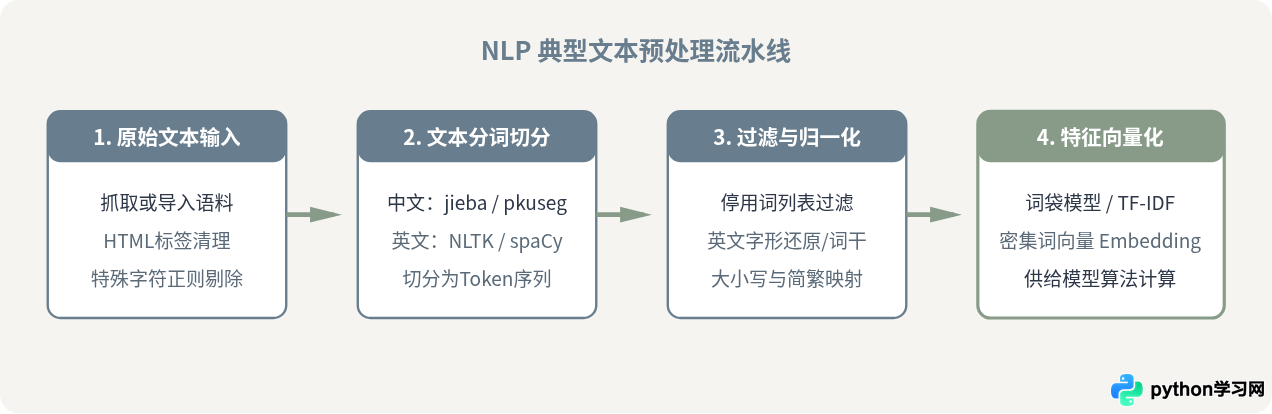
一份系统实用的Python自然语言处理(NLP)入门指南,深入讲解文本预处理、向量化特征工程、词嵌入等核心概念,并规划了三阶段进阶学习路径与代码实践。
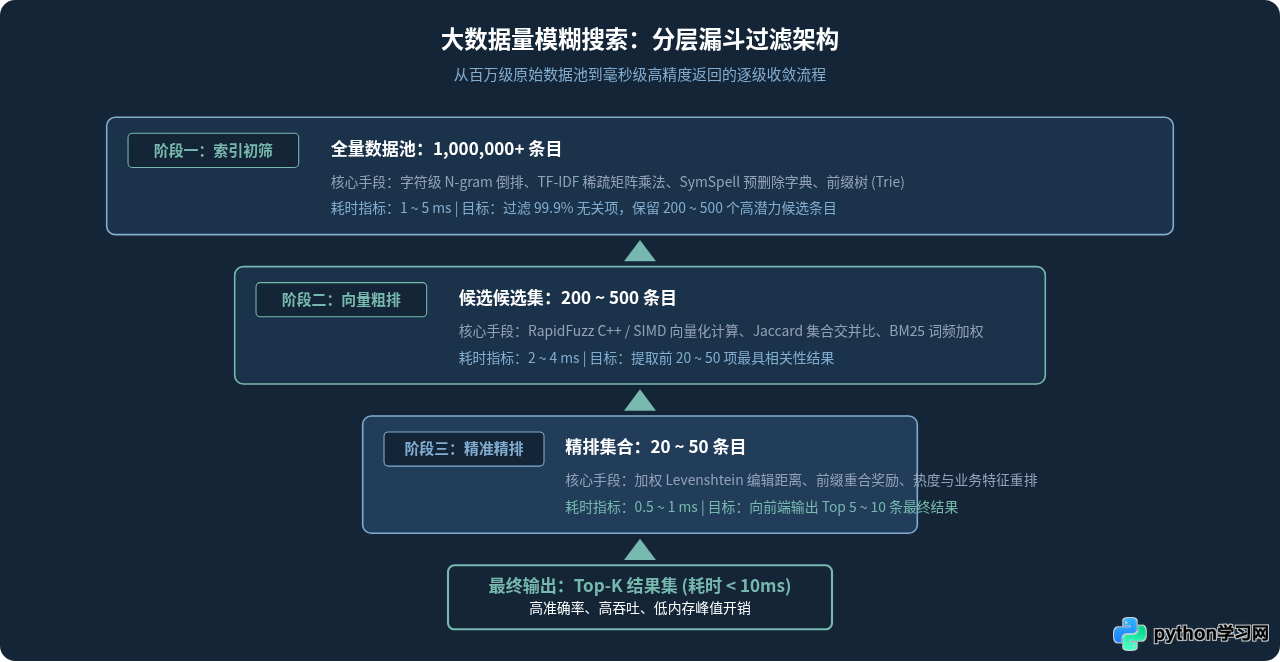
针对数十万至数千万条数据的字符串模糊搜索场景,系统介绍从全量暴力扫描到分层漏斗过滤的优化路径,涵盖底层C++加速库RapidFuzz、N-gram稀疏矩阵倒排、BK-Tree空间剪枝以及工程化落地技巧。
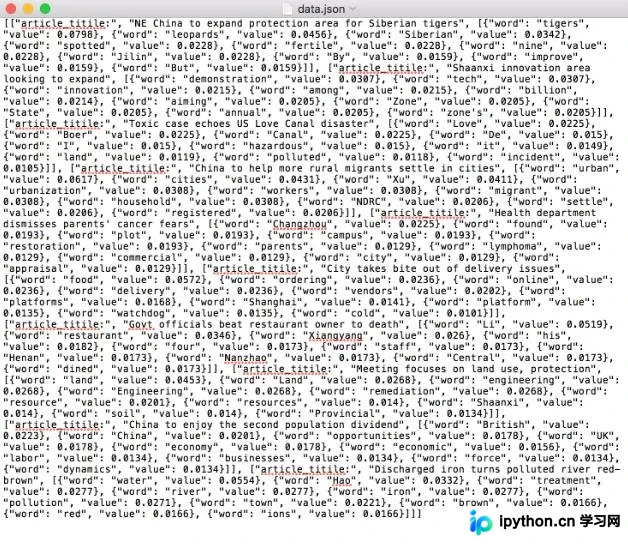
本文介绍如何使用Python编写爬虫程序,从ChinaDaily抓取十篇新闻文章。通过BeautifulSoup解析HTML获取标题与正文,结合TF-IDF算法计算每篇文章的高频关键词。最终将结果以JSON格式保存,并提供在线查看工具及GitHub源码链接,适合初学者学习网络抓取与文本分析基础。
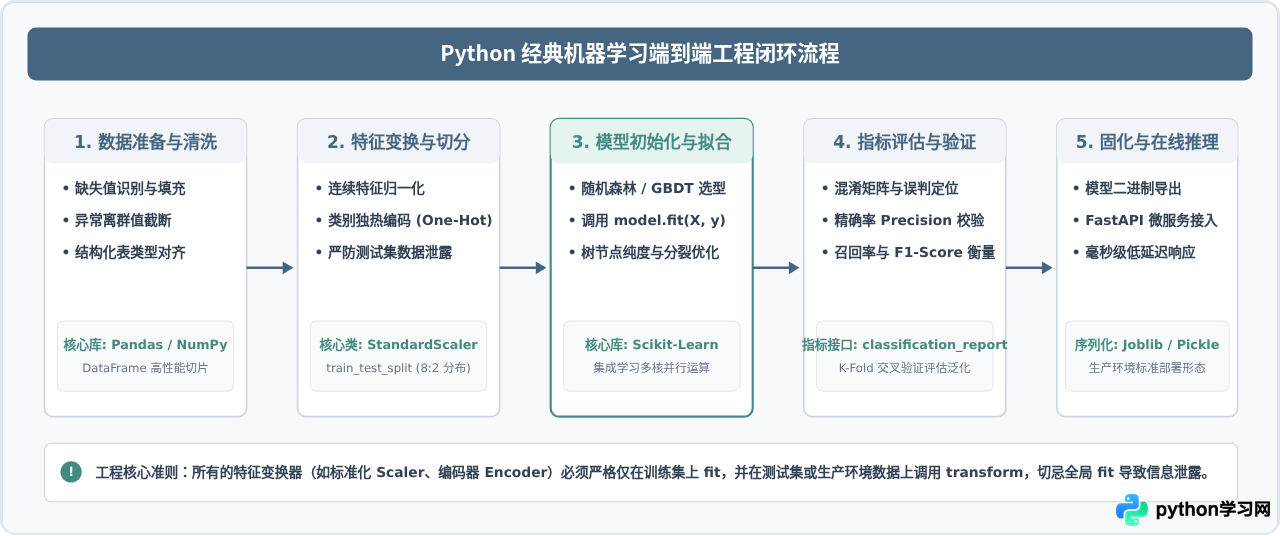
本文深入讲解Python在人工智能开发中的核心落地实践,通过基于scikit-learn的经典机器学习分类模型训练和基于TF-IDF的中文文本情感分析自然语言处理两个完整实例,系统解析数据清洗、特征工程、模型评估与流水线构建的全流程。
本文详细介绍Python中两种主流的关键词提取技术:TF-IDF与TextRank。通过解析词频-逆文档频率原理及基于图排序的TextRank算法,结合jieba库实现代码示例,对比两者在提取民营企业、贷款等关键词时的权重差异,帮助开发者根据场景选择最优方案。
本文介绍如何使用Python实现TF-IDF算法进行文本关键词提取。TF-IDF由词频(TF)和逆文档频率(IDF)组成,通过计算词频与逆文档频率的乘积来评估词语在文档中的重要性。文章详细讲解了TF-IDF的计算步骤,包括计算词频、逆文档频率以及最终的TF-IDF值,并提供了完整的Python代码实现。



